
国庆节10月1日
--

DeepSeek 是纯文本模型看不了图,用 OpenCode Go 订阅里支持视觉的 qwen3.6-plus 模型,写一个脚本 + 配一个 Skill,让 AI 编码工具自动获得图片识别能力。
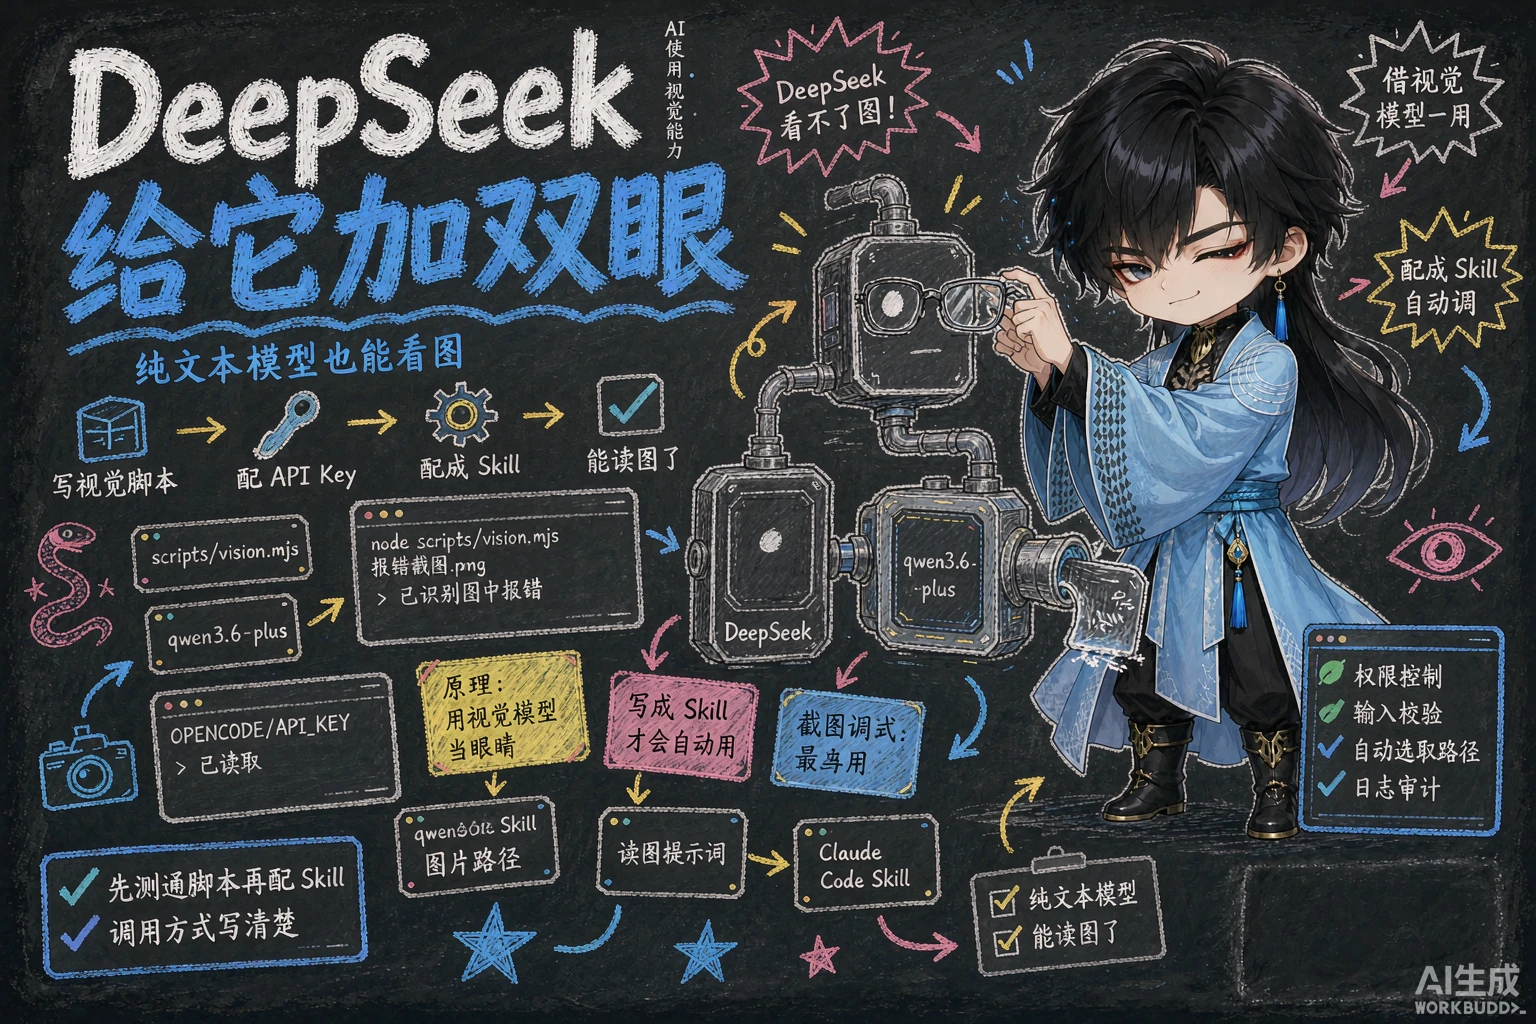
用 DeepSeek 跑 Claude Code 写代码很爽,但有个尴尬:DeepSeek 是纯文本模型,看不了图片。
发一张报错截图过去,它只会说”请描述一下图片内容”——报错截图、设计稿、流程图全都识别不了。
其实不用换模型——给 DeepSeek 外挂一个视觉能力就行:用你订阅里支持视觉的模型做”眼睛”,DeepSeek 继续做”大脑”。
这篇文章分享我的完整方案:一个脚本 + 一个 Skill,让 Claude Code 自动获得图片识别能力(实测可用)。
DeepSeek 看不了图,但 OpenCode Go 订阅里有些模型支持视觉。实测结果:
| 模型 | 图片识别 |
|---|---|
| qwen3.6-plus | ✅ 支持(实测准确) |
| minimax-m3 | ✅ 支持 |
| GLM-5.2 / MiMo / Hy3 / DeepSeek | ❌ 在 Go 上是文本版 |
所以方案是:
用户发图片 ↓Claude Code 收到图片 → 自动加载 Skill → 知道用哪个脚本 ↓vision 脚本把图片转 base64,发给 qwen3.6-plus(OpenCode Go API) ↓识别结果返回给 Claude Code,继续和 DeepSeek 配合干活DeepSeek 还是主力模型,视觉识别交给 qwen3.6-plus——各干各的。
创建一个 vision.mjs(放项目 scripts/ 目录):
// 视觉识别脚本:调用 OpenCode Go 的 qwen3.6-plus 视觉模型// 用法:node scripts/vision.mjs <图片路径或URL> [问题]import { readFileSync, existsSync } from "node:fs";import { basename, extname, join } from "node:path";
// 自动从项目 .env 读取配置function loadEnv() { const envPath = join(process.cwd(), ".env"); if (!existsSync(envPath)) return; for (const line of readFileSync(envPath, "utf8").split("\n")) { const m = line.match(/^([A-Z_]+)=(.*)$/); if (m && !process.env[m[1]]) process.env[m[1]] = m[2]; }}loadEnv();
const API_KEY = process.env.OPENCODE_API_KEY;const BASE_URL = "https://opencode.ai/zen/go/v1";const MODEL = process.env.OPENCODE_MODEL || "qwen3.6-plus";
const args = process.argv.slice(2);const imageInput = args[0];const question = args[1] || "请识别这张图片的内容,并尽可能详细地描述。";
// 图片转 base64 data URLasync function buildImageContent(input) { if (/^https?:\/\//.test(input)) { return { type: "image_url", image_url: { url: input } }; } const ext = extname(input).toLowerCase().replace(".", ""); const mime = ext === "jpg" || ext === "jpeg" ? "image/jpeg" : ext === "webp" ? "image/webp" : "image/png"; const b64 = readFileSync(input).toString("base64"); return { type: "image_url", image_url: { url: `data:${mime};base64,${b64}` } };}
const imageContent = await buildImageContent(imageInput);const res = await fetch(`${BASE_URL}/chat/completions`, { method: "POST", headers: { "Content-Type": "application/json", Authorization: `Bearer ${API_KEY}` }, body: JSON.stringify({ model: MODEL, max_tokens: 2048, messages: [{ role: "user", content: [ { type: "text", text: question }, imageContent, ], }], }),});const data = await res.json();console.log(data.choices?.[0]?.message?.content || "(无输出)");在 .env 里配置:
OPENCODE_API_KEY=你的 OpenCode Go API Keynode scripts/vision.mjs 报错截图.png "提取这个截图里的所有错误信息"能正常返回识别结果就成功了。
让 Claude Code 自动用这个脚本——不需要每次手动告诉它。在全局 skills 目录创建 image-vision/SKILL.md:
---name: image-visiondescription: 图片识别。当用户发送图片、提到图片/截图/照片内容、需要读取图片中的文字(OCR)、识别报错截图、或消息中图片显示为[Unsupported Image] 时使用。自动定位图片路径并调用视觉模型识别。---
# 图片识别(视觉模型)
## 何时使用用户发送图片/需要识别图片内容时自动触发。
## 调用方式(脚本位置固定,无需每次询问用户)node scripts/vision.mjs <图片路径> "<要识别的内容/问题>"
## 图片路径获取1. 消息里 [Image: source: <路径>] 给出的路径2. Claude 的 image-cache 目录(最近接收的图片)3. 用户明确给出的路径4. 询问用户重启 Claude Code 后,Skill 生效。之后:
你:发一张报错截图 + "看看这个"Claude Code:自动识别 → 提取错误 → 结合代码给解决方案我实际用下来:
.env(gitignore),不要提交到仓库MODEL 或环境变量 OPENCODE_MODELDeepSeek 看不了图不是硬伤——外挂一个视觉模型当”眼睛”,几行脚本 + 一个 Skill 就搞定了:
| 组件 | 作用 |
|---|---|
| vision.mjs 脚本 | 图片转 base64 → 调 qwen3.6-plus 识别 |
| .env | 存 API Key |
| image-vision Skill | 让 Claude Code 自动调用,不用手动指挥 |
实测跑通,报错截图、配置界面都能准确识别。有视觉需求的 DeepSeek 用户可以试试。
如果你喜欢,那么欢迎来到我的世界!
了解更多暂未播放

















