
国庆节10月1日
--

最近一直在折腾怎么把微信读书里的划线、笔记和书评,自然地“长”进自己的博客里——既不想手动复制粘贴丢掉上下文,也不愿让数据散落在各处变成数字孤岛。这篇文章就是我踩完坑后整理出的完整链路:从 Obsidian 用 Weread 插件自动同步读书数据,到 Astro 博客通过内容集合动态渲染成美观可交互的「阅读记录」页。整个过程不碰 API 密钥、不写爬虫、不依赖第三方服务,所有数据都在自己电脑上流转,安心又可控。
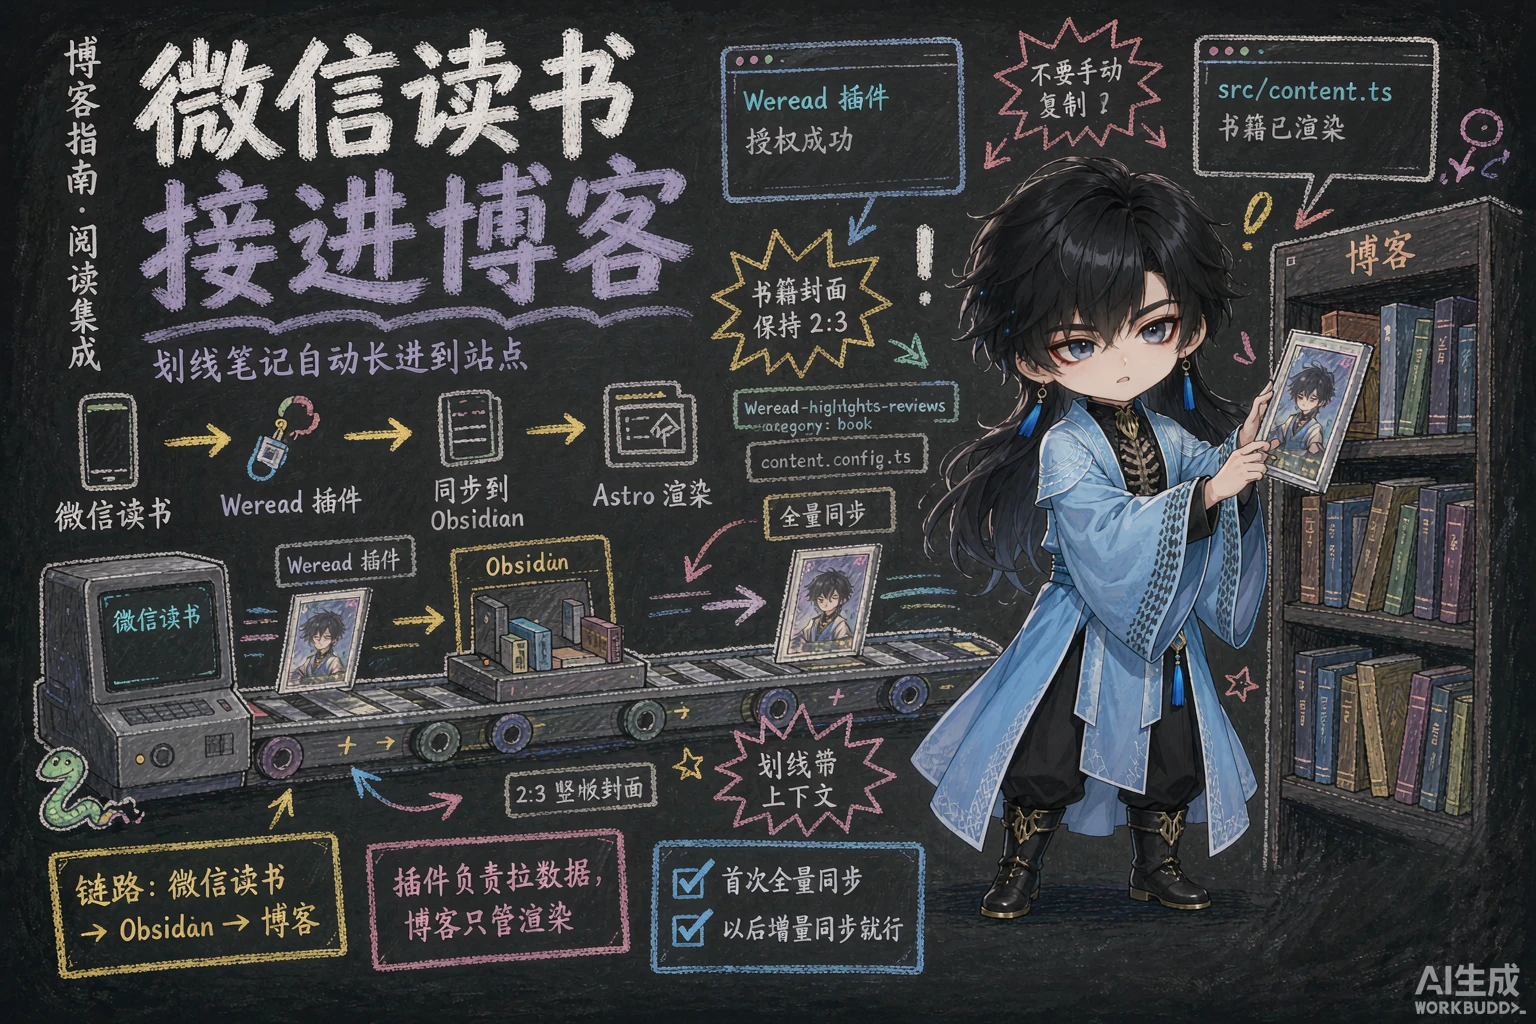
如果你同时是微信读书的重度用户和个人博客的拥有者,你一定会遇到这样的痛点:阅读笔记散落在各个平台,无法统一展示和管理。微信读书里有你的划线批注,Obsidian 里有你的知识体系,而博客是你对外展示的数字名片——如何让这三者无缝衔接?
本文将详细介绍一套完整的解决方案:利用 Obsidian Weread 插件将微信读书的书籍信息和笔记同步到本地 Obsidian,再通过 Astro 内容集合将数据自动集成到博客的「记录」页面中,最终呈现为一个美观、可交互的书籍展示模块。
阅读本文前,你需要具备以下基础:
Obsidian Weread 是由社区开发者 zhaohongxuan 开发的开源 Obsidian 插件。它的核心功能是将微信读书中的书籍元数据、高亮划线、阅读笔记和书评同步到 Obsidian 本地仓库中,以 Markdown 文件的形式存储。
| 功能 | 说明 |
|---|---|
| 书架同步 | 自动拉取微信读书书架上的所有书籍列表 |
| 高亮划线 | 同步书中所有的划线内容(热门划线 + 个人划线) |
| 阅读笔记 | 同步书中记录的个人笔记和想法 |
| 书评导入 | 同步自己和社区的热门书评 |
| 元数据提取 | 自动获取书名、作者、封面图、ISBN、出版社等信息 |
| 增量更新 | 支持增量同步,避免重复拉取已有数据 |
| 自定义模板 | 支持自定义笔记文件的命名格式和 frontmatter 模板 |
插件同步后,每本书会生成一个独立的 .md 文件,结构大致如下:
---doc_type: weread-highlights-reviewsbookId: "918483"title: 人性的弱点(卡耐基经典励志系列)author: 戴尔·卡耐基reviewCount: 3noteCount: 5cover: https://cdn.weread.qq.com/weread/cover/35/YueWen_918483/t6_YueWen_918483.jpg---
> > **书名**: 人性的弱点(卡耐基经典励志系列)> **作者**: 卡耐基
# ✍️ 高亮划线
## 第一章 与他人相处的有效方式📌 "抱怨是很愚蠢的行为..."⏱ 2025-04-26 16:27:37
# 📒 读书笔记
## 我的想法这是一本改变我人际交往观念的书...
# 🤖 本书评论这个格式非常关键——它既是 Obsidian 中的可读笔记,也是后续博客集成的基础数据源。
方法一:通过 Obsidian 社区插件市场安装(推荐)
Weread,找到 Weread 插件方法二:手动安装
# 进入你的 Obsidian 仓库插件目录cd your-vault-path/.obsidian/plugins/
# 克隆插件仓库git clone https://github.com/zhaohongxuan/obsidian-weread-plugin.git
# 安装依赖cd obsidian-weread-pluginnpm installnpm run build然后在 Obsidian 的第三方插件列表中启用它。
插件安装完成后,需要进行微信读书的账号授权:

安全提醒:你的登录凭证仅存储在本地 Obsidian 的
data.json中,不会上传到第三方服务器。插件的所有网络请求直接访问微信读书官方 API。
进入 设置 → Weread 配置页面,可以根据需求调整以下选项:
| 配置项 | 建议值 | 说明 |
|---|---|---|
| 笔记保存目录 | Weread 或自定义 | 同步后的 .md 文件存放位置 |
| 同步频率 | 手动触发 | 避免频繁请求被封 |
| 书籍文件命名 | {{title}} - {{author}} | 使用书名+作者命名 |
| 同步热门划线 | 关闭 | 只同步个人内容更精简 |
| 同步书评 | 按需开启 | 可能会拉取大量社区评论 |
| Frontmatter 模板 | 默认 | 保持 doc_type、bookId 等字段 |
配置完成后,回到 Obsidian 主界面:
Ctrl+P → 搜索 “Weread: Sync”).md 文件当你在微信读书中有新的划线或笔记后,再次点击同步按钮即可。插件会自动对比已有数据,只拉取新增或变更的内容,不会重复写入。
同步完成后,你需要将书籍文件从 Obsidian 笔记目录复制或移动到 Astro 博客的 bangumi 内容目录:
# 从 Obsidian 笔记目录your-vault/Weread/人性的弱点(卡耐基经典励志系列).md
# 移动到博客目录(按个人分类建立子目录)blog/src/content/bangumi/book/个人成长/人性的弱点.md小技巧:本项目支持将书籍文件按主题分类(如
个人成长/、心理/、文学/、精品小说/等),这些子目录会被自动识别为路径的一部分,方便管理大量书籍。
这是本文最核心的部分。我们将详细介绍如何将 Obsidian 同步的书籍数据无缝集成到博客的「记录」页面中。
┌──────────────────────────────────────────────────────┐│ ││ 微信读书 App ││ ┌────────────┐ ││ │ 划线/笔记 │ ││ │ 书评/书籍 │ ││ └─────┬──────┘ ││ │ 扫码授权 ││ ▼ ││ Obsidian Weread 插件 ◄── API 请求 ──► 微信读书服务器 ││ ┌────────────┐ ││ │ .md 文件 │ ││ └─────┬──────┘ ││ │ 文件复制 ││ ▼ ││ src/content/bangumi/book/ ││ ┌────────────┐ ││ │ book/*.md │ ◄── Astro Content Collections ││ └─────┬──────┘ ││ │ getCollection("bangumi") ││ ▼ ││ src/pages/bangumi.astro ││ ┌────────────────────┐ ││ │ 数据映射处理 │ ││ │ → UserSubjectCollection ││ └─────┬──────────────┘ ││ │ props ││ ▼ ││ src/components/pages/bangumi/ ││ ┌──────────────┐ ┌─────────────────┐ ││ │ Card.astro │ │ [...slug].astro │ ││ │ (卡片/列表) │ │ (详情页) │ ││ └──────────────┘ └─────────────────┘ ││ │└──────────────────────────────────────────────────────┘首先,在 src/content.config.ts 中定义 bangumi 内容集合的 Schema。这是整个系统的数据结构基础:
const bangumiCollection = defineCollection({ loader: glob({ pattern: "**/*.{md,mdx,yaml,yml}", base: "./src/content/bangumi", }), schema: ({ image }) => z.object({ title: z.string(), // 书名 name_cn: z.string().optional(), // 简短显示名 category: z.enum(["book", "anime", "music", "game", "real"]).default("anime"), status: z.number().min(1).max(5).default(2), // 1:想看 2:看过 3:在看 4:搁置 5:抛弃 image: image().or(z.string()), // 封面图 link: z.string().optional(), // 自定义链接(可选) score: z.number().min(0).max(10).optional(), // 评分 0-10 comment: z.string().optional(), // 一句话评价 tags: z.array(z.string()).optional().default([]), // 标签 published: z.date().optional(), // 发布日期 }),});设计要点:
link 字段为可选——如果未提供,系统会自动从文件路径推导(后文会详细说明)category 使用枚举限制,确保数据一致性image 接受 Astro 优化的图片对象或纯 URL 字符串score 采用 0-10 分制(符合番组计划评分标准)status 数字映射——1 想看 / 2 看过 / 3 在看 / 4 搁置 / 5 抛弃每个书籍的 .md 文件需要包含以下 frontmatter 字段,以 人性的弱点 为例:
---doc_type: weread-highlights-reviews # Weread 插件标注bookId: "918483" # 微信读书书籍IDtitle: 人性的弱点(卡耐基经典励志系列)reviewCount: 3noteCount: 5category: book # 类别:bookstatus: 2 # 状态:看过image: https://cdn.weread.qq.com/weread/cover/35/YueWen_918483/t6_YueWen_918483.jpgtags: - 个人成长-沟通表达 - 卡耐基published: 2026-05-10---注意:
category: book是必需的,否则书籍不会出现在「书籍」标签页中。title字段决定了详情页 URL 的路径来源。
在 src/pages/bangumi.astro 中,核心的数据处理流程如下:
---import { getCollection } from "astro:content";import { removeFileExtension } from "@/utils/url-utils";
const customBangumi = await getCollection("bangumi");const allPosts = await getCollection("posts");
const categoryMap = { book: { id: "book", name: "书籍", subjectType: 1 }, anime: { id: "anime", name: "影视", subjectType: 2 }, music: { id: "music", name: "音乐", subjectType: 3 }, game: { id: "game", name: "游戏", subjectType: 4 },};
const mappedData = customBangumi.map((item) => { const { data } = item; const categoryInfo = categoryMap[data.category];
// 链接自动生成逻辑 let rawLink = (data.link || "").trim(); if (!rawLink) { // 无自定义链接时,从文件路径自动推导 const entrySlug = removeFileExtension(item.id); rawLink = `/bangumi/${entrySlug}/`; }
// 检查是否匹配某篇博客文章 let finalLink = rawLink; const matchingPost = allPosts.find((p) => { // ... 匹配逻辑 ... }); if (matchingPost) { finalLink = `/posts/${matchingPostSlug}/`; }
return { subject_type: categoryInfo.subjectType, rate: data.score || 0, type: data.status, comment: data.comment || null, tags: data.tags || [], link: finalLink, subject: { name: data.title, name_cn: data.name_cn || data.title, images: { medium: typeof data.image === "string" ? data.image : data.image.src, // ... 其他尺寸 }, score: data.score || 0, }, };});---自动链接生成的巧妙之处:
item.id 是 Astro 内容集合自动生成的 ID,反映了文件在 src/content/bangumi/ 下的相对路径removeFileExtension() 去除 .md 后缀后,直接拼接为 /bangumi/{path}/book/个人成长/人性的弱点 → /bangumi/book/个人成长/人性的弱点/[...slug].astro catch-all 路由生成的路径完全一致书籍在列表页中呈现为「番组计划」风格的卡片,代码位于 src/components/pages/bangumi/Card.astro:
---const { item } = Astro.props;const link = item.link || `${subject_base_url}${item.subject.id}`;const subType = item.subject_type;const title = item.subject.name_cn || item.subject.name;---
<a href={link} target={item.link ? "_self" : "_blank"} class="bm-card group" data-type={subType}> <div class="bm-cover"> <img src={item.subject?.images?.medium || ""} alt={title} class="bm-img" loading="lazy" />
<!-- 底部渐变遮罩 --> <div class="bm-gradient" />
<!-- 左上:阅读状态 --> <span class="bm-status bg-emerald-500/80">看过</span>
<!-- 右上:评分 --> <span class="bm-score"> <svg>★</svg> 9 </span>
<!-- 底部文字叠层 --> <div class="bm-info"> <h3 class="bm-title">人性的弱点</h3> <div class="bm-tags"> <span class="bm-tag">个人成长</span> <span class="bm-tag">卡耐基</span> </div> </div>
<!-- 悬停评论遮罩 --> <div class="bm-overlay"> <p class="bm-comment">人际交往的永恒经典</p> </div> </div></a>CSS 设计要点:
/* 书籍保持 2:3 竖版封面(与电影海报一致) */.bm-cover { aspect-ratio: 2/3;}
/* 游戏使用 3:2 横向比例 */.bm-card[data-type="4"] .bm-cover { aspect-ratio: 3/2;}
/* 音乐使用 1:1 正方形比例 */.bm-card[data-type="3"] .bm-cover { aspect-ratio: 1/1;}
/* 悬停时封面微缩放 */.bm-card:hover .bm-img { transform: scale(1.06);}
/* 悬停时显示评论遮罩 */.bm-card:hover .bm-overlay { opacity: 1;}交互细节:
| 交互 | 效果 |
|---|---|
| 鼠标悬停 | 卡片上浮 3px + 主色边框光晕 |
| 封面悬停 | 图片缓慢放大 6% |
| 评论遮罩 | 从透明渐显,仅在有 comment 时显示 |
| 点击卡片 | 跳转到该书的详情页 |
详情页使用 Astro 的动态路由 [...slug].astro 来匹配所有 bangumi 条目:
---import { getCollection, render } from "astro:content";import { removeFileExtension } from "@/utils/url-utils";
export async function getStaticPaths() { const bangumiEntries = await getCollection("bangumi"); return bangumiEntries.map((entry) => ({ params: { slug: removeFileExtension(entry.id) }, props: { entry }, }));}
const { entry } = Astro.props;const { Content, headings } = await render(entry);---
<MainGridLayout title={entry.data.title} headings={headings}> <div class="card-base"> <h1>{entry.data.title}</h1> <!-- 元数据:发布日期、分类、评分、状态 --> <div class="post-meta"> <span>评分: ⭐⭐⭐⭐ 9/10</span> <span>分类: 书籍</span> <span>状态: 看过</span> </div>
<!-- 渲染书籍 markdown 正文 --> <Markdown> <Content /> </Markdown> </div></MainGridLayout>详情页完整展示了书籍的所有信息:封面 banner、元数据栏(评分/分类/状态/日期)、一句话评价引用块、标签列表,以及使用 render() 渲染的 Markdown 正文(包含高亮划线和读书笔记)。
以《人性的弱点》为例,以下是完整的数据流展示:
微信读书中的划线:
“在30年前我就已经明白,抱怨是很愚蠢的行为。我从不埋怨上帝对智慧的分配不均。”
Obsidian 中的 Markdown 文件:
## 与他人相处的有效方式📌 "...抱怨是很愚蠢的行为..."⏱ 2025-04-26 16:27:37博客中的展示效果:
博客的书籍详情页会以结构化方式呈现所有高亮划线,按章节分组,每条划线下方显示添加时间。页面使用 Firefly 主题的原生 Markdown 渲染,支持深色/浅色模式。
在博客的「记录」页面(/bangumi/),点击顶部 📚 书籍 标签,即可看到所有已读和在读的书籍卡片。每张卡片以书籍封面为主体,底部叠层显示书名和标签,左上角标注阅读状态,右上角展示评分。
点击任意书籍卡片,即可进入该书详情页,查看完整的高亮划线、阅读笔记和书评内容。
从微信读书读完一本书到博客展示,完整流程如下:
src/content/bangumi/book/分类名称/书名.mdcategory: bookstatus: 2 # 1:想看 2:看过 3:在看tags: [标签1, 标签2]published: 2026-05-10score: 9comment: 一句话评价提示:不需要手动添加
link字段!系统会从文件路径自动推导跳转链接。
| 优势 | 说明 |
|---|---|
| 一次配置,长期受益 | 插件和博客集成配置完成后,新增书籍只需补充几行 frontmatter |
| 数据完全自主可控 | 所有数据以 Markdown 文件存储在你的本地仓库中,不依赖任何第三方服务 |
| 链接零配置 | 系统自动从文件路径推导跳转链接,无需手动维护 URL |
| 主题原生适配 | 利用 Firefly 主题的 Markdown 渲染和暗黑模式,无需额外前端开发 |
| 可扩展性强 | 基于 Astro Content Collections 架构,可轻松扩展到影视、游戏、音乐等品类 |
自动补全 Frontmatter:编写脚本自动为同步后的文件添加 category、status 等字段,减少手动操作
Obsidian Callout 渲染:同步后的笔记中可能包含 Obsidian 风格的多类型 callout(如 > [!tip]、> [!warning]),可以通过 marked 扩展或自定义渲染器来呈现更丰富的视觉效果
阅读进度追踪:在卡片或详情页显示阅读进度百分比(基于微信读书的阅读数据)
批量操作脚本:开发 Node.js 脚本,一键将 Obsidian 中所有 Weread 书籍迁移到博客目录,并自动添加必要的 frontmatter
API 自动同步:如果微信读书开放了更完善的 API,可以考虑在博客构建时直接从微信读书拉取最新数据,完全省去手动同步步骤
阅读统计可视化:基于书籍数据和笔记数量,在博客中生成阅读热力图、年度阅读总结等可视化图表
通过 Obsidian Weread 插件 + Astro Content Collections 的组合方案,我们成功打通了「微信读书 → Obsidian → 博客」的数据链路。你只需要在手机上阅读、划线和写想法,剩下的同步和展示工作全部自动化完成。
这套方案的价值不在于技术有多复杂,而在于它真正解决了「阅读输入 → 笔记沉淀 → 知识输出」的完整闭环。希望这篇文章能帮助同样热爱阅读和写作的你,建立属于自己的数字阅读档案馆。
如果你对这个方案有任何疑问或改进建议,欢迎在评论区交流!
如果你喜欢,那么欢迎来到我的世界!
了解更多暂未播放

















