国庆节10月1日
--
给 AstrBot BlogWriter 插件加了一条 /转载 命令——把公众号文章链接发过去,插件自动抓取正文、转存图片、生成博客文章并提交,全程一条命令。
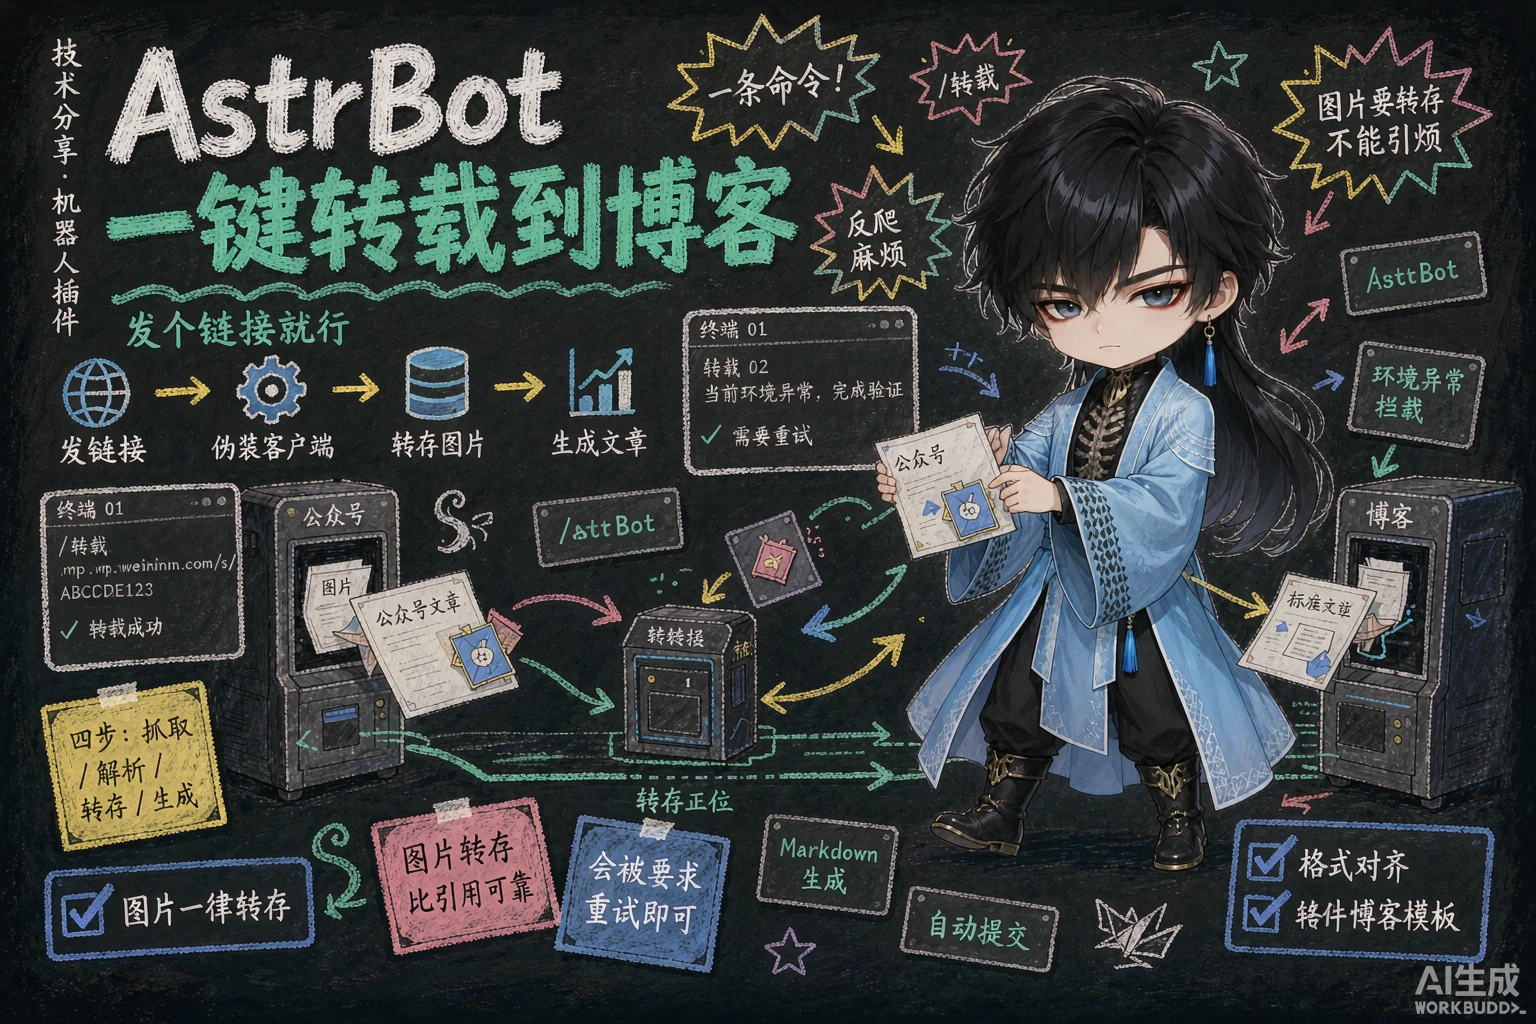
看到好文章想收藏到自己博客,以前只能手动复制粘贴、一张张存图,现在一条命令搞定。
平时刷公众号经常看到想收藏的文章,比如九边那种聊教育、聊习惯的长文。以前想转载到博客,流程是这样的:
一篇文章折腾十几分钟,图片多的更麻烦,而且公众号图片有防盗链,直接引用原图链接哪天就可能全部挂掉。
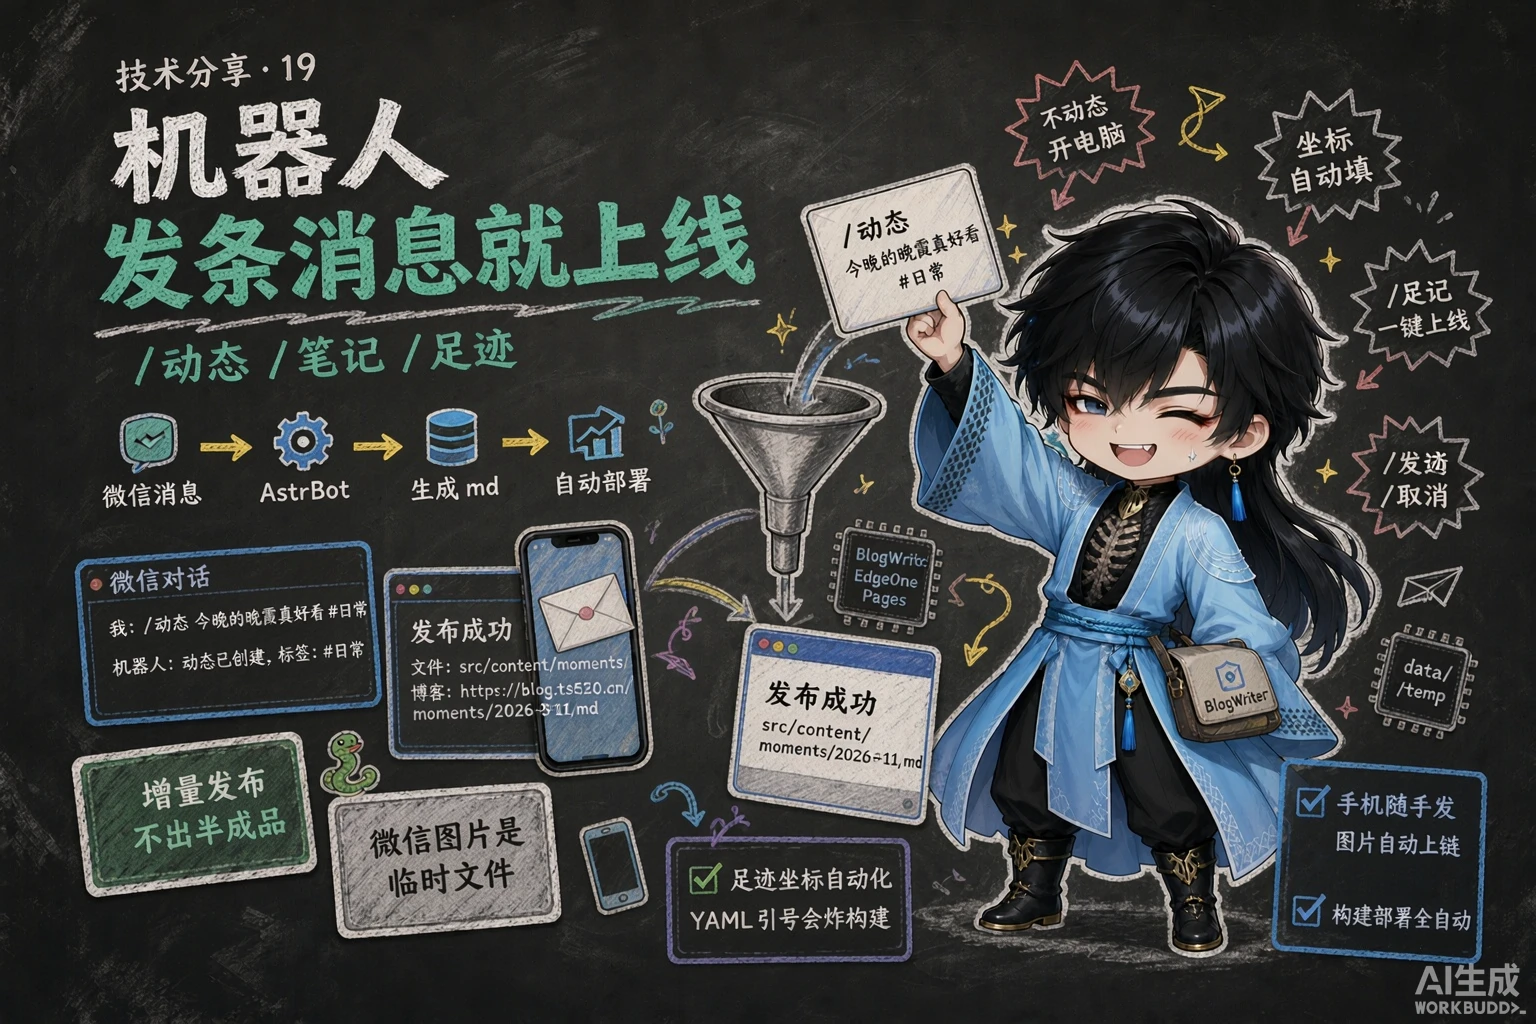
我博客本来就有个 AstrBot 插件(BlogWriter),平时用微信/QQ 发消息就能发动态、写笔记、记账。干脆给它加了条新命令:
/转载 https://mp.weixin.qq.com/s/xxxx发出去之后什么都不用管,刷新博客文章就出现了。
在 QQ 私聊里把公众号文章链接发过去,回复大致长这样:
转载成功 ✅
标题:超强自驱力是哪来的公众号:九边文件:src/content/posts/技术分享/超强自驱力是哪来的.md博客:https://blog.tsh520.cn/posts/技术分享/超强自驱力是哪来的生成的文章长这样:
---title: 超强自驱力是哪来的published: 2026-09-16description: 这篇文章之前发在小号"六镇",尾部流量非常大……image: https://img.tsh520.cn/file/blog/article/article-1.jpgtags: - 转载sourceLink: https://mp.weixin.qq.com/s/_0CXcOf250uUhy1304rG3w---
> 本文转载自微信公众号「九边」(原文发布于 2026-07-31)> 原文链接:https://mp.weixin.qq.com/s/_0CXcOf250uUhy1304rG3w
(正文,图片全部替换成了自己图床的链接)正文段落、加粗、引用、列表都保留,图片全部转存到了自己的 CloudFlare-ImgBed 图床(blog/article 目录),微信那边就算删文删图也不影响。
公众号文章对服务器 IP 是有风控的。我一开始用普通请求去抓,直接被挡:
当前环境异常,完成验证后即可继续访问解决办法是把自己伪装成手机微信:User-Agent 用 MicroMessenger 的,再带上 Referer: https://mp.weixin.qq.com/。插件里做了两层处理——先按正常请求抓,如果返回的页面里检测到「环境异常/完成验证」的关键词,就直接报错告诉我是被风控了,而不是生成一篇乱七八糟的文章。
这是整个功能里最花时间的部分。我原以为公众号正文就是普通的 <p> 段落,实际抓下来发现完全不是:
1. 段落是靠 <section> 分隔的。
正文里几乎没有 <p> 标签,每段文字包在一个 <section><span leaf="">文字</span></section> 里,样式全写在行内 style 属性上。这意味着如果按 <p> 来断段,整篇文章会被拼成一大坨,一行到底。
2. 正文容器的结束位置没有明显的闭合标志。
<div id="js_content"> 里面嵌套几十层,靠正则配对 </div> 根本不现实。我的做法是找边界标志——正文本体之后第一个 <script> 标签出现的位置,就是正文的截止线。实测这个办法非常稳定,正文一个字不多一个字不少。
3. 页面里混着一堆非正文图片。
页面底部有二维码、作者头像之类的 <img>,如果不过滤,会把公众号头像也转存进文章里。解决办法是按 class 名过滤(qr_code、jump_author_avatar 这些),正文图只认 data-src(微信的懒加载写法)。
4. 发布日期藏在 JS 变量里。
页面上没有可见的日期元素,日期实际在脚本里的 var ct = "1785463020" 这个时间戳里,转一下就是原文发布日期。
5. 摘要经常是空的。
description 这个 meta 标签很多文章是空的,所以做了一个兜底:取正文开头 60 个字当摘要。
公众号图片域名是 mmbiz.qpic.cn,直接引用有两个问题:一是微信可能删图,二是防盗链规则随时会变。所以插件的做法是:
blog/article 目录任一图片下载或上传失败,整个转载就会中止——不会发布一篇一半图片挂掉的半成品文章。
frontmatter 按博客 posts 集合的 schema 来写:
| 字段 | 内容 |
|---|---|
| title | 文章标题(自动抓取) |
| published | 转载日期 |
| description | 原文摘要(没有就取正文开头) |
| image | 第一张图当封面 |
| tags | 默认「转载」,可在插件配置里改 |
| sourceLink | 原文链接,博客文章页会展示 |
正文开头自动加一段转载声明引用块:
> 本文转载自微信公众号「九边」(原文发布于 2026-07-31)> 原文链接:https://mp.weixin.qq.com/s/xxxx文章放到哪个目录(也就是博客的分类)可以在插件配置里固定,我默认放在 技术分享。
| 配置项 | 说明 | 默认值 |
|---|---|---|
| article_default_dir | 转载文章发布目录 | 技术分享 |
| article_upload_folder | 图片转存图床目录 | blog/article |
| article_tags | 文章默认标签 | ["转载"] |
mp.weixin.qq.com 的,其他网站暂不支持。这个功能本质上是一次「网页转 Markdown」的工程实践,难点不在写代码,而在摸清公众号页面真实的 DOM 结构——<section> 分段、<script> 边界、data-src 懒加载这些,都是抓下来看了真页面才发现的。
现在看到好文章,发个链接就归档到自己博客了,还能顺手留个原文出处,比收藏夹靠谱多了。
暂未播放