Xpath语法
Xpath语法


Xpath 常用表达式速查:路径、序号、last()、属性过滤、通配符与 text(),配合 lxml 使用
Xpath 是什么
Xpath:一种在 HTML/XML 文档中导航或定位元素的查询语言,让你能够准确地定位文档中的特定元素、属性或文本。
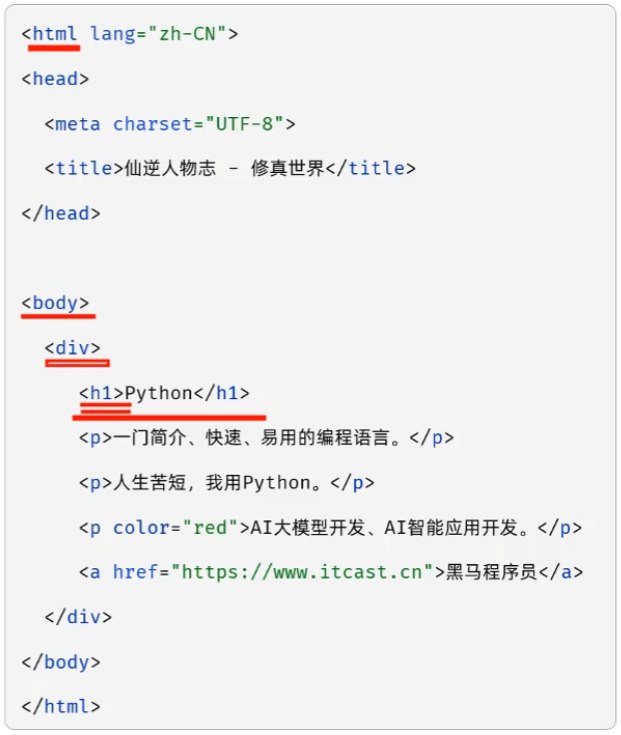
下面这份简化 HTML 是本篇所有表达式的练兵场:
<html><head><title>仙逆人物志 - 修真世界</title></head><body> <div> <h1>Python</h1> <p>一门简介、快速、易用的编程语言。</p> <p>人生苦短,我用Python。</p> <p color="red">AI大模型开发、AI智能应用开发。</p> <a href="https://www.itcast.cn">黑马程序员</a> </div></body></html>常用表达式速查表
| 表达式 | 描述 | 样例 |
|---|---|---|
/ | 从根节点的直接子元素 | /html/body/div/h1 |
// | 从任意位置选择节点 | //h1 |
. | 当前节点下查找 | ./a 与 .//a |
[n] | 选择第 n 个元素 | //p[2] |
[last()] | 选择最后一个元素 | //p[last()] |
[@attr] | 选择有该属性的元素 | //p[@color] |
[@attr='value'] | 选择该属性值等于指定值的元素 | //p[@color='red'] |
* | 匹配任何元素节点 | //body/div/* |
@* | 匹配元素的任何属性 | //body/div/a/@* |
text() | 获取文本内容 | //div/p/text() |
 |
配合 lxml 使用
from lxml import html
with open("resources/仙逆人物志.html", "r", encoding="utf-8") as f: html_text = f.read() document = html.fromstring(html_text)
th_list = document.xpath("//thead/tr/th/text()") # // : 任意位置开始 print(th_list)
td_list = document.xpath("//tbody/tr[2]/td/text()") # [2] : 第 2 个 tr print(td_list)
td_list = document.xpath("//tbody/tr[last()-1]/td/text()") # last()-1 : 倒数第 2 个 print(td_list)
p_list = document.xpath("//p[@class]/text()") # 有 class 属性的 p print(p_list)
p_list = document.xpath("//p[@class='xn']/text()") # class 恰好等于 xn 的 p print(p_list)
th_list = document.xpath("//thead/tr/*/text()") # * : 任意标签 print(th_list)
a_list = document.xpath("//td/img/@*") # @* : 任意属性(如 src) print(a_list)Tip
取属性值的写法是去掉 text()、直接写属性名://td/img/@src(取图片地址),//div/a/@href(取链接地址)。
相关
练习题
一、回忆填空(写完再展开对答案)
- 从根节点的直接子元素开始找,用 ____;从任意位置选择节点,用 ____
- 在当前节点下查找,用 ____;选择第 n 个元素用 ____;选最后一个用 ____
- 选择有 class 属性的元素:
//p[____];class 值等于 xn 的://p[____] - 匹配任何元素节点的通配符是 ____;匹配任何属性的是 ____
- 取元素的文本内容用 ____;取元素的 href 属性用 ____
//tbody/tr[last()-1]里的last()-1表示 ____
填空答案(做完再点开)
/、//2..、[n]、[last()]3.@class、@class='xn'4.*、@*5.text()、@href6. 倒数第二个
二、裸写题
对着 resources/仙逆人物 志.html(或本篇开头的简化 HTML)写出 Xpath 表达式:
- 2-1 取
<h1>的文本 - 2-2 取链接
<a>的 href 属性值 - 2-3 取”有 target 属性且值为 _blank”的
<a>的文本 - 2-4 取第二个
<div>里最后一个<p>的文本
参考答案(做完再点开)
2-1 //h1/text() (或 /html/body/div/h1/text())2-2 //a/@href2-3 //a[@target='_blank']/text()2-4 //div[2]/p[last()]/text()评论区
[ 标签 ]
[ 分类 ]
[ 公告 ]
如果你喜欢,那么欢迎来到我的世界!
了解更多[ 音乐 ]
音乐
暂未播放
0:000:00
找不到相关结果。
[ contents ]
[ 全部文章 ]