
国庆节10月1日
--

第 6 章下半场的第三篇(PPT 第 25-29 页),专门解决上一节留下的"资源浪费、性能降低"两个痛点。先讲清连接池是什么(分配、管理 Connection 的容器)与它的两条机制(复用现有连接而不重建、回收空闲超时的连接),再讲 sun 给出的标准接口 DataSource 和四种常见产品(C3P0、DBCP、Druid、Hikari),最后用本机实测的运行时类名对照表证明"不动配置就是 Hikari,加一个 starter 依赖加一行 type 就切到 Druid"
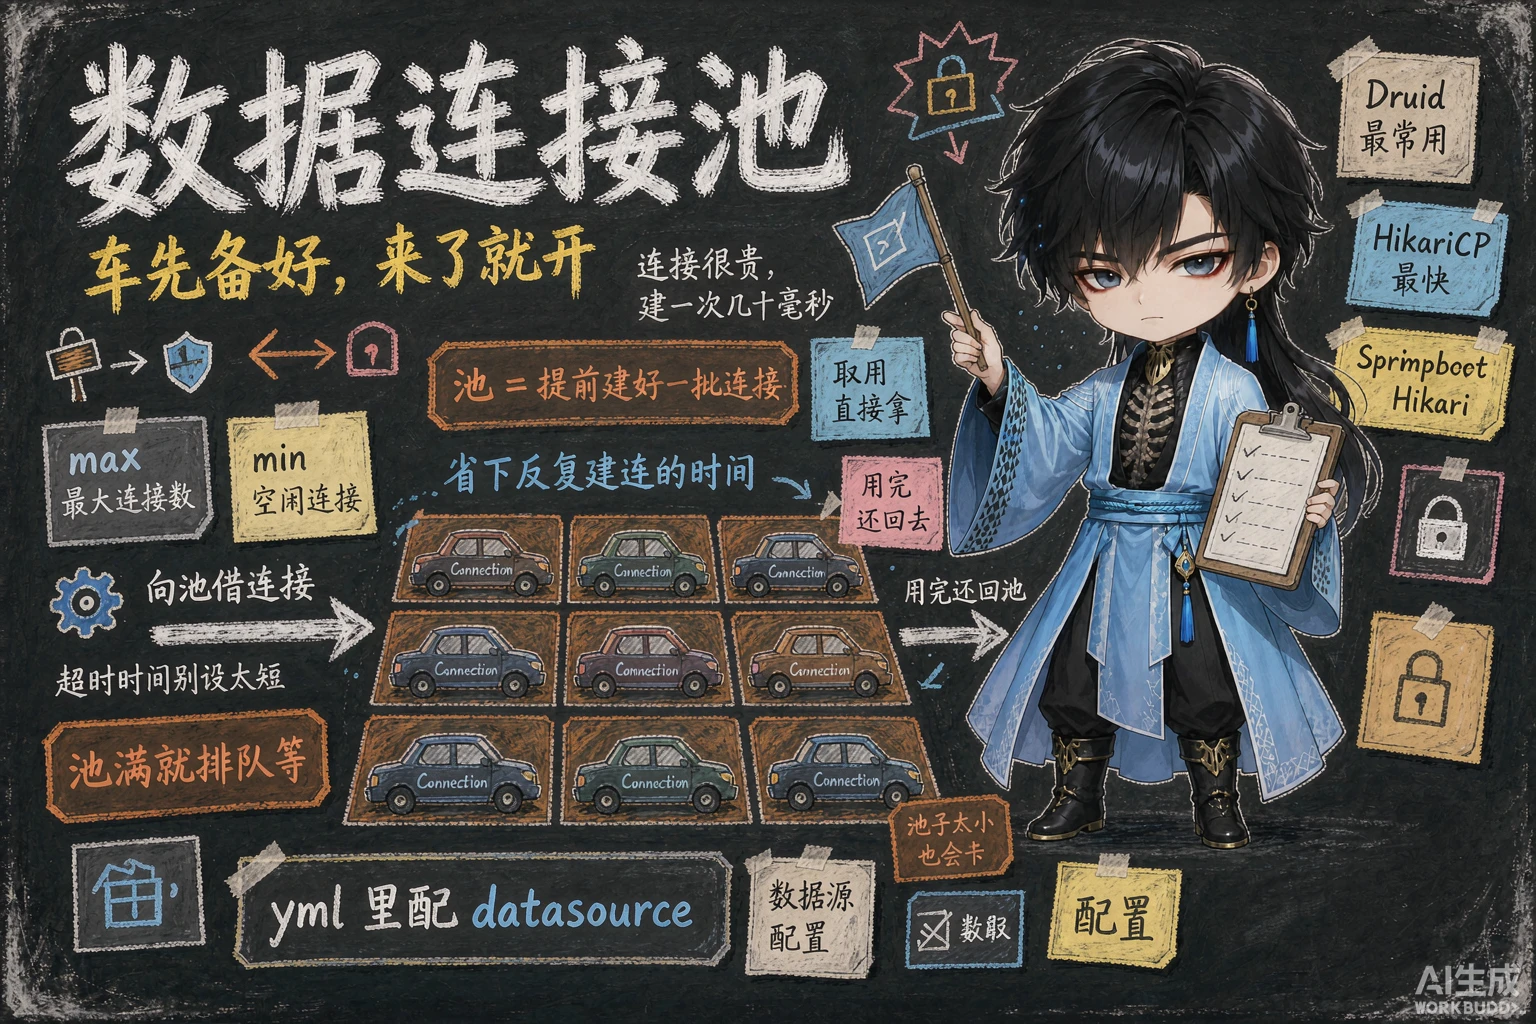
52 篇把 JDBC 的四个痛点摆上了台面,并且划了责任:硬编码、繁琐这两条归 MyBatis 管(51 篇已经治好),剩下的资源浪费、性能降低两条——MyBatis 一个人治不完,得请这一节的主角出场。
本篇对应 PPT 第 25-29 页,讲的是”连接”这个资源该由谁管:什么是数据库连接池(第 26 页)、它的标准接口与常见产品(第 27 页)、怎么把项目里的连接池换成 Druid(第 28 页)。
本机实测环境:MySQL 9.0.1(课程用 8.0.34),库 web01、表 user(5 条数据)。连接信息沿用课程原样(root / password=1234),自己动手时把 password 换成你自己 MySQL 的密码。
PPT 第 25 页又是那张熟悉的菜单:Mybatis 入门程序 / JDBC VS Mybatis / 数据库连接池 / 增删改查操作 / XML映射配置,这次高亮的是第三格——数据库连接池。
它在路线上的位置很讲究:前一节刚说完 JDBC”每次新建连接、用完就丢”是浪费,这一节立刻回答”那该怎么管”;而它讲完,下一篇就回到 MyBatis 继续讲增删改查(54 篇)——因为连接池属于底层基础设施,配好一次就一劳永逸,不用每写一个查询都想它。
PPT 第 26 页的三句原文是这一节的骨架:
数据库连接池是个容器,负责分配、管理数据库连接(Connection)。
它允许应用程序重复使用一个现有的数据库连接,而不是再重新建立一个。
释放空闲时间超过最大空闲时间的连接,来避免因为没有释放连接而引起的数据库连接遗漏。
PPT 第 26 页的示意图画的是这样一条链路(这一节 PPT 没有可提取的截图,用文字把它的结构复述出来):
应用程序 ──SQL──→ 数据库连接池 ──→ 数据库 (连接在这里借 / 还)把它想成一个**“连接出租店”**就很好理解:
| 优势(PPT 原文) | 为什么成立 |
|---|---|
| 资源重用 | 连接建好就留在池子里反复借还,不再”每次新建、用完即弃”,创建与销毁连接的开销被摊薄 |
| 提升系统响应速度 | 建立一条数据库连接本身要花时间(TCP 连接 + 认证等),走连接池就是省掉这段等待,拿到连接即可执行 SQL |
| 避免数据库连接遗漏 | 池子会回收空闲超时的连接——即使某段代码忘记归还,也不会把连接永久地”漏”在外面 |
连接池不是 JDBC 之外的另一个技术,它是对 Connection 这个资源的分发管理。你从池子里拿到的依然是 JDBC 的 Connection(本机实测里它的实现类是 MySQL 驱动提供的 com.mysql.cj.jdbc.ConnectionImpl),只是”创建”和”关闭”的动作被池子接管了——close() 在池子里的含义变成了”还回去”。
这一条正好把 52 篇 JDBC 版代码里那两句救活了:以前 connection.close() 是真关掉(下次重新建),现在它只是把连接还回池子(下次直接用)。
连接池该建多少条连接、最多允许多少条、借不到时最多等多久——这些属于连接池的参数配置(本课不展开)。知道有这回事即可:Druid 的 starter 支持 spring.datasource.druid.* 一系列配置项,将来需要压测调优时去查官方文档。
PPT 第 27 页把”接口”和”产品”分得很清楚:
标准接口:DataSource 官方(sun)提供的数据库连接池接口,由第三方组织实现此接口。 功能:获取连接
这句话是不是很眼熟?49 篇讲 JDBC 时出现过同一套路数:
| JDBC 那套 | 连接池这套 | |
|---|---|---|
| 谁定接口 | sun 官方(Connection、Statement、ResultSet…) | sun 官方(DataSource) |
| 谁做实现 | 各数据库厂商(MySQL、Oracle…)提供驱动 jar | 第三方组织提供连接池产品 |
| 我们怎么用 | 面向 JDBC 接口编程,真正执行的是驱动里的实现类 | 面向 DataSource 接口编程,真正干活的是某个连接池的实现类 |
DataSource 的功能就一句话:获取连接(dataSource.getConnection())。因为大家实现的都是同一个接口,所以换连接池产品只需要换实现类——这正是下面”切换 Druid 只改一行配置”能成立的原因。
PPT 第 27 页给出的常见产品有四个:
| 产品 | 说明 |
|---|---|
| C3P0 | 老牌连接池 |
| DBCP | Apache 出品的老牌连接池 |
| Druid(德鲁伊) | 阿里巴巴开源的数据库连接池项目——“功能强大,性能优秀,是Java语言最好的数据库连接池之一”(PPT 原文) |
| Hikari | SpringBoot 默认使用的连接池 |
注意最后一个词——Hikari 是 SpringBoot 的默认值。这件事有两层含义:① 你可能早就在用连接池了却不知道(51 篇那份工程没配过任何连接池,实际跑的就是 Hikari);② 如果你的项目没有明确配 spring.datasource.type,别以为”没用连接池”。本机实测会把这一点直接打印出来。
课程选择 Druid 作为演示对象,切换动作只有两步。
第一步:加依赖(pom.xml)
<!-- Druid连接池 --><dependency> <groupId>com.alibaba</groupId> <artifactId>druid-spring-boot-starter</artifactId> <version>1.2.19</version></dependency>第二步:在配置文件里指定用哪个实现类(application.properties,PPT 第 28 页原文)
spring.datasource.type=com.alibaba.druid.pool.DruidDataSourcespring.datasource.url=jdbc:mysql://localhost:3306/web01spring.datasource.driver-class-name=com.mysql.cj.jdbc.Driverspring.datasource.username=rootspring.datasource.password=1234也就是在原来那四行上面加一行 spring.datasource.type,值就是 Druid 连接池实现类的全限定类名。
课程另一个工程(springboot-mybatis-quickstart)用的是 yml 写法,同样这一行配置长这样:
spring: datasource: type: com.alibaba.druid.pool.DruidDataSource url: jdbc:mysql://localhost:3306/web01 driver-class-name: com.mysql.cj.jdbc.Driver username: root password: 1234两种写法的功能完全等价(56 篇会专门用实测证明),换的是”格式”不是”内容”。
配置写没写对,光看代码看不出来——最硬的证据是问运行时”你手里那个连接池对象是什么类”。
本机实测的做法:写一个测试类注入 DataSource,打印它和它给出的连接对象的类名(dataSource.getClass().getName()、dataSource.getConnection().getClass().getName()),在课程的两个工程里各跑一次:
| 工程 | 配置 | 运行时 dataSource.getClass().getName() |
|---|---|---|
springboot-mybatis-quickstart(yml) | 配了 spring.datasource.type: com.alibaba.druid.pool.DruidDataSource | com.alibaba.druid.pool.DruidDataSource |
aliyun-mybatis-quickstart(properties) | 没配 type | com.zaxxer.hikari.HikariDataSource(SpringBoot 默认) |
两个工程里取出来的连接对象则都是 com.mysql.cj.jdbc.ConnectionImpl(MySQL 驱动自己的实现类)——不管池子是谁家的,池子里装的连接都是数据库驱动造的。
结论(两条都实测过):
aliyun-mybatis-quickstart 里一行连接池配置都没有,运行起来照样拿到 HikariDataSource;druid-spring-boot-starter 依赖 + 一行 spring.datasource.type,就切成 DruidDataSource——容器里那个对象的类名实打实地变了。对照着 52 篇的痛点表看,这一节的收益就落地了:
| 痛点 | 连接池怎么治 |
|---|---|
| 资源浪费 | 连接在池子里反复借还,不再”每次新建、用完即弃” |
| 性能降低(资源这一半) | 省掉建立连接的等待(另一小半”SQL 编译”由预编译负责) |
为什么换连接池如此轻松?因为我们面向的始终是 DataSource 这个接口:MyBatis 拿数据源、SpringBoot 自动配置数据源,都是按接口来的;spring.datasource.type 只是告诉自动配置”实例化哪个实现类”。接口不变、用法不变,所以换产品不用改一行业务代码——这就是 49 篇讲 JDBC 时那句”面向接口编程,真正执行的是实现类”在连接池上的又一次上演。
PPT 第 29 页把整节压成四行,一句一句对回前面的小节:
| PPT 第 29 页的回顾 | 展开在哪一节 |
|---|---|
| 是一个容器,负责分配、管理数据库连接(Connection) | 第 26 页——“连接出租店”那套机制 |
| 优势:资源复用、提升系统响应速度 | 第 26 页——三大优势里的前两条(完整的三条还要加上避免数据库连接遗漏) |
| 接口:DataSource | 第 27 页——sun 提供、第三方实现、功能是获取连接 |
| 产品:C3P0、DBCP、Druid、Hikari(默认) | 第 27-28 页——四个产品 + 把默认的 Hikari 换成 Druid 的两步 |
回顾页只写了”资源复用、提升系统响应速度”两条优势,别以为避免连接遗漏这条不重要——它正是”池子会回收空闲超时连接”那条机制的目的,面试与排错时最容易被问到。
| 问题 | 答案 |
|---|---|
| 数据库连接池是什么? | 分配、管理数据库连接(Connection)的容器 |
| 它的两条机制是什么? | ① 允许应用程序重复使用一个现有的数据库连接,而不是再重新建立一个;② 释放空闲时间超过最大空闲时间的连接,避免因为没有释放连接而引起的数据库连接遗漏 |
| 三大优势? | 资源重用、提升系统响应速度、避免数据库连接遗漏 |
| 标准接口叫什么、谁提供、功能是什么? | DataSource,sun 官方提供(由第三方组织实现),功能就是获取连接 |
| 常见产品有哪些? | C3P0、DBCP、Druid、Hikari(其中 Hikari 是 SpringBoot 默认) |
| Druid 是什么? | 阿里巴巴开源的数据库连接池项目,PPT 原话是”功能强大,性能优秀,是 Java 语言最好的数据库连接池之一” |
| 切换 Druid 的两步? | ① pom.xml 加 druid-spring-boot-starter 依赖(课程用 1.2.19);② 配置里加一行 spring.datasource.type=com.alibaba.druid.pool.DruidDataSource |
不配 type 会怎样? | 用 SpringBoot 默认的 Hikari(实测 com.zaxxer.hikari.HikariDataSource),不是”没有连接池” |
| 本机实测的类名对照 | 配了 type 的工程 → com.alibaba.druid.pool.DruidDataSource;没配的工程 → com.zaxxer.hikari.HikariDataSource;连接对象两边都是 com.mysql.cj.jdbc.ConnectionImpl |
| 连接池治的是哪两个痛点? | 52 篇四条里的资源浪费与性能降低(性能里的另一半由预编译负责) |
Connection)DataSource——官方(sun)提供的数据库连接池接口,由第三方组织实现本接口;功能就是获取连接pom.xml 加依赖 com.alibaba : druid-spring-boot-starter : 1.2.19;② 配置里加一行 spring.datasource.type=com.alibaba.druid.pool.DruidDataSource(yml 里是 spring.datasource.type: 缩进写)com.zaxxer.hikari.HikariDataSourcetype 的工程 → com.alibaba.druid.pool.DruidDataSource;没配的工程 → com.zaxxer.hikari.HikariDataSource;两个工程里拿到的连接对象都是 com.mysql.cj.jdbc.ConnectionImpl(MySQL 驱动提供的实现) 2-1 把数据源配置(含切换 Druid)写进 application.yml
需求:在一个新的 SpringBoot 工程里,用 yml 格式的配置文件写清四行数据源连接信息(连 web01 库),并把连接池换成 Druid。
写完回答:这五行里哪四行是”连接信息”、哪一行是”选连接池产品”?
(练习文件 test_53_切换连接池.yml 里给了写作区。)
一级 · 思路:配置项的组织方式从”点分号平铺”变成”层级缩进”——spring.datasource 里的每一项都缩进写在它下面,切换连接池的那一行也在这个层级里
二级 · 方法:yml 里键与值之间要有空格;四个连接项是 url、driver-class-name、username、password;切换连接池用 type,值是 Druid 连接池实现类的全限定名
三级 · 骨架:
spring: datasource: type: ____.alibaba.druid.pool.____ url: jdbc:mysql://localhost:3306/____ driver-class-name: com.mysql.cj.jdbc.____ username: ____ password: ____spring: datasource: # 选连接池产品:Druid type: com.alibaba.druid.pool.DruidDataSource # 数据库连接信息 url: jdbc:mysql://localhost:3306/web01 driver-class-name: com.mysql.cj.jdbc.Driver username: root password: 1234 # 换成你自己 MySQL 的密码回答:url、driver-class-name、username、password 这四项是连接信息(51 篇 1.3 就有的四行,只是换成了 yml 的写法);type 那一行是”选连接池产品”,值写的是实现类的全限定名——这也是本机实测里 dataSource.getClass().getName() 会从 com.zaxxer.hikari.HikariDataSource 变成 com.alibaba.druid.pool.DruidDataSource 的直接原因。
2-2 把同一份配置改写成 properties 格式,并说清两种格式的关系
需求:把 2-1 的五行配置改写成 application.properties 的写法,再回答:两种格式的配置项内容有变化吗?如果同一个工程里两种文件都存在、且写了同样的键,谁的优先级更高?
(练习文件 test_53_切换连接池.yml 里给了写作区。)
一级 · 思路:properties 是”一个键一行、用点号表示层级”,yml 是”用缩进表示层级”——它们是同一个配置的两种表达
二级 · 方法:把 spring: 与 datasource: 两级拼成点号前缀,后面接各项;键与值之间用 = 连接
三级 · 骨架:spring.datasource.type=____ / spring.datasource.url=____ / …(参考 51 篇 1.3 和 PPT 第 28 页)
spring.datasource.type=com.alibaba.druid.pool.DruidDataSourcespring.datasource.url=jdbc:mysql://localhost:3306/web01spring.datasource.driver-class-name=com.mysql.cj.jdbc.Driverspring.datasource.username=rootspring.datasource.password=1234① 内容没有任何变化——两种文件写的是同一组配置项,只是语法不同(properties 用点号与 =,yml 用缩进与冒号空格)。本机实测里 aliyun-mybatis-quickstart 用 properties、springboot-mybatis-quickstart 用 yml,两套配置都跑通了测试(56 篇的”两种配置等效”实测)。
② 若同一个工程里两种文件都存在且键相同,application.properties 的优先级更高(会覆盖 yml 里的同名键)——这是”别同时放两份互相打脸”的原因。
2-3 说清 DataSource 的身世
不看笔记回答:数据库连接池的标准接口叫什么?由谁提供?由谁实现?它的功能是什么?——然后再回答一个类比题:为什么说它和 JDBC 是”同一个套路”?
(答案写在你的笔记里即可。)
一级 · 思路:回忆 49 篇讲的 JDBC 本质——“sun 定义规范(接口),各厂商去实现,我们面向接口编程”
二级 · 方法:标准接口是 DataSource,sun 官方提供,第三方组织实现,功能只有一条——获取连接;JDBC 那边是 sun 定义 Connection/Statement 等接口、数据库厂商提供驱动实现
三级 · 骨架:接口 ____ → 定义方 ____ → 实现方 ____ → 功能 ____;类比:JDBC 里定义方是 sun、实现方是 ____
标准接口叫 DataSource:官方(sun)提供这个数据库连接池接口,由第三方组织实现它,功能就一条——获取连接(dataSource.getConnection())。
类比:这跟 JDBC 是一模一样的分工——JDBC 那套里,sun 定义了 Connection、PreparedStatement、ResultSet 这些接口,各数据库厂商去实现并提供驱动 jar,我们面向接口编程,真正执行的是驱动里的实现类;连接池这套里,sun 定义了 DataSource,**各连接池产品(C3P0、DBCP、Druid、Hikari)**去实现它,我们同样面向接口编程,真正干活的是某个池子的实现类(实测里要么 DruidDataSource、要么 HikariDataSource)。
这也解释了一个”看起来神奇”的现象:换连接池只需要改一行 spring.datasource.type——因为业务代码拿的一直是 DataSource 这个接口,实现类换成谁它都不关心。
2-4 两个痛点,各归谁治 52 篇列了 JDBC 的四个痛点。请把这四条逐条写出来,并说明每一条由谁解决——特别说清”性能降低”这一条为什么不能只靠连接池。 (答案写在你的笔记里即可。)
一级 · 思路:“性能降低”其实包含两笔开销——连上数据库的那段时间,和每次执行 SQL 前的编译;两笔开销是两个不同的东西
二级 · 方法:连接池治的是”连接”这笔开销(资源复用);“SQL 编译”这笔由预编译(? 占位符 + 编译缓存)治,MyBatis 的 #{} 默认就走它
三级 · 骨架:硬编码 → 配置化;繁琐 → 一行注解;资源浪费 → 连接池;性能降低 → 连接池(省连接开销)+ 预编译(省编译开销)
| 痛点 | 谁解决 |
|---|---|
| 硬编码 | 配置化——连接信息搬到 application.properties/application.yml(51 篇) |
| 繁琐 | MyBatis 的注解(或 XML)——一行 @Select 顶掉一整段流程代码 |
| 资源浪费 | 数据库连接池——连接借还复用,不再每次新建、用完即弃 |
| 性能降低 | 连接池 + 预编译,各治一半——池子省掉”建立连接”的等待;预编译 SQL(? 占位符 + 编译缓存)省掉”每次重新编译 SQL”的开销 |
所以”性能降低”不能只靠连接池:连接池只管”连接从哪来、要不要重建”,管不到”这条 SQL 的编译有没有被复用”。本机实测的 MyBatis 日志里那一行 Preparing: ... where id = ? 就是预编译在干活(#{} → ?),它和连接池一起,才把 52 篇那四条痛点全部补上。 |
3-1 把入门工程切成 Druid,并让运行时自己”报出”它用的是谁 找一个已经跑起来的 MyBatis 入门工程(51 篇那个),完成一次”看得见”的切换:
dataSource.getClass().getName() 与 dataSource.getConnection().getClass().getName(),跑一次,把两个类名抄下来;pom.xml 加 Druid 连接池的 starter 依赖(版本 1.2.19);test_53_切换连接池.yml 里按 6 步给了写作区。)涉及知识点
| 知识点 | 在这里的应用 |
|---|---|
| 连接池 = 容器 | 第 1、4 步——打印出的 DataSource 实现类就是”池子本身” |
DataSource 接口 | 第 5 步——业务代码面向接口,所以几乎不用改 |
| SpringBoot 默认 Hikari | 第 1 步——什么都不配也能打印出 HikariDataSource |
| 切换 Druid 两步 | 第 2、3 步——starter 依赖 + spring.datasource.type |
| 连接来自驱动 | 第 5 步——连接对象始终是 MySQL 驱动的 ConnectionImpl |
| 配置的两个格式 | 第 3 步——properties 与 yml 的等价写法(56 篇) |
一级 · 思路:这一题的关键是”用运行时的类名当证据”——配置写得对不对,问运行时最准;两次输出一比,切换做没做成自见分晓
二级 · 方法:测试类用 @SpringBootTest + @Autowired DataSource;打印 dataSource.getClass().getName() 与 dataSource.getConnection().getClass().getName();依赖是 com.alibaba : druid-spring-boot-starter : 1.2.19;配置行是 spring.datasource.type=com.alibaba.druid.pool.DruidDataSource
三级 · 骨架:第 1 步测试方法里两行 System.out.println(____.getClass().getName());第 3 步 properties 版 spring.datasource.____=com.alibaba.druid.pool.____ / yml 版 type: ____
1、4. 两次实测的类名(就是本篇那张对照表的来源,本机在课程的两个工程上各跑过一次):
-- 切换前(没配 type)dataSource → com.zaxxer.hikari.HikariDataSource ← SpringBoot 默认connection → com.mysql.cj.jdbc.ConnectionImpl ← MySQL 驱动
-- 切换后(加了 druid-spring-boot-starter + spring.datasource.type)dataSource → com.alibaba.druid.pool.DruidDataSource ← 换成了 Druidconnection → com.mysql.cj.jdbc.ConnectionImpl ← 还是驱动给的2~3. 两步改动:
<!-- pom.xml:Druid连接池 --><dependency> <groupId>com.alibaba</groupId> <artifactId>druid-spring-boot-starter</artifactId> <version>1.2.19</version></dependency># application.properties:指定连接池产品spring.datasource.type=com.alibaba.druid.pool.DruidDataSource(yml 版就是 spring: → datasource: → type: com.alibaba.druid.pool.DruidDataSource。)
5. 三个回答:
① 连接对象的类名没变,始终是 com.mysql.cj.jdbc.ConnectionImpl。因为连接池只负责”分配、管理”连接,真正造连接的还是 MySQL 驱动——池子里的连接也是驱动创建的,池子只是把它们存起来反复借还。
② 业务代码一行没改(Mapper 接口、Service 都不动):切换只发生在”依赖 + 配置”层面——因为业务代码面向的是 DataSource 接口,不关心实现类是谁。
③ 想换别的连接池产品,只需:加对应产品的 starter 依赖(或把用不上的依赖去掉)+ 改 spring.datasource.type 的值(写成新产品的实现类全限定名)。前提是新产品实现了 DataSource 接口——这正是”标准接口”的意义。
6. 切换前后对照表:
| 工程配置 | 连接池类名(dataSource) | 连接类名(connection) |
|---|---|---|
不配 type(默认) | com.zaxxer.hikari.HikariDataSource | com.mysql.cj.jdbc.ConnectionImpl |
type=com.alibaba.druid.pool.DruidDataSource | com.alibaba.druid.pool.DruidDataSource | com.mysql.cj.jdbc.ConnectionImpl |
这张表本身就是本篇最值钱的结论:换连接池 = 换 DataSource 的实现类,不用动业务代码。
如果你喜欢,那么欢迎来到我的世界!
了解更多暂未播放

















