
国庆节10月1日
--

第 5 章 DQL 部分的最后一篇,讲七段结构里 order by 与 limit 这两段。排序部分讲升序 asc(默认可省)、降序 desc 与多字段排序的规则,并用实测展示结果;分页部分讲 limit 起始索引、查询记录数 的三条说明与页码换算公式。最后用四组实测实验把 DQL 的真实执行顺序钉死——where 里用别名报 1054、用聚合报 1111,而 order by 里用别名完全可行
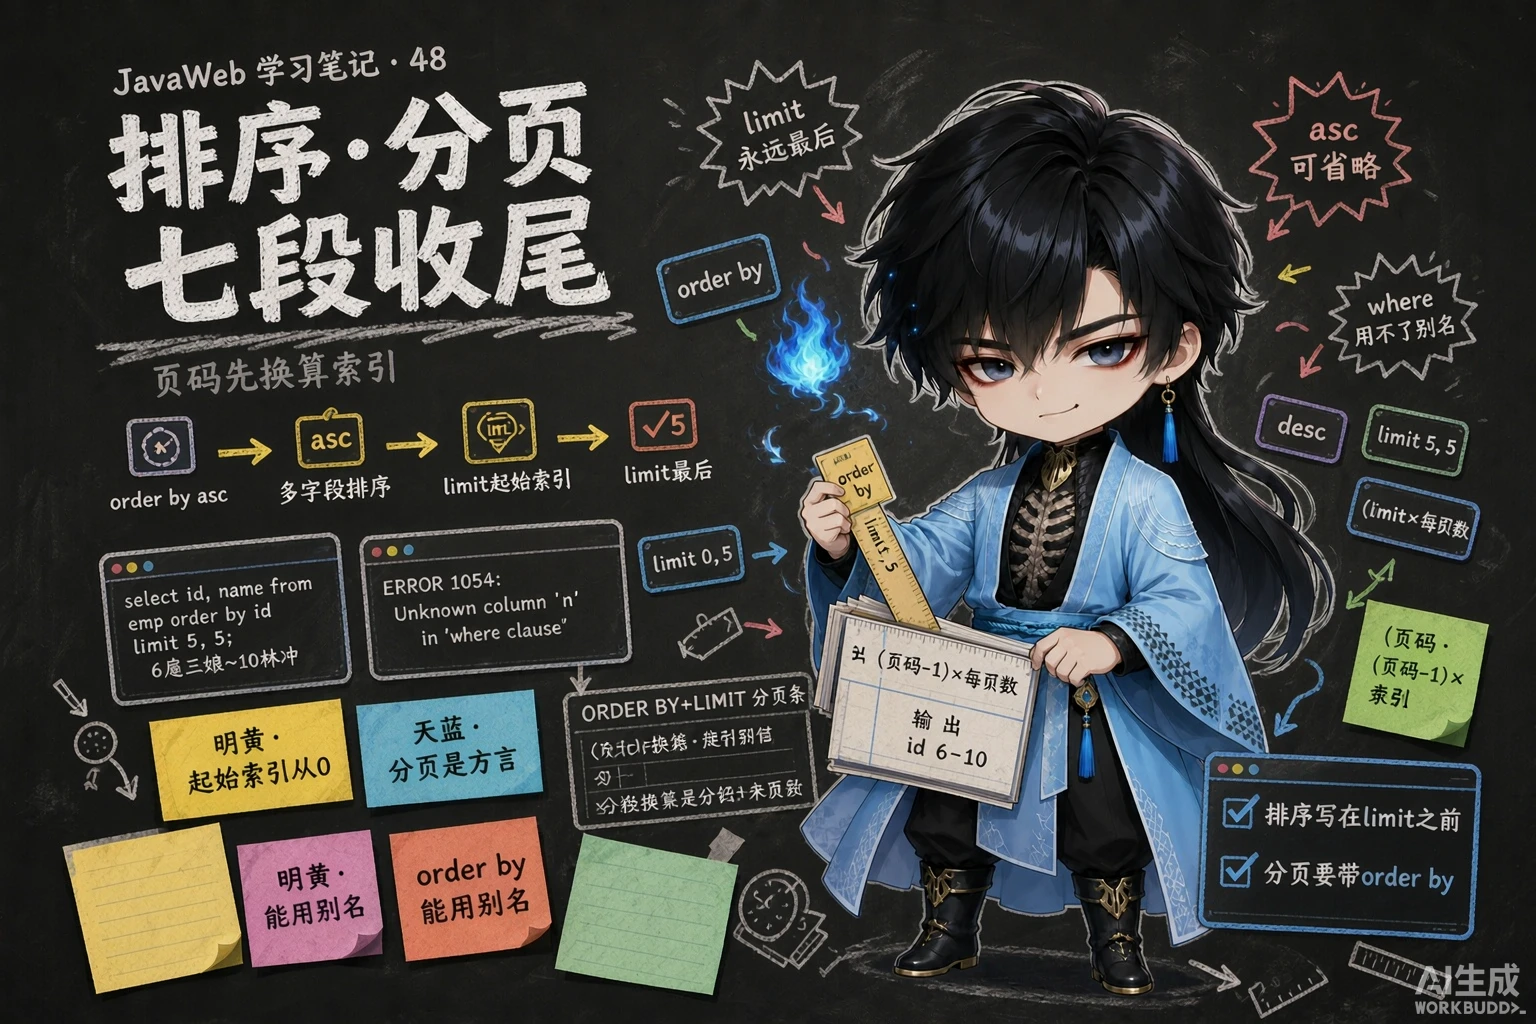
到这一篇,DQL 的七段结构就凑齐了:前两篇讲了查哪些列、筛哪些行(46 篇)和分组统计(47 篇),这一篇补上最后两段——排序与分页。这两段正好就是后台页面里”点表头排序""翻页”背后的东西。
本篇对应 PPT 第 62-67 页,最后还会用本机实测把一个常被忽略的问题讲透:SQL 的书写顺序和数据库的执行顺序不是一回事。
本机实测环境:MySQL 9.0.1(课程用 8.0.34),库 db01、表 emp(30 条员工数据)。
PPT 第 63 页的语法:
select 字段列表 from 表名 [where 条件列表] [group by 分组字段名 having 分组后过滤条件] order by 排序字段 排序方式;order by 就贴在七段结构的倒数第二段,位置上紧跟 having。排序方式只有两种(PPT 原文):
排序方式:升序(asc),降序(desc);默认为升序 asc,是可以不写的。
常用可以这么记:
select * from emp order by entry_date asc; -- 升序(从早到晚),asc 可省select * from emp order by entry_date; -- 等价写法select * from emp order by entry_date desc; -- 降序(从晚到早)本机实测(看前 5 行):
实测(MySQL 9.0.1,库 db01,表 emp):
select name, entry_date from emp order by entry_date limit 5; -- 升序(默认)select name, entry_date from emp order by entry_date desc limit 5; -- 降序-- 升序:最早入职的 5 个人+-----------+------------+| name | entry_date |+-----------+------------+| 施耐庵 | 2000-01-01 || 童猛 | 2002-01-01 || 史进 | 2002-08-01 || 李俊 | 2004-01-01 || 柴进 | 2005-08-01 |+-----------+------------+
-- 降序:最近入职的 5 个人+-----------+------------+| name | entry_date |+-----------+------------+| 李云 | 2020-03-01 || 宋清 | 2020-01-01 || 阮小二 | 2018-01-01 || 阮小七 | 2016-01-01 || 李应 | 2015-03-21 |+-----------+------------+降序的前 5 名换成薪资也试过:order by salary desc limit 5 得到 15000(施耐庵)、10900(孙二娘)、10800(阮小二)、10600(史进)、10500(顾大嫂)。
PPT 第 63 页的注意(原文):
如果是多字段排序,当第一个字段值相同时,才会根据第二个字段进行排序。
写法就是在 order by 后面按优先级把字段列出来,每个字段可以各带自己的升/降序:
select name, job, salary from emp order by job, salary desc;这句的意思是”先按职位升序排,职位相同的那些人再按薪资从高到低排”。
实测(MySQL 9.0.1,库 db01,表 emp):
select name, job, salary from emp order by job, salary desc limit 12;+-----------+------+--------+| name | job | salary |+-----------+------+--------+| 李云 | NULL | NULL | ← job 为 NULL 的行排在最前面| 李应 | 1 | 5800 || 杨志 | 1 | 5300 || 林冲 | 1 | 5000 || 武松 | 1 | 4900 || 李逵 | 1 | 4800 || 柴进 | 1 | 4700 || 孙二娘 | 2 | 10900 || 阮小二 | 2 | 10800 || 史进 | 2 | 10600 || 顾大嫂 | 2 | 10500 || 时迁 | 2 | 10200 |+-----------+------+--------+两组都能验证规则:职位 1 那一组的 6 个人内部是 5800 → 5300 → 5000 → 4900 → 4800 → 4700(薪资降序),职位 2 那一组内部同样是薪资从高到低——“第一个字段(job)相同,才轮到第二个字段(salary)说话”。
另外注意第一行:李云没有职位,NULL 在升序里排在最前面(MySQL 里 NULL 被当作最小);如果不想让空值出头,可以写 order by job is null, job, salary desc 这类写法把它赶到最后(属于进阶用法,知道有这回事即可)。
PPT 第 64 页问”下面三条排序语法分别代表什么意思”,对照着读一遍:
| 语法 | 含义 |
|---|---|
... order by age; | 按年龄升序(asc 是默认值,省略了) |
... order by age desc, score asc; | 按年龄降序排;年龄相同的再按成绩升序排 |
... order by age, score, update_time desc; | 三个字段依次比较:年龄升序 → 年龄相同看成绩升序 → 成绩也相同再按更新时间降序 |
三个例子合起来就是一句话:order by 后面的字段是从左到右的优先级,每个字段后面的 asc/desc 只作用于它自己(不写就是升序)。
顺带一个本机实测的小结论:排序字段可以写计算表达式或 select 里起的别名,比如按”年薪”排序:
select name, salary * 12 as 年薪 from emp order by 年薪 desc limit 3;实测前 3 名:施耐庵 180000、孙二娘 130800、阮小二 129600。为什么别名在这里能用、而在 where 里不能用?下面的执行顺序实验会给出答案。
PPT 第 66 页的语法:
select 字段 from 表名 [where 条件] [group by 分组字段 having 过滤条件] [order by 排序字段] limit 起始索引, 查询记录数;limit 是七段结构的最后一段,也是”只取结果中的一段”的那一刀。
| 说明(PPT 原文) | 意味着什么 |
|---|---|
| 起始索引从 0 开始 | limit 0, 5 取的是第 1-5 条;起始索引是”跳过的行数”,不是页码 |
| 分页查询是数据库的方言,不同的数据库有不同的实现,MySQL 中是 LIMIT | 换到 Oracle、SQL Server 就不是这个关键字了(这也是”方言”这个词的由来) |
如果起始索引为 0,起始索引可以省略,直接简写为 limit 10 | limit 10 等价于 limit 0, 10(取前 10 条) |
为了每次翻页的顺序稳定,下面的实测都加了 order by id(不写 order by 时,数据库不承诺返回顺序,翻页可能出现”重复或漏行”)。
实测(MySQL 9.0.1,库 db01,表 emp):
select id, name from emp order by id limit 0, 5; -- 第 1 页select id, name from emp order by id limit 5, 5; -- 第 2 页select id, name from emp order by id limit 10, 5; -- 第 3 页select id, name from emp order by id limit 3; -- 起始索引省略:取前 3 条-- limit 0, 5 → id 1-5(第 1 页)-- limit 5, 5 → id 6-10(第 2 页)+----+-----------+| id | name |+----+-----------+| 6 | 扈三娘 || 7 | 柴进 || 8 | 李逵 || 9 | 武松 || 10 | 林冲 |+----+-----------+
-- limit 10, 5 → id 11-15(第 3 页)limit 3(不带逗号)确实只取了前 3 条——这就是”起始索引为 0 时可省略”的写法。
PPT 第 67 页专门提了一句:
注意:项目开发中,前端传递过来的是页码,需要转换为起始索引。 公式:(页码 - 1)× 每页展示记录数
所以后端拿到”第 N 页”时,SQL 里的起始索引要自己算:
| 页码 | 每页 5 条时的起始索引 | 对应 SQL |
|---|---|---|
| 第 1 页 | (1-1)×5 = 0 | limit 0, 5 |
| 第 2 页 | (2-1)×5 = 5 | limit 5, 5 |
| 第 3 页 | (3-1)×5 = 10 | limit 10, 5 |
| 第 5 页 | (5-1)×5 = 20 | limit 20, 5 |
| 第 6 页 | (6-1)×5 = 25 | limit 25, 5 |
实测(MySQL 9.0.1,库 db01,表 emp,30 条数据、每页 5 条正好 6 页):
select id, name from emp order by id limit 20, 5; -- 第 5 页 → id 21-25(阮小五、阮小七、阮籍、童威、童猛)select id, name from emp order by id limit 25, 5; -- 第 6 页 → id 26-30(燕顺、李俊、李忠、宋清、李云)select id, name from emp order by id limit 27, 5; -- 从第 28 条开始取,只剩 3 条+----+--------+| id | name |+----+--------+| 28 | 李忠 || 29 | 宋清 || 30 | 李云 |+----+--------+最后一条验证了另一件事:总数不够时,limit 不会报错,只会返回剩下的那些行(要求 5 条,实际给了 3 条)。
分页查询很少单独出现——页面上”第 2 页”背后的 SQL 通常是 where(筛选条件)+ order by(排序)+ limit(取这一页)三件套一起上。这也解释了为什么完整语法的七段顺序里,limit 必须写在最后:它切的是”前面所有步骤都算完之后”的那份结果。
课件把七段的书写顺序定成了 select ... from ... where ... group by ... having ... order by ... limit。但数据库真正执行的顺序并不是这个。这一节用四组实验把它测出来。
实验的设计思路很简单:别名是在 select 阶段才产生的,如果一个子句能用别名,说明它执行在 select 之后;不能用,说明执行在 select 之前。
实测(MySQL 9.0.1,库 db01,表 emp):
| 实验 SQL | 实测结果 | 说明 |
|---|---|---|
select name as n from emp where n = '宋江'; | ERROR 1054 (42S22): Unknown column 'n' in 'where clause' | where 里用不了别名——它执行时 select 还没跑,n 这个名字还不存在 |
select job from emp where count(*) > 1; | ERROR 1111 (HY000): Invalid use of group function | where 里也用不了聚合函数——那时还没开始聚合(47 篇的坑,在这里又撞了一次) |
select job, count(*) as c from emp group by job having c > 3; | 成功(讲师 12、班主任 6、咨询师 9) | having 能用别名、也能用聚合——它执行得比 select 晚(在分组聚合之后) |
select name, salary * 12 as 年薪 from emp order by 年薪 desc; | 成功(前 3 名:施耐庵 180000、孙二娘 130800、阮小二 129600) | order by 能用别名——它执行得最晚,select 早就算完了 |
把这四组实验串起来,就得到数据库真实的执行顺序:
from → where → group by → 聚合函数 → having → select → order by → limit结论(实测印证):先确定从哪张表查(from)→ 筛掉不合格的行(where)→ 分组并聚合(group by + 聚合)→ 筛掉不合格的组(having)→ 再决定结果里显示哪些列、算别名(select)→ 排序(order by)→ 最后切出这一页(limit)。
为什么这个顺序这么重要?因为它一次性解释了三件”背也要背下来”的事:
where 里不能用别名、不能用聚合函数(select 还没跑、聚合还没算);having 里能用聚合函数、能用别名(它排在 select 前面一点点,但聚合已经算完,MySQL 也允许引用 select 里的别名);order by 里能用别名(它排在 select 之后)。书写顺序 ≠ 执行顺序——写 SQL 的时候必须按 select → from → where → group by → having → order by → limit 这个固定词序写(写错了是语法错误),但理解的时候要按执行顺序去想(谁能用别名、谁能用聚合,全都由执行顺序决定)。
| 问题 | 答案 |
|---|---|
| 排序查询语法 | select 字段列表 from 表名 [where ...] [group by ... having ...] order by 排序字段 排序方式; |
| 排序方式 | 升序 asc(默认值,可以不写)、降序 desc |
| 多字段排序的规则 | 按 order by 里的字段从左到右比较,第一个字段值相同时才看第二个;每个字段各带自己的升降序 |
| 实测排序结果 | order by entry_date desc limit 5 → 李云 2020-03-01、宋清 2020-01-01、阮小二 2018-01-01、阮小七 2016-01-01、李应 2015-03-21;order by job, salary desc 里职位 1 的 6 人按 5800 → 5300 → 5000 → 4900 → 4800 → 4700 降序 |
| 分页查询语法 | ... limit 起始索引, 查询记录数; |
| 分页三条说明 | ① 起始索引从 0 开始;② 分页是数据库的方言,MySQL 里就是 limit;③ 起始索引为 0 时可省略(limit 10 = limit 0, 10) |
| 页码怎么换算 | 起始索引 = (页码 - 1)× 每页展示记录数——第 2 页每页 5 条就是 limit 5, 5,第 6 页是 limit 25, 5 |
| 实测分页结果 | 30 条数据每页 5 条正好 6 页:limit 5, 5 → id 6-10、limit 10, 5 → id 11-15、limit 20, 5 → id 21-25、limit 25, 5 → id 26-30;limit 27, 5 只剩 28-30 三条(不够时不报错,返回剩下的) |
| DQL 的真实执行顺序 | from → where → group by → 聚合函数 → having → select → order by → limit(书写顺序固定为 select/from/where/group by/having/order by/limit,两者不是一回事) |
| 执行顺序的两组实测证据 | where 里用别名 → ERROR 1054 (42S22): Unknown column 'n' in 'where clause';where count(*) > 1 → ERROR 1111 (HY000): Invalid use of group function;而 having 用别名/聚合、order by 用别名都成功 |
| 本机环境 | MySQL 9.0.1(课程用 8.0.34),库 db01、表 emp(30 条数据) |
select 字段列表 from 表名 [where 条件列表] [group by 分组字段名 having 分组后过滤条件] order by 排序字段 排序方式;asc(默认值,可省略不写)、降序 desc;order by age 与 order by age asc 完全等价order by 后面的字段按从左到右的优先级比较,第一个字段值相同时才根据第二个字段排序;order by age desc, score asc 是”年龄降序;年龄相同则成绩升序”select name, salary * 12 as 年薪 from emp order by 年薪 desc 可用;NULL 在升序里排在最前面(实测 order by job 时李云那行排第一)... limit 起始索引, 查询记录数;limit;③ 起始索引为 0 时可省略,limit 10 等于 limit 0, 10limit 0, 5、第 2 页 limit 5, 5、第 6 页 limit 25, 5limit 5, 5 → id 6-10;limit 10, 5 → id 11-15;limit 20, 5 → id 21-25;limit 25, 5 → id 26-30;limit 27, 5 只剩 3 条(取不够时不报错)from → where → group by → 聚合函数 → having → select → order by → limit;而书写顺序固定是 select → from → where → group by → having → order by → limit——两者不是一回事where 里用别名 → ERROR 1054 (42S22): Unknown column 'n' in 'where clause';where 里用聚合 → ERROR 1111 (HY000): Invalid use of group function;having 用聚合(或别名)、order by 用别名都能成功——说明 select 排在 where 之后 2-1 按入职时间排个序
查出所有员工的姓名和入职日期,先按入职时间从早到晚排一次,再按从晚到早排一次。
(练习文件 test_48_排序查询.sql 里给了题目注释和写作区。)
一级 · 思路:两次查询只差”排序方向”这一个词,升序那个词可以省
二级 · 方法:order by 字段 排序方式;从早到晚是升序 asc(可以省略),从晚到早是降序 desc
三级 · 骨架:select name, entry_date from emp order by entry_date ____;(第一次)/ ... order by entry_date ____;(第二次)
-- 从早到晚(升序,asc 可省略)select name, entry_date from emp order by entry_date;-- 从晚到早(降序)select name, entry_date from emp order by entry_date desc;本机实测(各取前 5 行):
-- 升序:施耐庵 2000-01-01、童猛 2002-01-01、史进 2002-08-01、李俊 2004-01-01、柴进 2005-08-01-- 降序:李云 2020-03-01、宋清 2020-01-01、阮小二 2018-01-01、阮小七 2016-01-01、李应 2015-03-21别忘了升序那一句里的 asc 是可省的——写成 order by entry_date asc 和 order by entry_date 结果完全一样。
2-2 一个字段排不出来,就再加一个 查出员工的姓名、职位、薪资,要求:先按职位升序排;职位相同的,再按薪资从高到低排。
一级 · 思路:这是”两个排序条件”,谁写在前面谁先说话;两个字段可以各带自己的方向
二级 · 方法:order by 字段1 方向1, 字段2 方向2——第一个字段不写方向(默认升序),第二个字段写降序关键字 desc
三级 · 骨架:select name, job, salary from emp order by job, salary ____;
select name, job, salary from emp order by job, salary desc;本机实测(截取前 12 行):
+-----------+------+--------+| name | job | salary |+-----------+------+--------+| 李云 | NULL | NULL || 李应 | 1 | 5800 || 杨志 | 1 | 5300 || 林冲 | 1 | 5000 || 武松 | 1 | 4900 || 李逵 | 1 | 4800 || 柴进 | 1 | 4700 || 孙二娘 | 2 | 10900 || 阮小二 | 2 | 10800 || 史进 | 2 | 10600 || 顾大嫂 | 2 | 10500 || 时迁 | 2 | 10200 |+-----------+------+--------+职位 1 组内部是 5800→5300→5000→4900→4800→4700(降序),职位 2 组内部同样降序——正是”第一个字段相同,才轮到第二个字段排序”。第一行李云没有职位,NULL 在升序里被当成最小值排在最前。
2-3 把第 2 页和第 5 页翻出来(每页 5 条) 员工数据一共 30 条,按每页 5 条分页。要求:按 id 升序,分别取出第 2 页和第 5 页的数据(显示 id 和姓名)。
一级 · 思路:注意”页码”不能直接写进 SQL——要先用公式把页码换成”起始索引”;另外先排好序再切页,顺序才稳定
二级 · 方法:limit 起始索引, 查询记录数;起始索引 =(页码 - 1)× 每页条数;排序用 order by id
三级 · 骨架:第 2 页 → ... order by id limit ____, 5;(起始索引 = (2-1)×5)/ 第 5 页 → ... limit ____, 5;
-- 第 2 页:(2-1)×5 = 5select id, name from emp order by id limit 5, 5;-- 第 5 页:(5-1)×5 = 20select id, name from emp order by id limit 20, 5;本机实测:
-- limit 5, 5 → 第 2 页(id 6-10)+----+-----------+| id | name |+----+-----------+| 6 | 扈三娘 || 7 | 柴进 || 8 | 李逵 || 9 | 武松 || 10 | 林冲 |+----+-----------+
-- limit 20, 5 → 第 5 页(id 21-25):阮小五、阮小七、阮籍、童威、童猛两个细节:① 起始索引不是页码,第 2 页对应的是 5;② 分页时一定要带 order by——不排序的话数据库不承诺返回顺序,同一页翻两次可能看到不同的行。另外 limit 5, 5 里的第一个 5 表示”跳过前 5 条”,不是”从第 5 条开始取”。
2-4 找错:这条 SQL 为什么报 1054 有同学想查宋江这条数据,写成了下面这样,结果报错。请说明原因,并分别用”两种改法”把它写对:
select name as n from emp where n = '宋江';报错原文:ERROR 1054 (42S22): Unknown column 'n' in 'where clause'
一级 · 思路:别名 n 是 select 阶段才”起”出来的名字,而这条 SQL 里某个子句跑在 select 之前——想清楚 DQL 的真实执行顺序,答案就出来了
二级 · 方法:where 的执行排在 select 之前,所以看不到别名;两种改法分别是”不用别名”和”换个字段”——过滤条件直接写原始字段名,或者要排序/显示时才用别名
三级 · 骨架:select name from emp where ____ = '宋江';(改法一)/ 如果要按别名排序:... order by n;(order by 排在 select 之后,可以用别名)
原因:DQL 的真实执行顺序是 from → where → group by → 聚合 → having → select → order by → limit——where 排在 select 前面,执行它的时候别名 n 还没被”起”出来(所以报 Unknown column 'n' in 'where clause')。
两种改法:
-- 改法一:过滤条件里直接用原始字段名(最常用)select name from emp where name = '宋江';
-- 改法二:别名留给"排在 select 后面"的子句用(比如排序)select name as n from emp order by n;一个对照组(本机实测):select name, salary * 12 as 年薪 from emp order by 年薪 desc; 完全可行,因为 order by 执行在 select 之后,年薪 这个别名已经存在了。同一条规则的两面——where 里不能用别名(1054)、order by 里能用别名——都是”执行顺序”这一个知识点的体现:
ERROR 1054 (42S22): Unknown column 'n' in 'where clause' ← where 用别名:不允许成功(前 3 名:施耐庵 180000、孙二娘 130800、阮小二 129600) ← order by 用别名:允许 3-1 用一份数据把五类 DQL 查询串起来跑一遍
在 db01 库的 emp 表(30 条数据)上,模拟”一个人事看数据”的完整流程,每一步都写出 SQL 并把结果记下来:
select 里只能写分组字段和聚合函数);order by 和 limit 谁写在前面?为什么?涉及知识点
| 知识点 | 在这里的应用 |
|---|---|
| 基本查询 | 第 1 步——字段列表 + 中文别名 |
| 条件查询 | 第 2 步——where salary >= 10000 |
| 聚合函数 | 第 3 步——count / avg / max / min |
| 分组查询 | 第 4 步——group by job + 聚合,NULL 自成一组 |
| 排序查询 | 第 5 步——order by salary desc limit 5 |
| 分页查询 | 第 6 步——起始索引 =(页码 - 1)× 每页条数 |
| 执行顺序 | 第 7 步——order by 在 limit 之前(排序排完才切页) |
一级 · 思路:这一题就是把七段结构从头到尾走一遍,每一步只加一个子句;第 7 步问的是执行/书写顺序里 order by 与 limit 谁在前
二级 · 方法:where 筛行、group by + 聚合函数分组统计、order by 字段 desc 降序、limit 起始索引, 条数 切页;书写顺序是 select → from → where → group by → having → order by → limit
三级 · 骨架:第 2 步 select count(*) from emp where salary ____ 10000; / 第 5 步 select name, job, salary from emp order by salary ____ limit 5; / 第 6 步 ... order by id limit ____, 5;(起始索引 =(2-1)×5)
-- 1. 基本查询select name 姓名, job 职位, salary 薪资 from emp;
-- 2. 条件查询select count(*) from emp where salary >= 10000;
-- 3. 聚合函数select count(*) as 人数, avg(salary) as 平均薪资, max(salary) as 最高薪资, min(salary) as 最低薪资 from emp;
-- 4. 分组查询select job, count(*) as 人数, round(avg(salary), 2) as 平均薪资 from emp group by job;
-- 5. 排序查询select name, job, salary from emp order by salary desc limit 5;
-- 6. 分页查询(每页 5 条,第 2 页 → 起始索引 (2-1)*5 = 5)select id, name from emp order by id limit 5, 5;本机实测(MySQL 9.0.1,db01.emp):
2. 薪资大于等于 10000 的有 7 人(施耐庵 15000、孙二娘 10900、阮小二 10800、史进 10600、顾大嫂 10500、时迁 10200、小李广 10000——正好 10000 的那位也算,因为写的是 >=);
3. 人数 30、平均薪资 7548.2759、最高 15000、最低 4700(avg 的分母是 29 不是 30,47 篇的 NULL 规则仍然生效);
4. 分组结果:
+------+------+-----------+| job | 人数 | 平均薪资 |+------+------+-----------+| 4 | 1 | 15000.00 || 2 | 12 | 9875.00 || 3 | 1 | 6500.00 || 1 | 6 | 5083.33 || 5 | 9 | 5377.78 || NULL | 1 | NULL |+------+------+-----------+职位为 NULL 的那一组只有李云一人,他的 salary 也是 NULL,所以这一组的平均薪资格是空值;
5. 薪资前 5 名:施耐庵 15000、孙二娘 10900、阮小二 10800、史进 10600、顾大嫂 10500;
6. 第 2 页是 id 6-10(扈三娘、柴进、李逵、武松、林冲),起始索引 5 由 (2-1)×5 算出;
7. order by 写在 limit 前面——先按薪资排好序,limit 再从那串有序结果里切出”第 6 到第 10 条”。这也是七段语法里 limit 永远排在最后的原因:它切的是前面所有步骤都算完之后的最终结果。
注意第 6 步我写的是 order by id,这样翻页顺序稳定;如果想让第 2 页是”薪资第 6-10 名”,就把排序换成 order by salary desc——分页本身不排序,排谁由 order by 决定。
如果你喜欢,那么欢迎来到我的世界!
了解更多暂未播放

















