国庆节10月1日
--

综合实战:爬取 TMDB 高分电影榜单 Top100,提取 11 个字段、翻页、用正则做数据清洗并存入 CSV
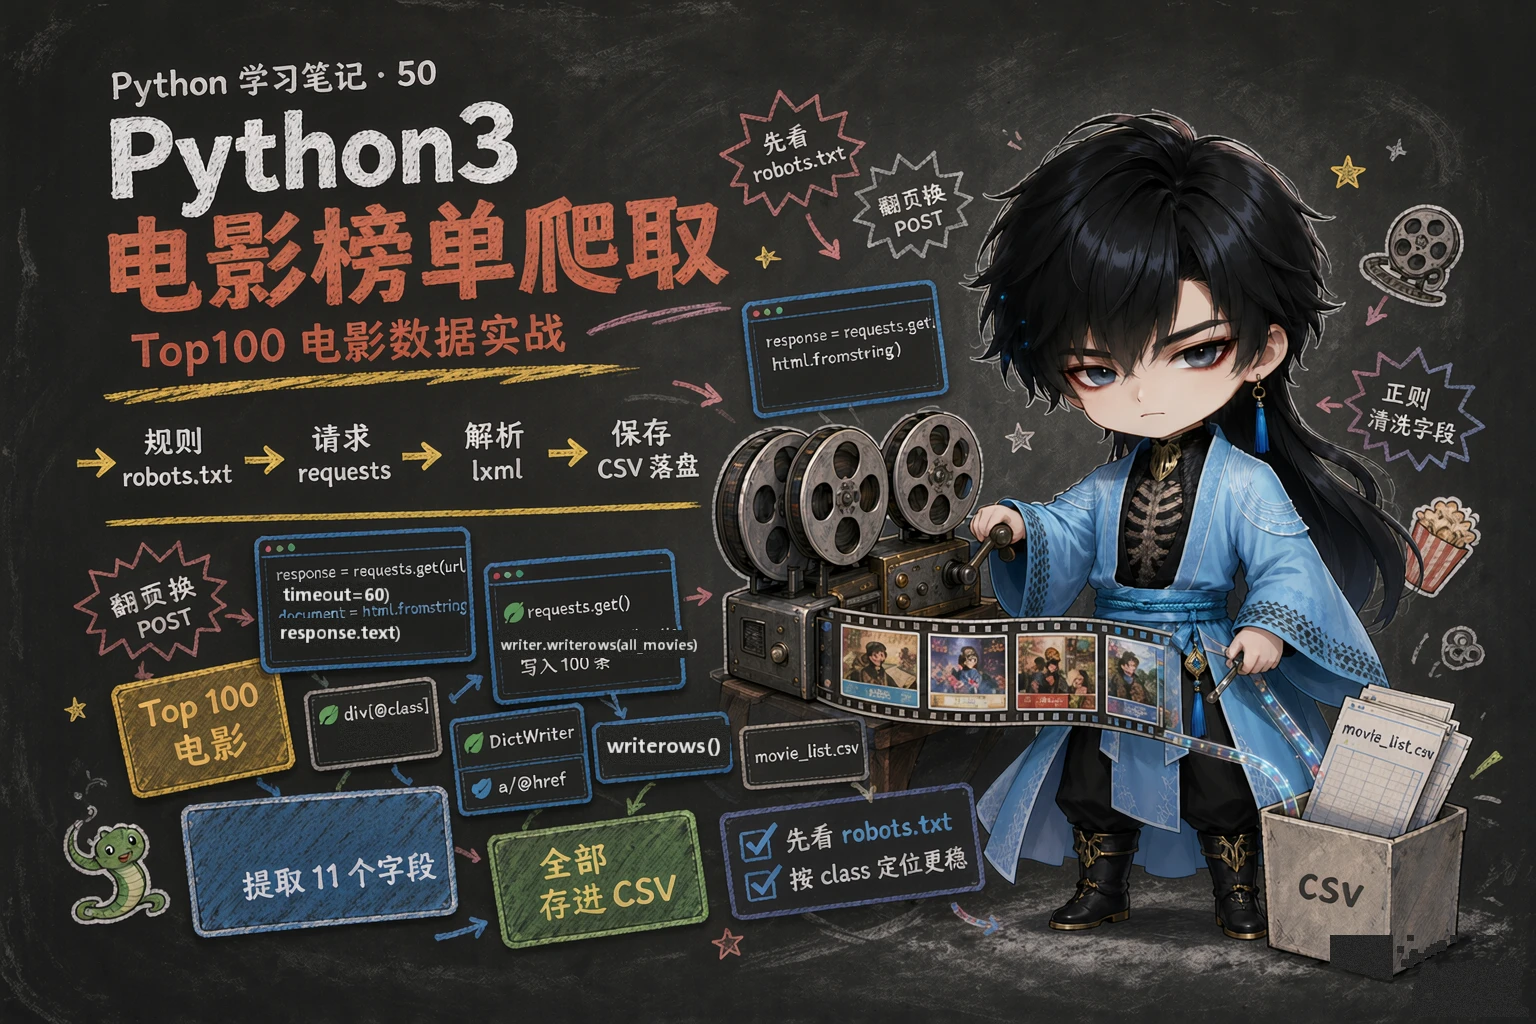
获取高分电影榜单(Top100)数据,并保存在 CSV 文件中。字段包括:电影名、年份、上映时间、类型、时长、评分、语言、导演、作者、宣传语、简介。
robots.txt 中的抓取规则| 版本 | 解决了什么 |
|---|---|
| 1(05) | 搭骨架:请求榜单页 → 解析出电影卡片列表 → 遍历取详情 url → 空函数占位 |
| 2(06) | 写 get_movie_info():从详情页提取 11 个字段,拼成字典返回 |
| 3(07) | 写 save_all_movies():用 csv.DictWriter 把全部电影写入 CSV,加过程日志 |
| 4(08) | 翻页:第 1 页用 GET,第 2 页起换接口用 POST 提交表单数据,循环 1~5 页 |
| 5(09) | 定位更稳:详情页字段改用 span[@class='release'] 这种按 class 属性的写法 |
| 优化(12) | 数据清洗:新增三个函数,用正则把年份、上映时间、时长统一成规范格式 |
import csv
MOVIE_LIST_FILE = "csv_data/movie_list.csv"
def save_all_movies(all_movies): with open(MOVIE_LIST_FILE, "w", encoding="utf-8", newline="") as csvfile: writer = csv.DictWriter(csvfile, fieldnames=["电影名", "年份", "上映时间", "类型", "时长", "评分", "语言", "导演", "作者", "宣传语", "简介"]) writer.writeheader() # 写入表头 writer.writerows(all_movies) # 一次写入所有行import requestsfrom lxml import html
TMDB_BASE_URL = "https://www.themoviedb.org"TMDB_TOP_URL_1 = "https://www.themoviedb.org/movie/top-rated" # 第 1 页(GET)TMDB_TOP_URL_2 = "https://www.themoviedb.org/discover/movie/items" # 第 2 页起(POST)
response = requests.get(TMDB_TOP_URL_1, timeout=60)document = html.fromstring(response.text)
# 每张电影卡片movie_list = document.xpath(f"//*[@id='page_1']/div[@class='card style_1']")
for movie in movie_list: movie_urls = movie.xpath("./div/div/a/@href") # 详情页的相对地址 if movie_urls: movie_info_url = TMDB_BASE_URL + movie_urls[0] # 拼成完整 url详情页里 11 个字段各对应一条 Xpath,写法都一样(定位元素 → /text() 取文本,或 /@data-percent 取属性)。例如评分取的是圆环图表的 @data-percent 属性。完整的 11 条见课程文件 12. 网络机器人-案例-电影榜单(优化).py。
for page_num in range(1, 6): if page_num == 1: response = requests.get(TMDB_TOP_URL_1, timeout=60) else: # 第 2 页起换了一个接口,用 POST 提交一长串表单参数(其中 page=页码) response = requests.post(TMDB_TOP_URL_2, f"......&page={page_num}&......", timeout=60)
document = html.fromstring(response.text) movie_list = document.xpath(f"//*[@id='page_{page_num}']/div[@class='card style_1']")网页上拿到的原始数据不规范:年份是 1994 但混在别的文字里、时长是 2h 20m。用三个函数清洗:
import re
# 获取电影年份(取 4 位数字)def get_movie_year(movie_years): movie_year = movie_years[0].strip() if movie_years else '' year_res = re.search(r"\d{4}", movie_year) return year_res.group() if year_res else ''
# 获取上映时间(只留 yyyy-mm-dd 部分)def get_movie_publish_date(movie_dates): movie_date = movie_dates[0].strip() if movie_dates else '' return re.search(r"\d{4}-\d{2}-\d{2}", movie_date).group() # 1957-04-10
# 获取电影时长(统一转换为分钟, 如: 2h 20m --> 140)def get_movie_cost_time(movie_cost_times): movie_cost_time = movie_cost_times[0].strip() if movie_cost_times else '' # 2h 20m / 40m / 2h h_res = re.search(r"(\d+)h", movie_cost_time) m_res = re.search(r"(\d+)m", movie_cost_time) h = int(h_res.group(1)) if h_res else 0 m = int(m_res.group(1)) if m_res else 0 return h * 60 + m时长那段的 h_res.group(1) 取的是括号分组里的数字((\d+)h 里括号包住的 \d+)。h_res 可能是 None(比如只有 40m 没有小时),所以用三目表达式兜底为 0。
完整最终版见课程文件 12. 网络机器人-案例-电影榜单(优化).py:把”保存 CSV + 详情提取(11 条 Xpath)+ 翻页循环 + 三个清洗函数”四块组合起来即可,main() 的流程就是入门程序那五步。
运行前记得先看目标网站的 robots.txt;请求统一加 timeout;对频率保持克制(Crawl-delay 的精神)。
csv 模块按字典写入movie.xpath("./div/div/a/@href"),再和 TMDB_BASE_URL 拼接@data-percent 属性,不是文本\d{4}(取 4 位数字);清洗上映时间用 \d{4}-\d{2}-\d{2}(取日期部分)2h 20m 清洗成分钟:(\d+)h 取小时、(\d+)m 取分钟,结果 = 小时 × 60 + 分钟h_res.group(1) 里的 1 表示取第 1 个括号分组的内容(第一个括号)全部用假数据,不需要真的爬网站。
2-1 清洗年份
写 get_movie_year(movie_years):传入如 ["肖申克的救赎 (1994)"],返回 4 位年份字符串。
一级 · 思路:从一堆文字里抠出”连续 4 位数字”
二级 · 方法:re.search(r"\d{4}", 文本).group()(先判空)
三级 · 骨架:res = re.search(...); return res.____() if res else ''
# 2-1import re
def get_movie_year(movie_years): movie_year = movie_years[0].strip() if movie_years else '' year_res = re.search(r"\d{4}", movie_year) return year_res.group() if year_res else '' 2-2 清洗时长
写 get_movie_cost_time(movie_cost_times):["2h 20m"] 返回 140;["40m"] 返回 40;["2h"] 返回 120。
一级 · 思路:小时和分钟分开找,找不到按 0 处理,最后换算成分钟相加
二级 · 方法:re.search(r"(\d+)h", s) / re.search(r"(\d+)m", s) / group(1)
三级 · 骨架:h = int(h_res.group(1)) if h_res else 0
# 2-2import re
def get_movie_cost_time(movie_cost_times): movie_cost_time = movie_cost_times[0].strip() if movie_cost_times else '' h_res = re.search(r"(\d+)h", movie_cost_time) m_res = re.search(r"(\d+)m", movie_cost_time) h = int(h_res.group(1)) if h_res else 0 m = int(m_res.group(1)) if m_res else 0 return h * 60 + m 2-3 清洗上映时间
写 get_movie_publish_date(movie_dates):传入如 ["1994-09-23 (CN)"],返回 1994-09-23。
一级 · 思路:日期部分是固定模式 yyyy-mm-dd
二级 · 方法:re.search(r"\d{4}-\d{2}-\d{2}", s).group()
三级 · 骨架:模式串里 \d{4} 后面跟 - 再跟 \d{2}
# 2-3import re
def get_movie_publish_date(movie_dates): movie_date = movie_dates[0].strip() if movie_dates else '' return re.search(r"\d{4}-\d{2}-\d{2}", movie_date).group() 3-1 组装一个小流程
准备 3 条假电影数据(含不规范的年份/时长),把 2-1、2-2、2-3 的清洗函数用上,再用 csv.DictWriter 全部写入 movie_list_test.csv,最后读回来打印检查。
一级 · 思路:清洗(逐条过三个函数)→ 存盘 → 读回验证,就是爬虫五步里的”清洗 + 存储”
二级 · 方法:三个清洗函数 + csv.DictWriter / writerows
三级 · 骨架:for m in raw_movies: m["时长"] = get_movie_cost_time(...)
# 3-1import csv
raw_movies = [ {"电影名": "肖申克的救赎", "年份": ["肖申克的救赎 (1994)"], "上映时间": ["1994-09-23 (CN)"], "时长": ["2h 22m"]}, {"电影名": "教父", "年份": ["教父 (1972)"], "上映时间": ["1972-03-24 (US)"], "时长": ["2h 55m"]}, {"电影名": "悬崖上的金鱼姬", "年份": ["悬崖上的金鱼姬 (2008)"], "上映时间": ["2008-07-19 (JP)"], "时长": ["1h 40m"]},]
movies = []for m in raw_movies: movies.append({ "电影名": m["电影名"], "年份": get_movie_year(m["年份"]), "上映时间": get_movie_publish_date(m["上映时间"]), "时长": get_movie_cost_time(m["时长"]), })
with open("movie_list_test.csv", "w", encoding="utf-8", newline="") as f: writer = csv.DictWriter(f, fieldnames=["电影名", "年份", "上映时间", "时长"]) writer.writeheader() writer.writerows(movies)
with open("movie_list_test.csv", "r", encoding="utf-8") as f: for row in csv.DictReader(f): print(row)如果你喜欢,那么欢迎来到我的世界!
了解更多暂未播放