国庆节10月1日
--

数据分析的定义与流程、数据清洗的四个动作,以及 Jupyter Notebook 是什么、和普通 .py 文件的区别
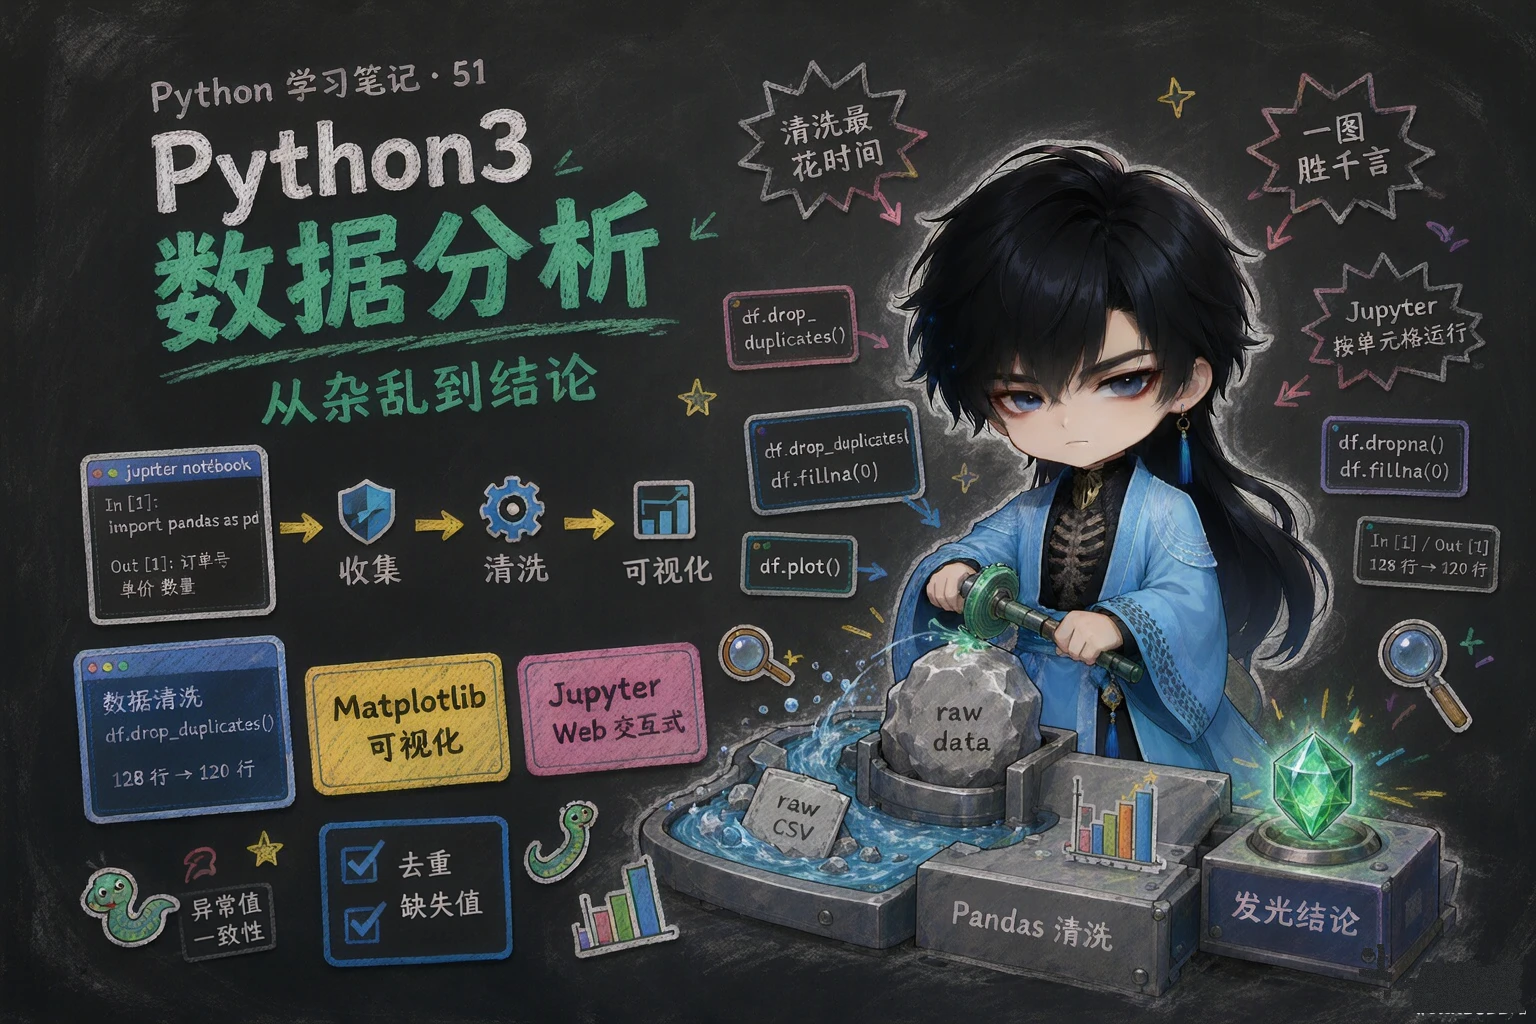
数据分析:从一堆看似杂乱的数据中,通过数据清洗、分析、可视化等手段,找出有价值的信息和结论,从而帮我们解决实际的问题。
常见场景:用户订单数据分析、电影榜单数据分析、学校学生成绩分析。
数据收集 → 数据清洗处理 → 数据可视化 → 数据分析| 环节 | 干什么 | 用什么 |
|---|---|---|
| 数据收集 | 拿到原始数据(CSV、Excel、数据库、网络) | — |
| 数据清洗处理 | 去除重复数据、处理缺失值、处理异常值、一致性检查 | Pandas |
| 数据可视化 | 把数据画成图,一图胜千言 | Matplotlib |
| 数据分析 | 从图和统计结果里得出结论 | 人的判断 |
数据分析里清洗往往是最花时间的一步——数据脏,后面的统计和图表都会跟着错。
Jupyter Notebook 是一个基于 Web 网页的、交互式的编程笔记本,让你可以把代码、运行结果、图表和笔记全部都放在一个文件里(在数据分析、机器学习、教学和科研等领域很常用)。
| 对比 | Python 文件(.py) | Jupyter 文件(.ipynb) |
|---|---|---|
| 运行方式 | 整个文件从头跑到尾 | 按单元格逐个运行,随时看结果 |
| 结果 | 打印到终端 | 直接显示在单元格下方(含表格、图表) |
| 适合 | 写脚本、程序 | 探索式分析:一边试一边看 |
用 PyCharm 第一次打开 .ipynb 时,会自动联网下载 Jupyter 相关软件包,等它装完即可。
.ipynb)与 Python 文件最大的不同是:可以按单元格逐个运行2-1 为什么说”清洗”是数据分析里最花时间的一步?举一个脏数据会带坏结论的例子
一级 · 思路:从”真实数据长什么样”出发想:缺的、重的、错的、格式乱的都要人工判断怎么处理;例子挑一个能直接影响统计结果的毛病
2-1 因为真实数据总有缺失、重复、异常、格式不统一,必须先修好才能统计。例:单价里有负数(录入错误),直接算”平均单价”或”销售金额合计”就会被拉低,结论自然是错的。
2-2 什么情况下用 Jupyter 比用 .py 脚本更合适?举两个场景
一级 · 思路:想 Jupyter 的两大特点——“按单元格随时看结果”和”代码/图表/文字放在一起”,各对应一类场景
2-2 ① 探索式分析:不知道数据长什么样,想一段一段试、边看结果边决定下一步;② 出报告/教学:代码、图表、文字说明放在一个文件里,别人打开就能看懂并复现。
2-3 拿到一份销售订单 CSV,你会按哪四步去清洗它?
一级 · 思路:按”重复值 → 缺失值 → 异常值 → 格式一致性”的顺序过一遍,每一步想一个针对订单数据的做法
2-3 ① 去重(按订单号);② 处理缺失值(删除或填充);③ 处理异常值(如单价为负,取绝对值或删掉);④ 一致性检查(日期格式 2025/06/01 统一成 2025-06-01)。
如果你喜欢,那么欢迎来到我的世界!
了解更多暂未播放