国庆节10月1日
--

Pandas 的 DataFrame 与 Series 是什么、四种构建方式和常用属性(index/columns/values/shape 等)
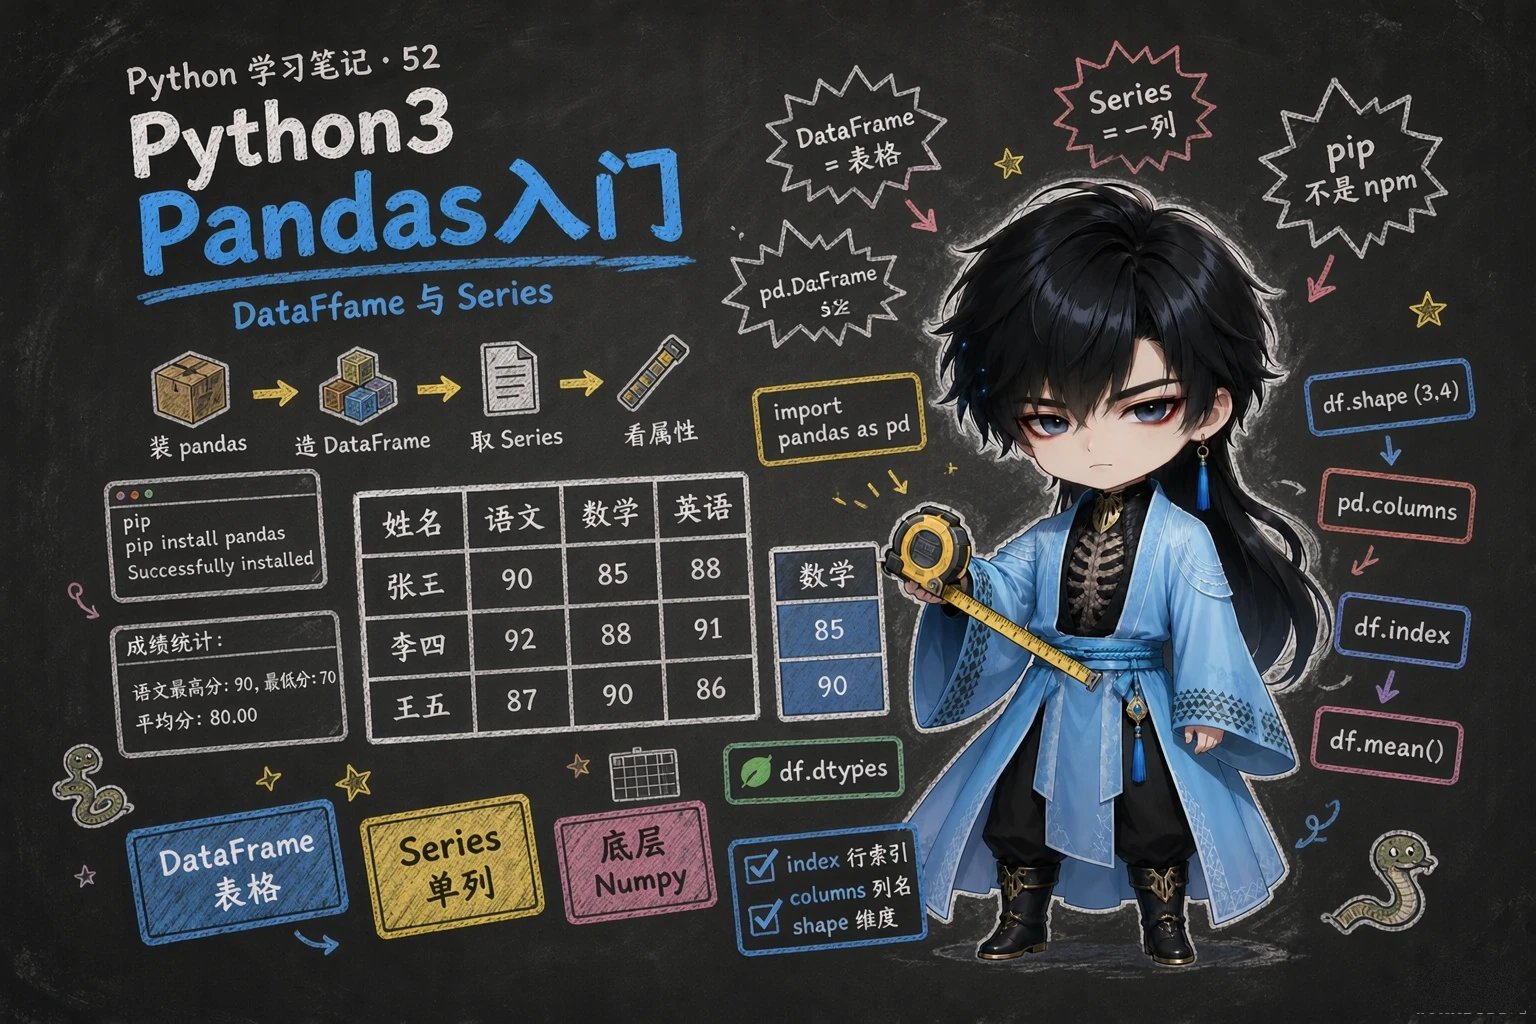
Pandas 是一个功能强大的结构化数据分析工具集,底层基于 Numpy 构建,在数据分析和大数据开发场景中都有显著优势。
安装(注意是 pip,不是 npm):
pip install pandas课程 PPT 上写的 npm install pandas 是笔误——npm 是 Node.js 的包管理器,Python 用 pip。
| 结构 | 是什么 | 类比 |
|---|---|---|
| DataFrame | 表格型的数据结构,有行有列 | 一张 Excel 表格 |
| Series | 一列数据 | DataFrame 中的单独一列 |
概念对应关系:index(索引,行号或行标签)、column(列名)、row(一行)。
需求:基于 Pandas 统计班级学员各科成绩的最高分、最低分、平均分。
import pandas as pd
# 构造 DataFrame —— 创建数据集(学员成绩信息)df = pd.DataFrame([ {"姓名": "小王", "语文": 90, "数学": 80, "英语": 70}, {"姓名": "小李", "语文": 80, "数学": 90, "英语": 80}, {"姓名": "小张", "语文": 70, "数学": 80, "英语": 90},])
# 统计计算print(f"语文最高分: {df['语文'].max()}, 最低分: {df['语文'].min()}, 平均分: {df['语文'].mean():.2f}")print(f"数学最高分: {df['数学'].max()}, 最低分: {df['数学'].min()}, 平均分: {df['数学'].mean():.2f}")print(f"英语最高分: {df['英语'].max()}, 最低分: {df['英语'].min()}, 平均分: {df['英语'].mean():.2f}"):.2f 表示保留两位小数。取出一列后,max() / min() / mean() 这些统计方法直接就能用。
import pandas as pd
# 1. 列表套字典:每个字典是一行df1 = pd.DataFrame([ {'姓名': '王林', '语文': 80, '英语': 90, '数学': 88}, {'姓名': '李慕婉', '语文': 92, '英语': 81, '数学': 93},])
# 2. 字典套列表:键是列名,值是该列的数据df2 = pd.DataFrame({ '姓名': ['王林', '李慕婉'], '语文': [80, 92], '英语': [90, 81], '数学': [88, 93],})
# 3. 列表套元组 + columns 指定列名df3 = pd.DataFrame([ ('王林', 80, 90, 88), ('李慕婉', 92, 81, 93),], columns=['姓名', '语文', '英语', '数学'])
# 4. 在 3 的基础上再指定自定义行索引df4 = pd.DataFrame([ ('王林', 80, 90, 88), ('李慕婉', 92, 81, 93),], columns=['姓名', '语文', '英语', '数学'], index=['a', 'b'])| 属性 | 作用 |
|---|---|
df.index | 获取行索引 |
df.columns | 获取列名(DataFrame 特有) |
df.values | 获取值(二维数组) |
df.size | 获取单元格的数量 |
df.dtypes | 获取每一列的数据类型 |
df.shape | 获取数据维度(行, 列) |
import pandas as pd
s1 = pd.Series([10, 20, 30, 40, 50]) # 列表s2 = pd.Series((10, 20, 30, 40, 50), index=['a', 'b', 'c', 'd', 'e']) # 元组 + 自定义索引s3 = pd.Series({'a': 10, 'b': 20, 'c': 30}) # 字典s4 = df1['语文'] # 从 DataFrame 里取一列| 属性 | 作用 |
|---|---|
s.index | 获取索引 |
s.values | 获取值 |
s.dtype | 获取数据类型(Series 是单数 dtype) |
s.size | 获取数据个数 |
s.shape | 获取数据维度(行,)——只有一个维度 |
记法:DataFrame 有 columns、类型是 dtypes(复数);Series 没有 columns、类型是 dtype(单数)。
pip install pandasdf.columns、取维度用 df.shape、取单元格数量用 df.size、取每列类型用 df.dtypess.dtype(单数),DataFrame 用 df.dtypes(复数)df['语文'].mean() 求平均分;max() 求最大值、min() 求最小值columns 指定列名,用参数 index 指定行索引 2-1 构造 DataFrame
用”字典套列表”的方式造一个 3 名学员的成绩表(列:姓名、语文、数学),打印 shape 和 columns。
一级 · 思路:列名当字典的键,每列的数据当值
二级 · 方法:pd.DataFrame({...})
三级 · 骨架:df = pd.DataFrame({"姓名": [...], "语文": [...], "数学": [...]})
# 2-1import pandas as pd
df = pd.DataFrame({ "姓名": ["小王", "小李", "小张"], "语文": [90, 80, 70], "数学": [80, 90, 80],})print(df.shape) # (3, 3)print(df.columns.tolist()) # ['姓名', '语文', '数学']2-2 取属性 对上面造出的表,分别打印:行索引、列名、值、单元格数量、每列类型、维度。
一级 · 思路:六个属性各一行
二级 · 方法:index / columns / values / size / dtypes / shape
三级 · 骨架:print(df.index.tolist())(转成列表看得更清楚)
# 2-2print(df.index.tolist()) # [0, 1, 2]print(df.columns.tolist())print(df.values.tolist())print(df.size) # 9print(df.dtypes)print(df.shape) # (3, 3)2-3 统计一列 取出”语文”这一列,打印最高分、最低分、平均分(平均分保留两位小数)。
一级 · 思路:先取列,再用统计方法
二级 · 方法:df['语文'].max() / .min() / .mean()
三级 · 骨架:f"{df['语文'].mean():.____}" 保留两位小数
# 2-3print(f"最高分: {df['语文'].max()}, 最低分: {df['语文'].min()}, 平均分: {df['语文'].mean():.2f}")如果你喜欢,那么欢迎来到我的世界!
了解更多暂未播放