国庆节10月1日
--

爬虫的定义与应用场景、工作流程五步、数据清洗,以及 robots 协议(君子协定)的规则字段
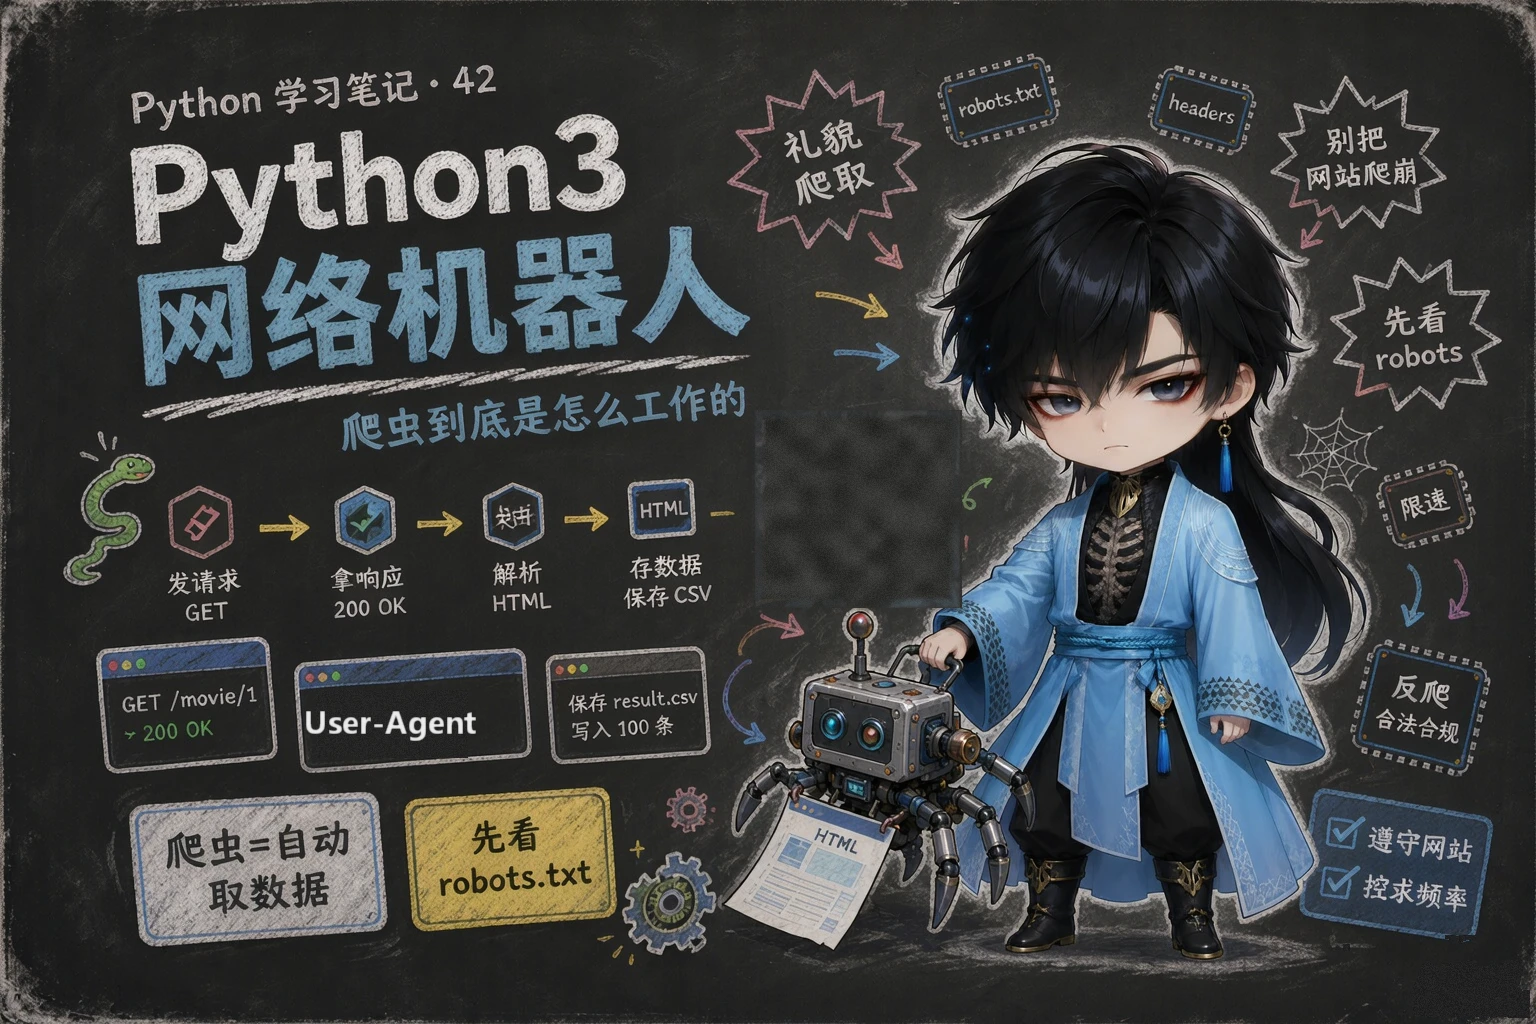
爬虫:也称为网络爬虫(网络机器人),是一种按照一定的预设规则,自动浏览并抓取网络数据的程序或脚本。
常见的应用场景:
| 场景 | 例子 |
|---|---|
| 搜索引擎 | 百度、Google 的网页收录 |
| 舆情监控 | 抓取社交平台上的公开讨论做分析 |
| 商业分析 | 电商比价系统 |
| AI 大模型训练语料 | 大规模采集公开文本 |
开始 → 发送HTTP请求 → 解析结果提取数据 → 数据处理(清洗) → 数据存储 → 结束数据清洗:对采集到的原始数据进行处理、修正、转换和标准化的过程,目的是让数据变得规范、准确。比如把 2h 20m 统一换算成 140 分钟。
robots 协议也称为爬虫协议、爬虫规则,是指网站根目录下存放的一份文本文件 robots.txt,用于告诉爬虫哪些页面可以抓取、哪些不能抓取。
它叫”君子协定”是因为没有强制力——全凭爬虫自觉遵守。但请务必遵守:网站把它放在那里,就是明确表达了”哪些内容欢迎你来抓”。
一份 robots.txt 长这样(节选自真实网站):
User-agent: * # 通用规则(针对所有爬虫)Disallow: /wp-admin/Allow: /wp-admin/admin-ajax.phpSitemap: https://www.tiobe.com/sitemap_index.xmlCrawl-delay: 5
User-agent: Wandoujia Spider # 特定规则(只针对豌豆荚爬虫)Disallow: /
User-agent: Mediapartners-Google # 特定规则(只针对谷歌广告爬虫)Disallow: /subject_search| 字段 | 含义 |
|---|---|
User-agent | 用户代理,通过这个标识确认爬虫的身份 |
Disallow | 不允许访问的资源 |
Allow | 允许访问的资源 |
Sitemap | 网站地图,帮助爬虫更高效地获取网站内容 |
Crawl-delay | 爬取间隔时间(秒),避免频繁访问把网站压垮 |
robots.txt,放在网站的根目录下User-agent、Disallow、Allow、Sitemap、Crawl-delayCrawl-delay: 5 的含义是爬取间隔 5 秒(避免频繁访问给网站造成压力)口头答得出来即可。
2-1 爬虫的工作流程五步,按顺序说出来;并解释”数据清洗”为什么要放在”解析”之后
一级 · 思路:按”发出请求 → 拿到数据 → 清洗处理 → 存储”这条链路回想五步;清洗动的是数据本身,所以必须先有提取出来的原始数据
2-1 发送 HTTP 请求 → 解析结果提取数据 → 数据处理(清洗) → 数据存储。清洗放在解析之后,因为只有先从网页里把原始数据提取出来,才谈得上修正和标准化。
2-2 robots.txt 里 User-agent: * 和 User-agent: Mediapartners-Google 的区别是什么?
一级 · 思路:看这一栏写的是通配符还是一个具体的爬虫名字,再想这条规则会落到谁头上
2-2 * 是通用规则,对所有爬虫生效;指定名字的规则只对那个爬虫生效(比如谷歌广告爬虫)。当规则冲突时,更具体的规则优先。
2-3 如果你写的爬虫每秒请求目标网站 100 次,违反了 robots.txt 的哪个字段?可能造成什么后果?
一级 · 思路:五个字段里哪一个管”访问间隔/频率”?再站到对方服务器的角度想:短时间被大量请求会怎样
2-3 违反 Crawl-delay(访问间隔)。后果:给对方服务器造成很大压力,轻则被封 IP / 封 User-Agent,重则影响网站正常用户访问。
如果你喜欢,那么欢迎来到我的世界!
了解更多暂未播放