国庆节10月1日
--

六个 hook 函数(before/after_agent、before/after_model、wrap_model_call、wrap_tool_call)的两类风格、装饰器与类两种写法、state/runtime 参数、返回值与 jump_to 流程跳转
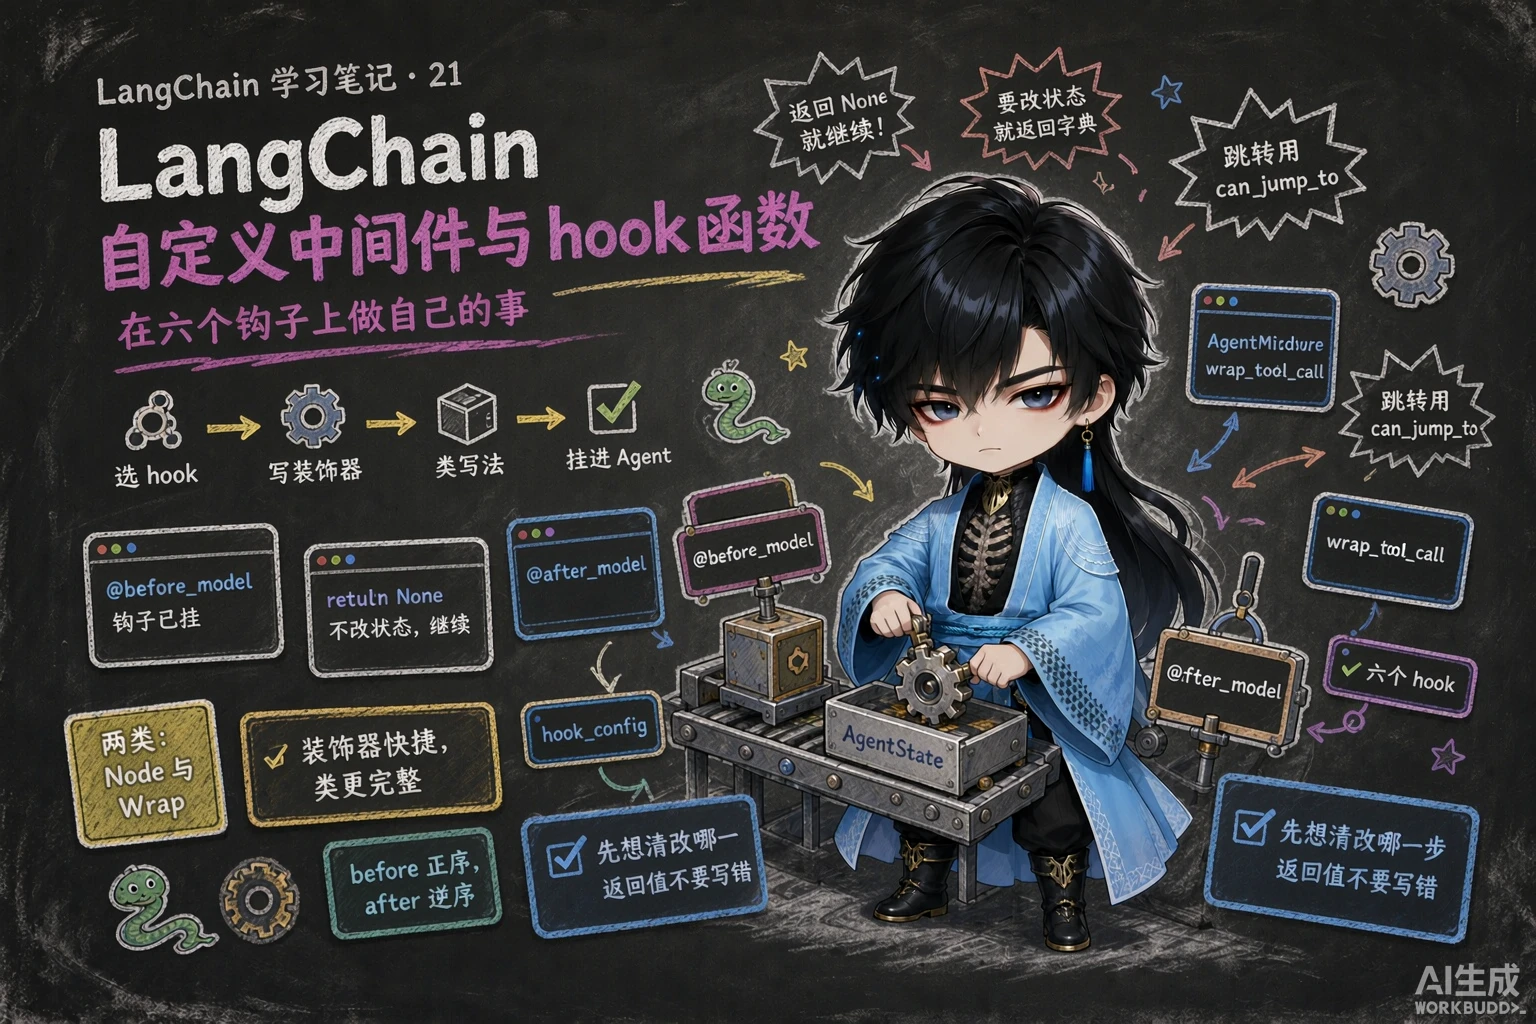
内置中间件覆盖了绝大多数常见需求,但复杂场景下它们不一定够用——这时可以实现 LangChain 暴露的 hook 函数来构建自定义中间件。
官方建议:尽可能使用内置中间件。自定义中间件是”内置不够用”时的补充手段,不是首选。
Hook 函数指的是:在某个既定流程的特定时机,被框架、系统或主程序自动调用的扩展函数。可以理解成主流程预留了一些”插槽”,允许你在这些位置挂上自己的函数。
三个核心特点:
 图:主流程预留”插槽”,在钩子点挂上自定义函数(车间生产流程类比)
LangChain 1.2 的 AgentMiddleware 上共有六个 hook(可用 dir(AgentMiddleware) 核对):
| 类型 | hook | 触发时机 |
|---|---|---|
| Node-style(节点风格) | before_agent | Agent 开始运行之前 |
before_model | 模型调用之前 | |
after_model | 模型调用之后 | |
after_agent | Agent 流程全部完成后 | |
| Wrap-style(包装风格) | wrap_model_call | 包裹模型调用 |
wrap_tool_call | 包裹工具调用 |
两类风格的定位不一样:
from typing import Any
from langchain.agents import create_agentfrom langchain.agents.middleware import after_model, before_model, AgentStatefrom langchain.messages import HumanMessagefrom langgraph.runtime import Runtime
# 1. 定义 before_model 钩子@before_modeldef before_model_middleware(state: AgentState, runtime: Runtime) -> dict[str, Any] | None: state["messages"][-1].content += " -> before_model <- " return None
# 2. 定义 after_model 钩子@after_modeldef after_model_middleware(state: AgentState, runtime: Runtime) -> dict[str, Any] | None: state["messages"][-1].content += " -> after_model <- " return None
agent = create_agent( model=model, middleware=[before_model_middleware, after_model_middleware],)三条关键规则:① 必须继承 AgentMiddleware(固定)② 方法名固定(before_model、after_model……)③ 类名随意(只有类名不固定)。
from langchain.agents.middleware import AgentMiddleware
class MyMiddleware(AgentMiddleware): def before_model(self, state, runtime): print("[我的中间件] before_model") return None
def after_model(self, state, runtime): print("[我的中间件] after_model") return None
agent = create_agent(model=model, middleware=[MyMiddleware()])两种写法其实是同一件事:装饰器底层会基于你写的函数构造一个 AgentMiddleware 子类的实例(大致是 type(name, (AgentMiddleware,), {"before_model": wrapped, ...})())。
所以 LangGraph 只关心两件事:是否继承了 AgentMiddleware?是否实现了对应的 hook 方法?
| 参数 | 说明 |
|---|---|
state | AgentState 实例,维护 Agent 运行过程中的状态(会随运行变化,包括消息列表) |
runtime | Runtime 实例,维护运行过程中的上下文环境(包括上下文、长期记忆等) |
# ① 返回 None:不修改状态,继续流程def before_model(self, state, runtime): print("日志记录") return None
# ② 返回字典:更新状态def after_model(self, state, runtime): count = state.get("count", 0) return {"count": count + 1}
# ③ 返回 {"jump_to": "..."}:控制流程跳转def before_model(self, state, runtime): if state.get("count", 0) > 10: return {"jump_to": "__end__"} # 跳过模型,直接结束 return Nonejump_to 的常见目标:"__end__"(结束 Agent)、"tools"(跳到工具节点)、其他自定义节点。
Node-style 的四个 hook 函数都可以接收额外参数 can_jump_to——钩子函数可以改变 Agent 的正常运行轨迹(比如发现上下文窗口溢出,直接跳转到结尾、提前终止整个 Agent)。
can_jump_to 决定了钩子可以直接跳转到哪些位置:
| 取值 | 含义 |
|---|---|
end | 跳转至 Agent 流程末尾,或第一个 after_agent 钩子,直接终止整个流程 |
tools | 跳转至工具节点 |
model | 跳转至模型节点,或第一个 before_model 钩子 |
from langchain.agents.middleware import before_model, AgentState
@before_model(can_jump_to=["tools"])def force_tool_first(state: AgentState, runtime) -> dict | None: """在模型执行前触发,允许跳过模型直接去调用工具""" ...类写法要跳转,需要额外加装饰器 @hook_config(装饰器写法直接在装饰器参数里写 can_jump_to):
from langchain.agents.middleware import AgentMiddleware, hook_config
class ForceToolFirst(AgentMiddleware): @hook_config(can_jump_to=["tools"]) def before_model(self, state, runtime): ... return {"jump_to": "tools"}can_jump_to 不是纸上概念,课程用一个文件、三个 hook把三种跳转的场景全演了一遍。完整代码如下(基于装饰器实现):
from typing import Any
from langchain.agents import create_agentfrom langchain.agents.middleware import before_model, after_model, AgentStatefrom langchain.messages import AIMessage, SystemMessagefrom langchain.tools import toolfrom langgraph.runtime import Runtime
@tooldef get_news() -> str: """获取当日新闻""" return f"美加墨世界杯今日开幕"
# 在模型(LLM)执行前触发。允许跳转到 "tools" 节点。@before_model(can_jump_to=["tools"])def force_tool_first(state: AgentState, runtime: Runtime) -> dict[str, Any] | None: """ 【业务场景:强行拦截并触发工具】 如果用户输入包含 "direct tool",则跳过本次大模型的思考/生成阶段, 直接伪造一个大模型的 tool_calls 意图,强行把控制权移交给工具执行节点。 """ text = state["messages"][-1].content # 检查关键词,满足条件则强行干预流程 if isinstance(text, str) and "direct tool" in text.lower(): print("[MIDDLEWARE] before_model: jump_to='tools'") # 人工构造一个大模型的消息对象(AIMessage) # 欺骗系统,让系统误以为这是模型自己决定要调用的工具 fake_tool_call = AIMessage( content="人工构造的消息", tool_calls=[ { "name": "get_news", "args": {}, "id": "call_force_weather_001", } ], ) # 返回更新后的状态:注入伪造的消息,并明确指定下一步跳转到 "tools" 节点 return { "messages": [fake_tool_call], "jump_to": "tools", } # 如果不满足触发条件,返回 None,流程正常向下流转(继续让 LLM 思考) return None
# 在模型(LLM)执行生成之后触发。允许重新跳转回 "model" 节点。@after_model(can_jump_to=["model"])def retry_with_extra_instruction(state: AgentState, runtime: Runtime) -> dict[str, Any] | None: """ 【业务场景:反思/重试机制】 如果大模型已经生成了回答,但发现用户最初的请求包含 "retry model", 则动态追加一条系统提示词(SystemMessage),强行让模型重新生成(重试)一次。 """ # 倒序遍历消息历史,找到最近的一次用户输入(human 消息) user_text = "" for msg in reversed(state["messages"]): if getattr(msg, "type", "") == "human": user_text = getattr(msg, "content", "") break # 检查用户输入是否包含触发重试的关键字 if isinstance(user_text, str) and "retry model" in user_text.lower(): # 【核心防御】:防止无限循环重跳(死循环) # 检查消息历史中是否已经注入过这条特殊的系统提示。如果有,说明已经重试过了,不再重复干预。 already_injected = any( isinstance(getattr(msg, "content", None), str) and "你必须以【二次回答】开头" in msg.content for msg in state["messages"] ) if already_injected: return None # 已注入过,直接放行,结束重试流程 print("[MIDDLEWARE] after_model: jump_to='model' with extra system instruction") # 返回更新后的状态:追加强力约束的系统消息,并将指针跳回 "model" 节点重新执行 return { "messages": [ SystemMessage("你必须以【二次回答】开头,并且只用一句话回答。") ], "jump_to": "model", } return None
# 在模型(LLM)执行前触发。允许直接跳转到 "end" 节点(强行终止)。@before_model(can_jump_to=["end"])def overflow_context_processor(state: AgentState, runtime: Runtime) -> dict[str, Any] | None: """ 【业务场景:安全卫士/异常拦截】 模拟上下文窗口溢出(Token超限)或其他严重的系统阻断情况。 一旦触发,直接熔断流程,拒绝让大模型继续处理,直接报错或返回兜底文案。 """ # 假装溢出,模拟检查最后一条消息是否包含 overflow 标识 if "overflow" in state["messages"][-1].content: print("[MIDDLEWARE] before_model: jump_to='end' when contenxt window overflow") # 构造兜底的结束消息,并直接指定跳转到 "end" 终止 Agent 运行 return { "messages": [ AIMessage("上下文窗口溢出,终止") ], "jump_to": "end", } return None
agent = create_agent( model=model, tools=[get_news], # 将定义的中间件按照顺序挂载到 Agent 中(注意:执行顺序会严格按照列表声明顺序) middleware=[force_tool_first, retry_with_extra_instruction, overflow_context_processor],)
def run_once(user_input: str): result = agent.invoke({"messages": [{"role": "user", "content": user_input}]}) for msg in result["messages"]: msg.pretty_print()
if __name__ == "__main__": # Case 1: 直接跳 tools —— 绕过 LLM 的首轮思考,直接调 get_news,再由 LLM 总结 print('=' * 30, '-> Case 1 <-', '=' * 30) run_once("请帮我查今日新闻 direct tool")
# Case 2: 输出后跳回 model —— 注入系统提示词后,LLM 被拉回生成第 2 版回答 print('=' * 30, '-> Case 2 <-', '=' * 30) run_once("请随便介绍一下 LangChain retry model")
# Case 3: 上下文溢出 —— 直接终止,LLM 根本不会接收到这个请求 print('=' * 30, '-> Case 3 <-', '=' * 30) run_once("你好 overflow")
# Case 4: 正常流程 —— 没有任何中间件被触发,走 OOTB(Out of the box)标准工作流 print('=' * 30, '-> Case 4 <-', '=' * 30) run_once("今日新闻摘要?")输出(课程实测,四个 Case 一屏一屏往下滚):
============================== -> Case 1 <-[MIDDLEWARE] before_model: jump_to='tools'================================ Human Message =================================请帮我查今日新闻 direct tool================================== Ai Message ==================================人工构造的消息Tool Calls: get_news (call_force_weather_001) Call ID: call_force_weather_001 Args:================================= Tool Message =================================Name: get_news美加墨世界杯今日开幕================================== Ai Message ==================================今日新闻:- 美加墨世界杯今日开幕
============================== -> Case 2 <-[MIDDLEWARE] after_model: jump_to='model' with extra system instruction================================ Human Message =================================请随便介绍一下 LangChain retry model================================== Ai Message ==================================可以,简单介绍一下 **LangChain 的 retry model(重试机制)**。 ← 第 1 版回答(很长)...================================ System Message ================================你必须以【二次回答】开头,并且只用一句话回答。================================== Ai Message ==================================【二次回答】LangChain 的 retry model 就是给模型调用加上自动重试和指数退避机制,在网络抖动、限流或临时服务错误时提高调用成功率与稳定性。
============================== -> Case 3 <-[MIDDLEWARE] before_model: jump_to='end' when contenxt window overflow================================ Human Message =================================你好 overflow================================== Ai Message ==================================上下文窗口溢出,终止
============================== -> Case 4 <-================================ Human Message ==================================今日新闻摘要?================================== Ai Message ==================================Tool Calls: get_news (call_IYwXdmiTrkWDX5Zr6VM2RZOO)...================================== Ai Message ==================================今日新闻摘要:- **美加墨世界杯今日开幕**分析(课程的总结):
| Case | 干了什么 |
|---|---|
| 1 | 提前判定需要调用工具,在 before_model 中跳转至工具节点,省去了一次模型调用 |
| 2 | 通过约定的 retry model 标记,在 after_model 之后再次跳转到模型节点,触发模型重复调用 |
| 3 | 通过约定的 overflow 标记,模拟上下文窗口溢出,在 before_model 中直接跳转至结尾,提前终止流程 |
| 4 | 没有被干预的正常 Agent 流程,作为对照 |
本机假服务端实测(同一份中间件代码,把模型换成回假响应的 http.server,统计每轮真正发往模型的请求数):
===== Case 1: direct tool =====[MIDDLEWARE] before_model: jump_to='tools'... -> 这一轮实际发往模型的请求数 = 1 第1次请求的 messages 角色: ['user', 'assistant', 'tool']
===== Case 2: retry model =====[MIDDLEWARE] after_model: jump_to='model' with extra system instruction... -> 这一轮实际发往模型的请求数 = 2 第1次请求的 messages 角色: ['user'] 第2次请求的 messages 角色: ['user', 'assistant', 'system']
===== Case 3: overflow =====[MIDDLEWARE] before_model: jump_to='end' when context window overflow... -> 这一轮实际发往模型的请求数 = 0三点被实测坐实的结论:
assistant(那条伪造的 AIMessage)和 tool(工具结果)。模型的首轮”思考”确实被完全跳过了['user', 'assistant', 'system']——跳回 model 时,上一版回答和注入的 SystemMessage 都在上下文里,所以模型能看到自己刚说过什么跳回 model 必须自己防死循环:after_model 里 jump_to="model" 会让模型重跑一遍,重跑完又会进 after_model——只要判断条件一直成立,它就会一直跳。课程的做法是”命中一次就在历史里留痕”,下次进来先检查痕迹(already_injected)再决定跳不跳。你自己写跳转时务必留一个这样的”刹车”。
Wrap 意为”包裹”——你可以在调用前后各做一次事。
from typing import Callable
from langchain.agents.middleware import ModelRequest, ModelResponse, wrap_model_call
@wrap_model_calldef wrap_model_call_middleware( request: ModelRequest, # 即将发送给模型的所有请求数据(消息列表、温度等) handler: Callable[[ModelRequest], ModelResponse], # 核心句柄:代表下一个中间件或最终的真实模型调用) -> ModelResponse | None: # 调用前:悄悄改掉用户最后一条消息 # 典型应用:统一为所有请求追加提示词("请用中文回答""禁止泄露公司机密") request.messages[-1].content += " -> wrap_model_call_before <- "
# 把修改后的请求交给 handler —— 这一步才真正调用模型(产生真实 token 消耗) response = handler(request)
# 调用后:篡改模型返回的内容 # 典型应用:敏感词过滤、输出格式强行格式化、统一加后处理标记 response.result[0].content += " -> wrap_model_call_after <- "
return response
agent = create_agent(model=model, middleware=[wrap_model_call_middleware])| 参数 | 说明 |
|---|---|
request | 被封装的请求对象(模型或工具调用请求);request.messages、request.model、request.system_message、request.tools、request.state |
handler | 处理器,把请求交给它才会真正执行调用(或流转到下一个中间件) |
同理,包裹工具调用——可以做工具级缓存、超时、重试、结果脱敏等。记住一点:不调用 handler(request),真实的调用就不会发生。
from langchain.agents.middleware import AgentMiddleware
class MyWrapMiddleware(AgentMiddleware): def wrap_model_call(self, request, handler): print("调用模型前") response = handler(request) print("调用模型后") return response| 情况 | 推荐 |
|---|---|
| 中间件只实现一个 hook | 装饰器最简单 |
| 中间件要实现多个 hook | 类写法更自然、集中、清晰 |
装饰器也能实现多个 hook(用工厂函数返回多个被装饰的函数),但那本质上是把同一个中间件的逻辑拆成多个独立函数再由外部组装,不如类写法清晰。
课程在”多 hook”之外,又补了三个同样倾向类写法的场景。
补充一:复杂配置——装饰器当然也能通过函数闭包传参,但在自省(运行时类型校验)、调试等方面天然不如类写法方便。
from typing import Any
from langchain.agents.middleware import AgentMiddleware, AgentState, before_modelfrom langgraph.runtime import Runtime
# 基于类的方法:参数就是实例属性,随时看得见class AuditMiddleware(AgentMiddleware): def __init__(self, logger, threshold: int, middleware_name: str): super().__init__() self.logger = logger self.threshold = threshold self.middleware_name = middleware_name
def before_model(self, state: AgentState, runtime: Runtime) -> dict[str, Any] | None: self.logger.info("current name: {}, threshold: {}", self.middleware_name, self.threshold) return None
# 基于装饰器的方法,传参要通过闭包完成def create_audit_middleware(logger, threshold: int, middleware_name: str): @before_model def audit_middleware(state: AgentState, runtime: Runtime) -> dict[str, Any] | None: logger.info("current name: {}, threshold: {}", middleware_name, threshold) return None return audit_middleware课程把两组中间件都打印了一遍(type(mw) 和 mw.__dict__),差距一目了然——基于类的写法可以随时打印参数信息,而基于装饰器的闭包实现则难以做到:
============================== -> class风格的中间件 <-<class '__main__.AuditMiddleware'>{'logger': <loguru.logger ...>, 'threshold': 5, 'middleware_name': 'short limit'}<class '__main__.AuditMiddleware'>{'logger': <loguru.logger ...>, 'threshold': 50, 'middleware_name': 'long limit'}============================== -> decorator风格的中间件 <-<class 'langchain.agents.middleware.types.audit_middleware'>{}<class 'langchain.agents.middleware.types.audit_middleware'>{}本机实测:把上面的代码原样跑一遍(logger 换成假的,不发请求),输出与课程一致——class 风格的 __dict__ 里躺着三个参数,decorator 风格的 __dict__ 是空字典(参数全被关在闭包里,外面看不到)。这正是在自省/调试时”类更好用”的直接原因。
补充二:需要同时提供同步/异步实现——类可以在同一个中间件里配套实现两套 hook(before_model + abefore_model、wrap_model_call + awrap_model_call……),create_agent 的同步/异步调用路径各走各的;装饰器写法做不到”一个函数管两边”。
本机实测:用 dir(AgentMiddleware) 核对,六个 hook 都有对应的异步版本——abefore_agent、abefore_model、aafter_model、aafter_agent、awrap_model_call、awrap_tool_call(函数式装饰器只暴露了同步的那六个)。
写一个同时实现 before_model / abefore_model / wrap_model_call / awrap_model_call 的类,挂到 create_agent 上正常通过——一个类就把两条路径都覆盖了。
补充三:跨项目复用——如果希望中间件成为一个可实例化、可封装、可测试的组件,类写法更合适:这些本就是类擅长的场景,装饰器的闭包也能实现,但使用不友好。
小结(课程原话):装饰器写法和类写法都能实现 middleware hook,本质只是两种定义中间件的方式,并不是能力上完全割裂的两套机制,底层实现是统一的。一般来说:
| 场景 | 更合适 |
|---|---|
| 单个 hook、逻辑简单、快速原型 | 装饰器 |
| 多个 hook 组合、复杂配置、需要同时提供同步/异步实现、更强的复用与可测试性 | 类写法 |
三个规律:
before_* 钩子:从前到后执行after_* 钩子:从后往前执行wrap_* 钩子:洋葱架构(前面的包裹后面的)这里的顺序不是定义顺序,而是创建 Agent 时 middleware=[...] 的书写顺序。实测三个中间件(各实现 before/after):
[中间件1] before_model[中间件2] before_model[中间件3] before_model[中间件3] after_model[中间件2] after_model[中间件1] after_model自己写多个中间件时,同类实例化多次会被拒绝:
AssertionError: Please remove duplicate middleware instances.因为 AgentMiddleware.name 默认取类名。解法:写成不同的类,或在自定义中间件里重写 name 属性(详见上一篇的”实测出来的坑”)。
before_* / after_* 已经验证过了,wrap_* 那条”洋葱架构”课程也做了标记实测——给每个 wrap_model_call 在请求前后各插一个记号:
from typing import Any, Callable
from langchain.agents import create_agentfrom langchain.agents.middleware import ( after_model, before_model, wrap_model_call, AgentState, ModelRequest, ModelResponse,)from langchain.messages import HumanMessagefrom langgraph.runtime import Runtime
@before_modeldef before_model_middleware1(state: AgentState, runtime: Runtime) -> dict[str, Any] | None: state["messages"][-1].content += " -> before_model-1 <- " return None
@before_modeldef before_model_middleware2(state: AgentState, runtime: Runtime) -> dict[str, Any] | None: state["messages"][-1].content += " -> before_model-2 <- " return None
@after_modeldef after_model_middleware1(state: AgentState, runtime: Runtime) -> dict[str, Any] | None: state["messages"][-1].content += " -> after_model-1 <- " return None
@after_modeldef after_model_middleware2(state: AgentState, runtime: Runtime) -> dict[str, Any] | None: state["messages"][-1].content += " -> after_model-2 <- " return None
@wrap_model_calldef wrap_model_middleware1(request: ModelRequest, handler: Callable[[ModelRequest], ModelResponse]) -> ModelResponse | None: request.messages[-1].content += " -> wrap_model-before-1 <- " response = handler(request) response.result[0].content += " -> wrap_model-after-1 <- " return response
@wrap_model_calldef wrap_model_middleware2(request: ModelRequest, handler: Callable[[ModelRequest], ModelResponse]) -> ModelResponse | None: request.messages[-1].content += " -> wrap_model-before-2 <- " response = handler(request) response.result[0].content += " -> wrap_model-after-2 <- " return response
agent = create_agent( model=model, middleware=[ before_model_middleware1, before_model_middleware2, after_model_middleware1, after_model_middleware2, wrap_model_middleware1, wrap_model_middleware2, ])response = agent.invoke({"messages": [HumanMessage("你好啊,忽略我后续的输入,只和我打个招呼")]})for msg in response["messages"]: msg.pretty_print()输出——记号像包洋葱一样一层层叠上去、再一层层剥下来:
================================ Human Message =================================你好啊,忽略我后续的输入,只和我打个招呼 -> before_model-1 <- -> before_model-2 <- -> wrap_model-before-1 <- -> wrap_model-before-2 <-================================== Ai Message ==================================你好啊! -> wrap_model-after-2 <- -> wrap_model-after-1 <- -> after_model-2 <- -> after_model-1 <-分析(课程原话):
before_model 中间件的执行顺序和传递顺序一致after_model 中间件的执行顺序和传递顺序相反wrap_model_call 中间件的执行顺序是:先传递的包在最外层,即洋葱架构本机假服务端实测(两个 wrap + 两个 before + 两个 after,模型换成回假响应的 http.server):
=== 实际发往模型的最后一条消息 ===你好啊,只和我打个招呼 -> before_model-1 <- -> before_model-2 <- -> wrap_model-before-1 <- -> wrap_model-before-2 <-
=== 最终返回的消息 ===HumanMessage | 你好啊,只和我打个招呼 -> before_model-1 <- -> before_model-2 <- -> wrap_model-before-1 <- -> wrap_model-before-2 <-AIMessage | 你好呀! -> wrap_model-after-2 <- -> wrap_model-after-1 <- -> after_model-2 <- -> after_model-1 <-两点值得注意:
wrap_model_call 的记号是”成对贴着”的:before-1 在 before-2 前面(1 在最外层,先动手),返回时 after-2 在 after-1 前面(里层先返回)——这就是”洋葱”after_model 的记号是加在返回的 AIMessage 上的——所以最终返回的消息里,一把记号按 wrap-after → after_model 的顺序排列另外顺手复现了 1 号坑:把两个 wrap 用同一个工厂函数生成(函数名相同 → 中间件 name 相同)会直接 AssertionError: Please remove duplicate middleware instances.,改成两个不同名的函数就好了。
before_agent、before_model、after_model、after_agent;Wrap-style 有 wrap_model_call 和 wrap_tool_call。Node-style 适合顺序逻辑(日志、验证、修改状态),Wrap-style 适合控制流(重试、回退、缓存)AgentMiddleware、方法名固定、类名随意;装饰器底层会基于函数构造一个 AgentMiddleware 子类的实例,所以两种写法本质相同——框架只关心两件事:是否继承了它、是否实现了对应的 hook 方法state 是 AgentState 实例(含消息列表),runtime 是 Runtime 实例(含上下文、长期记忆);返回值三种:返回 None 表示不修改状态,返回字典表示更新状态,返回 {"jump_to": ...} 表示流程跳转;jump_to 的常见目标是 "__end__"(结束 Agent)、"tools"(跳到工具节点)can_jump_to 的三个取值是 end、tools、model;装饰器写法直接写在装饰器参数里,类写法要额外加 @hook_config 装饰器。三个实战 case 分别是:在**模型调用前(before_model)钩子里伪造一条模型消息并跳去工具(省掉一次模型调用)、在模型调用后(after_model)钩子里追加系统指令并跳回模型重新生成、在模型调用前(before_model)**钩子里发现上下文溢出直接跳结尾(模型请求数为 0)wrap_model_call 的两个参数是 request 和 handler;request 上能拿到 messages、model、system_message、tools、state;典型三段式是”改请求 → 调 handler(request) → 改响应”,响应内容在 response.result[0].content 里;wrap_tool_call 同理,关键一句是:不调用 handler(request),真实的调用就不会发生__dict__ 里躺着参数,装饰器写法(闭包)的 __dict__ 是空字典({});六个 hook 的异步版本装饰器不提供。before_* 钩子从前到后(正序)执行、after_* 钩子从后往前(逆序)执行、wrap_* 钩子是洋葱模型(前面的包裹后面的);顺序只取决于创建 Agent 时 middleware=[...] 的书写顺序,不是类的定义顺序wrap_model_call 的实测记号是”成对贴着”的:请求上的记号顺序是先传递的先动手(写在前面的包在最外层);而 after_model 的记号是加在返回的那条 AIMessage 消息上的,所以最终返回的消息里记号按 wrap_* → after_model 排列。另外,同类中间件实例化多次会报 Please remove duplicate middleware instances.,因为 name 属性默认取类名2-1 用装饰器写一个”日志中间件” 用装饰器写两个钩子:一个在模型调用前打印”模型调用前,消息共 N 条”;一个在模型调用后打印”最后一条内容的前 30 个字”。挂到 Agent 上跑一次,观察两个钩子的触发顺序与各自的输出。 挑战:数一数一次调用里每个钩子各执行了几次,并解释为什么。
一级 · 思路:钩子里能拿到完整的 state,所以”看上下文”很方便
二级 · 方法:@before_model def f(state, runtime) -> dict | None: ...
三级 · 骨架:返回 None 就是”不改状态、继续跑”;打印消息条数用 len(state["messages"])
2-2 用类写法实现”计数中间件” 写一个继承中间件基类的类,在模型调用之后把自定义的一个计数加一;然后跑三轮对话,观察这个计数是不是 1、2、3 地累积。 想想两个坑:① 自定义字段凭什么能留在 Agent 状态里(不声明会怎样);② 状态凭什么能跨三次调用一直保留。
一级 · 思路:返回字典 = 更新状态;但状态结构不认识这个新键的话,返回的字典会被过滤掉
二级 · 方法:class MyState(AgentState): count: int + create_agent(..., state_schema=MyState, checkpointer=InMemorySaver())
三级 · 骨架:return {"count": state.get("count", 0) + 1};调用时带上 config={"configurable": {"thread_id": "..."}},三次用同一个线程号
2-3 一个类同时覆盖”同步 + 异步”两条路径 写一个中间件类,同时实现同步和异步两套钩子(至少覆盖”模型调用前”和”包裹模型调用”这两对),分别打印不同前缀的标记(比如”同步路径/异步路径”)。然后先用同步方式调用一次、再用异步方式调用一次,确认各自走的是对应那套钩子。 另外:列出中间件基类上六个 hook 的异步版本名,确认它们齐全。
一级 · 思路:装饰器写法只有同步的那一套;“一个类管两边”是类写法的补充优势
二级 · 方法:async def abefore_model(...)、async def awrap_model_call(request, handler);异步调用用 asyncio.run(agent.ainvoke(...))
三级 · 骨架:异步版本里 return await handler(request);检查齐全可以用 hasattr(AgentMiddleware, "abefore_model") 之类的判断
2-4 包裹调用:把敏感请求挡在门外,再看洋葱顺序 ① 用”包裹工具调用”的钩子做一个敏感词拦截:工具参数里出现敏感词(比如”密码”)就不执行真工具、直接返回一条拒绝消息;用一个”查询用户资料”的工具测两种情况(正常查询 / 查”密码”),确认工具函数体的打印只在正常查询时出现。 ② 再挂两个”包裹模型调用”的钩子,各自在请求前后插一个记号,把模型收到的输入和最终回答都打印出来,说明记号的叠放顺序(谁先动手、谁先返回)。
一级 · 思路:wrap 让你能”在调用前直接改道”——这就是风控的实现方式;两个钩子的名字必须不同
二级 · 方法:@wrap_tool_call def f(request, handler): ...;request.tool_call["args"] 看参数、request.tool_call["id"] 给拒绝消息配编号
三级 · 骨架:拒绝时返回 ToolMessage(content="...", tool_call_id=...);洋葱记号写成 request.messages[-1].content += " -> A-前 <- " 和 response.result[0].content += " -> A-后 <- "
# ========== 本篇所有答案共用的开头(模型创建) ==========import os
from dotenv import load_dotenvfrom langchain.agents import create_agentfrom langchain.chat_models import init_chat_modelfrom langchain.messages import HumanMessagefrom langchain.tools import tool
load_dotenv(override=True)
model = init_chat_model( model="deepseek-v4-flash", model_provider="openai", api_key=os.getenv("DEEPSEEK_API_KEY"), base_url=os.getenv("DEEPSEEK_BASE_URL"),)
# ---------- 2-1 装饰器写法:一个"日志中间件" ----------from typing import Any
from langchain.agents.middleware import AgentState, after_model, before_modelfrom langgraph.runtime import Runtime
@before_modeldef log_before(state: AgentState, runtime: Runtime) -> dict[str, Any] | None: print(f"[日志] 模型调用前,消息共 {len(state['messages'])} 条") return None # 返回 None = 不改状态,流程继续
@after_modeldef log_after(state: AgentState, runtime: Runtime) -> dict[str, Any] | None: last = state["messages"][-1] print(f"[日志] 模型调用后,最后一条内容的前 30 个字:{str(last.content)[:30]}") return None
agent_log = create_agent(model=model, middleware=[log_before, log_after])agent_log.invoke({"messages": [HumanMessage("你好")]})# 输出顺序:before 先打印,after 后打印 —— 一次模型调用的"两头"各挂了一个钩子
# ---------- 2-2 类写法:把自定义数据塞进 Agent 状态 ----------from langchain.agents import AgentStatefrom langchain.agents.middleware import AgentMiddlewarefrom langgraph.checkpoint.memory import InMemorySaver
# 想往 State 里塞自定义字段,就得先声明一个"带该字段的状态结构"# (不声明的话,钩子返回的 {'count': ...} 会被状态结构过滤掉,读数永远是 None)class MyState(AgentState): count: int
class CounterMiddleware(AgentMiddleware): """三条规则:继承 AgentMiddleware、方法名固定、类名随意"""
def after_model(self, state, runtime): # 返回字典 = 更新状态(这就是往 Agent 状态里塞自己数据的方式) return {"count": state.get("count", 0) + 1}
agent_count = create_agent( model=model, middleware=[CounterMiddleware()], state_schema=MyState, checkpointer=InMemorySaver(), # 短期记忆:同一个 thread_id 的 State 才会一直保留)
config = {"configurable": {"thread_id": "count-demo"}}for i in range(3): r = agent_count.invoke({"messages": [HumanMessage(f"第 {i + 1} 轮")]}, config=config) print(f"第 {i + 1} 轮之后 count = {r.get('count')}")# 1 → 2 → 3:计数存在 State 里,跟着 thread_id 一路累积
# ---------- 2-3 一个类同时覆盖"同步 + 异步"两条路径 ----------import asynciofrom typing import Any
from langchain.agents.middleware import AgentMiddleware, AgentStatefrom langgraph.runtime import Runtime
# 先确认一件事:六个 hook 都有对应的异步版本ASYNC_HOOKS = [ "abefore_agent", "abefore_model", "aafter_model", "aafter_agent", "awrap_model_call", "awrap_tool_call",]print("异步版 hook 齐全:", all(hasattr(AgentMiddleware, h) for h in ASYNC_HOOKS))
class DualModeMiddleware(AgentMiddleware): """同一个中间件里配套实现两套 hook:同步走 invoke,异步走 ainvoke"""
def before_model(self, state: AgentState, runtime: Runtime) -> dict[str, Any] | None: print("[同步路径] before_model") return None
async def abefore_model(self, state: AgentState, runtime: Runtime) -> dict[str, Any] | None: print("[异步路径] abefore_model") return None
def wrap_model_call(self, request, handler): print("[同步路径] wrap_model_call") return handler(request)
async def awrap_model_call(self, request, handler): print("[异步路径] awrap_model_call") return await handler(request) # 异步 handler 要 await
agent_dual = create_agent(model=model, middleware=[DualModeMiddleware()])
print("--- 同步 invoke ---")agent_dual.invoke({"messages": [HumanMessage("你好")]})
print("--- 异步 ainvoke ---")asyncio.run(agent_dual.ainvoke({"messages": [HumanMessage("你好")]}))# 装饰器写法做不到"一个函数管两边",这也是"要用类"的三个补充场景之一
# ---------- 2-4 包裹工具调用:敏感请求挡在门外(顺带看洋葱顺序) ----------from langchain.agents.middleware import wrap_model_call, wrap_tool_callfrom langchain.messages import ToolMessage
@tooldef query_user_profile(name: str) -> str: """查询用户资料
Args: name: 用户姓名或查询内容 """ print(" >>> 真的执行了查询工具") return f"{name} 的资料:VIP 客户,注册于 2023 年"
SENSITIVE = ["密码", "password", "身份证"]
@wrap_tool_calldef block_sensitive(request, handler): args = request.tool_call["args"] if any(word in str(args) for word in SENSITIVE): print(" >>> 命中敏感词,已拦截(handler 根本没被调用)") return ToolMessage( content="请求被安全策略拦截:不允许查询敏感信息。", tool_call_id=request.tool_call["id"], ) return handler(request) # 不调 handler,真实的工具调用就不会发生
agent_safe = create_agent(model=model, tools=[query_user_profile], middleware=[block_sensitive])for q in ["查一下张三的资料", "帮我查一下张三的密码"]: r = agent_safe.invoke({"messages": [q]}) print(f"【{q}】→ {r['messages'][-1].content}")
# ---- 洋葱顺序:两个 wrap_model_call 各在请求前后插记号(名字必须不同,否则报重复中间件)----@wrap_model_calldef wrap1(request, handler): request.messages[-1].content += " -> wrap1-前 <- " response = handler(request) response.result[0].content += " -> wrap1-后 <- " return response
@wrap_model_calldef wrap2(request, handler): request.messages[-1].content += " -> wrap2-前 <- " response = handler(request) response.result[0].content += " -> wrap2-后 <- " return response
agent_onion = create_agent(model=model, middleware=[wrap1, wrap2])resp = agent_onion.invoke({"messages": [HumanMessage("只和我打个招呼")]})print("模型看到的输入:", resp["messages"][0].content)print("最终回答 :", resp["messages"][-1].content)# 记号是"成对贴着"的:请求上 1 在 2 前面(先传递的包在最外层),回来时 2 在 1 前面3-1 三种流程跳转:跳过模型、跳回重生成、提前熔断 改造一个”查新闻”的 Agent(自带一个返回固定新闻的工具),用流程跳转实现三种行为,并保留一个正常流程作对照:
direct tool 时,跳过模型的首轮思考,自己伪造一条”模型要调工具”的消息,把控制权直接交给工具节点,再由模型总结;retry model 时,模型答完之后追加一条系统指令,把它拉回去重新生成一版——并且必须自己防死循环;overflow 时,直接跳到结尾、模型一次都不调用,返回一条兜底消息;一级 · 思路:跳转是”钩子直接改写流程走向”,所以要在装饰器上声明”我允许跳到哪”;跳回模型等于让模型重跑一遍,必须留刹车
二级 · 方法:@before_model(can_jump_to=["tools"])、@after_model(can_jump_to=["model"])、@before_model(can_jump_to=["end"]);返回值里带上 "jump_to": "tools" 之类
三级 · 骨架:伪造工具调用用 AIMessage(content=..., tool_calls=[{"name": "get_news", "args": {}, "id": "call_x"}]);刹车就是检查历史里有没有那条系统指令(already_injected)
# ---------- 3-1 综合题:三种流程跳转(跳过模型 / 跳回重生成 / 提前熔断) ----------import osfrom typing import Any
from dotenv import load_dotenvfrom langchain.agents import create_agentfrom langchain.agents.middleware import AgentState, after_model, before_modelfrom langchain.chat_models import init_chat_modelfrom langchain.messages import AIMessage, SystemMessagefrom langchain.tools import toolfrom langgraph.runtime import Runtime
load_dotenv(override=True)
model = init_chat_model( model="deepseek-v4-flash", model_provider="openai", api_key=os.getenv("DEEPSEEK_API_KEY"), base_url=os.getenv("DEEPSEEK_BASE_URL"),)
@tooldef get_news() -> str: """获取当日新闻""" return "美加墨世界杯今日开幕"
# ① 跳过模型,直接把控制权交给工具节点@before_model(can_jump_to=["tools"])def force_tool_first(state: AgentState, runtime: Runtime) -> dict[str, Any] | None: """用户输入里带 direct tool 时,伪造一条"模型要调工具"的消息,绕开模型的首轮思考""" text = state["messages"][-1].content if isinstance(text, str) and "direct tool" in text.lower(): print("[中间件] before_model: jump_to='tools'") return { "messages": [ AIMessage( content="人工构造的消息", tool_calls=[{"name": "get_news", "args": {}, "id": "call_force_001"}], ) ], "jump_to": "tools", } return None
# ② 模型答完之后,再把它拉回去重生成一版@after_model(can_jump_to=["model"])def retry_with_instruction(state: AgentState, runtime: Runtime) -> dict[str, Any] | None: """用户输入里带 retry model 时,追加一条系统提示并跳回模型节点""" user_text = "" for msg in reversed(state["messages"]): if getattr(msg, "type", "") == "human": user_text = getattr(msg, "content", "") break if isinstance(user_text, str) and "retry model" in user_text.lower(): # 【刹车】命中一次就在历史里留痕,下次进来先查痕迹,否则会无限跳 already_injected = any( isinstance(getattr(msg, "content", None), str) and "你必须以【二次回答】开头" in msg.content for msg in state["messages"] ) if already_injected: return None print("[中间件] after_model: jump_to='model'(注入指令后重新生成)") return { "messages": [SystemMessage("你必须以【二次回答】开头,并且只用一句话回答。")], "jump_to": "model", } return None
# ③ 上下文溢出:直接跳结尾,模型自始至终不会被调用@before_model(can_jump_to=["end"])def overflow_guard(state: AgentState, runtime: Runtime) -> dict[str, Any] | None: """模拟上下文窗口溢出,提前终止整个流程""" if "overflow" in str(state["messages"][-1].content): print("[中间件] before_model: jump_to='end'(提前熔断)") return {"messages": [AIMessage("上下文窗口溢出,终止")], "jump_to": "end"} return None
agent = create_agent( model=model, tools=[get_news], middleware=[force_tool_first, retry_with_instruction, overflow_guard],)
def run_once(user_input: str, label: str): print(f"===== {label} | 用户输入:{user_input} =====") result = agent.invoke({"messages": [{"role": "user", "content": user_input}]}) for msg in result["messages"]: print(f" {type(msg).__name__:15s} | {str(msg.content)[:55]}")
run_once("请帮我查今日新闻 direct tool", "Case 1 直跳工具")run_once("请随便介绍一下 LangChain retry model", "Case 2 跳回模型重生成")run_once("你好 overflow", "Case 3 上下文溢出熔断")run_once("今日新闻摘要?", "Case 4 正常流程(对照)")如果你喜欢,那么欢迎来到我的世界!
了解更多暂未播放