国庆节10月1日
--

限流(Model/Tool call limit)、故障转移、重试(指数退避+jitter)、上下文编辑、文件搜索等内置中间件,以及多个中间件的洋葱模型执行顺序与"同名中间件"的坑
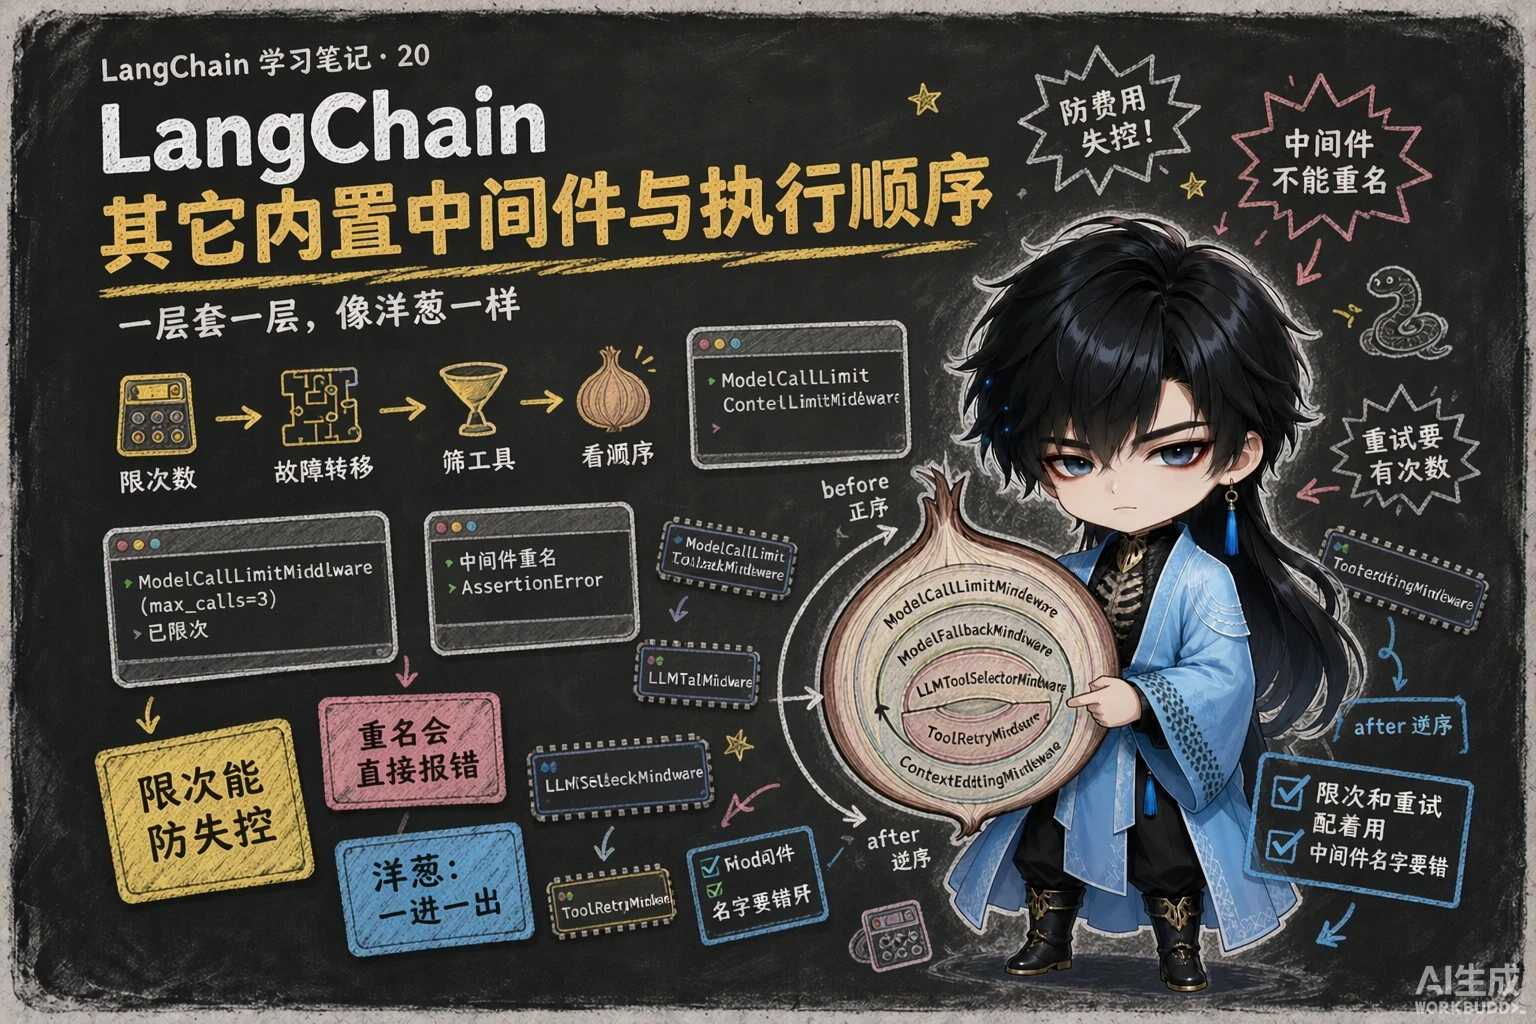
上一篇讲了四个最常用的中间件,这一篇把剩下的”其它内置中间件”过一遍,再讲清楚多个中间件一起用时的执行顺序。
解决”Agent 太能跑、停不下来”的问题——一次任务反复请求 LLM,费用失控。
from langchain.agents.middleware import ModelCallLimitMiddleware
agent = create_agent( model=model, tools=[], middleware=[ ModelCallLimitMiddleware( thread_limit=2, # 每个线程最多 2 次模型调用 # run_limit=5, # 每次运行最多 5 次模型调用 exit_behavior="end", # 达到限制后退出 ), ],)| 参数 | 含义 |
|---|---|
thread_limit | 每个线程(同一 thread_id)最多调用多少次模型 |
run_limit | 每次运行(一次 invoke)最多调用多少次 |
exit_behavior | "end"(优雅退出)或 "error"(直接抛错) |
避免 Agent 无限试错、死循环调工具:
from langchain.agents.middleware import ToolCallLimitMiddleware
middleware=[ ToolCallLimitMiddleware( # thread_limit=2, # 每个线程最多 2 次工具调用 run_limit=2, # 每次运行最多 2 次 exit_behavior="end", ),]实测参数差异:ToolCallLimitMiddleware 多一个 tool_name 参数(只限制某个工具),而且它的 exit_behavior 默认是 "continue"(ModelCallLimit 的默认是 "end")。
设成 "error" 时,超限会抛 ToolCallLimitExceededError: Tool call limit reached: run limit exceeded (4/2 calls)。
主模型无法访问时,自动启用备用模型——做的是”高可用”:
from langchain.agents.middleware import ModelFallbackMiddlewarefrom langchain.chat_models import init_chat_model
primary_model = init_chat_model("openai:gpt-5.4-mini")
fallback = ModelFallbackMiddleware( fallback_models=[ init_chat_model("openai:gpt-4o-mini"), # 可以继续列多个备选,按顺序尝试 ],)
agent = create_agent(model=primary_model, tools=[...], middleware=[fallback])工具太多时的解法:主模型挂 100 个工具,光工具定义就要烧掉一大截上下文,模型也容易挑花眼。LLMToolSelectorMiddleware 的做法是让一个子模型先看用户问题,从所有工具里挑出最相关的几个,再交给主模型——主模型看到的工具列表被”瘦身”了。
from langchain.agents.middleware import LLMToolSelectorMiddleware
tool_selector = LLMToolSelectorMiddleware( model="openai:gpt-5.4-mini", # 用于工具筛选的子模型 max_tools=5, # 最多选择 5 个工具 always_include=["get_weather"], # 指定工具不被计数(必带))
agent = create_agent( model="deepseek-v4-flash", tools=[...100个工具...], # 很多工具 middleware=[tool_selector],)课程讲到的三个参数:
| 参数 | 含义 |
|---|---|
model | 用于工具筛选的子模型;不传则复用 Agent 的主模型 |
max_tools | 限定可以调用的工具总数;模型选多了只取前 N 个;不传则不限制 |
always_include | 指定的工具不被计数(不参与 max_tools 配额,且必定保留) |
源码里还有第四个参数 system_prompt(筛选子模型的提示词,默认 "Your goal is to select the most relevant tools for answering the user's query."),一般不用改。
max_tools=0 的三个实验课程用同一套四个工具(get_weather / get_news / calculate / search_stock)问了同一个问题”北京今天天气如何?今日新闻概要”,只改 always_include,结果完全不同:
| 实验 | 中间件配置 | Agent 实际调用了 |
|---|---|---|
| 举例 1 | max_tools=0, always_include=["get_weather"] | 只有 get_weather(答完天气后表示拿不到新闻) |
| 举例 2 | max_tools=0, always_include=["get_news"] | 只有 get_news(答完新闻后表示拿不到天气) |
| 举例 3 | max_tools=0, always_include=["get_weather", "get_news"] | 两个都调,一次答全 |
max_tools=0 是这个中间件最反直觉、也最好用的玩法:它把”子模型挑出来的工具”配额压到 0,于是只有 always_include 里的工具能活下来——等于绕开子模型的判断,手工把工具列表锁死成白名单。课程正是用它来对照演示 always_include 的效果。
本机假服务端实测(用 http.server 回 OpenAI 格式响应,不花真 token):一次 invoke 里确实发生了两次请求——
max_tools=5, always_include=None 第1次请求 | model=gpt-4o-mini | system: Your goal is to select the most relevant tools... 第2次请求 | model=deepseek-v4-flash | tools=['get_news', 'calculate', 'search_stock']
max_tools=0, always_include=['get_weather'] 第1次请求 | model=gpt-4o-mini | system: Your goal is to select the most relevant tools... 第2次请求 | model=deepseek-v4-flash | tools=['get_weather']三点结论:
gpt-4o-mini),提示词就是 system_prompt;第二次才是主模型tools 已经被裁过了(5 个工具只留子模型选中的 3 个)max_tools=0 时子模型的”选择结果”被完全丢弃,只有 always_include 的 get_weather 留下另外实测看到:max_tools 会被拼进子模型的提示词末尾——"...If you exceed the maximum number of tools, only the first 0 will be used.";工具候选名单(含工具名)是通过结构化输出的 JSON Schema 枚举传给子模型的,不是塞在提示词里。
always_include 里写了不存在的工具名会当场报错(源码里的校验,实测复现):
ValueError -> Tools in always_include not found in request: ['not_exist_tool'].Available tools: ['calculate', 'get_news', 'get_weather']反过来,如果工具列表里除了 always_include 之外没有别的工具(或者压根没有工具),它会直接 handler(request) 放行——连子模型都不调用。
两者都是基于指数退避算法的重试策略。
指数退避(Exponential Backoff) 的核心思想:操作失败时(通常是网络请求、API 调用、数据库连接),不立刻重试、也不每次等固定时间,而是让每次重试的延迟按指数级增长。
为什么不直接重试?想象某个热门网站因为瞬时流量(抢票、秒杀)崩了。如果所有失败客户端都每隔 1 秒重试一次,无异于对已经瘫痪的服务器发起持续的 DDoS,它可能永远缓不过来。
from langchain.agents.middleware import ToolRetryMiddleware
middleware=[ ToolRetryMiddleware( max_retries=6, # 最大重试次数(不含第一次,共最多 1+6=7 次调用) backoff_factor=2.0, # 指数退避因子(每次等待时间 ×2) initial_delay=1.0, # 第一次重试前的初始等待时间(秒) max_delay=10.0, # 最大等待上限(防止无限增长) jitter=True, # 开启抖动 retry_on=(TimeoutError,), # 只对指定异常重试 on_failure="continue", # 重试仍失败时怎么办 ),]| 参数 | 含义 |
|---|---|
max_retries | 最大重试次数(不包含首次调用) |
backoff_factor | 指数退避因子;设为 0 就退化成固定间隔(始终 initial_delay) |
initial_delay / max_delay | 首次等待时间 / 等待时间上限 |
jitter | 抖动:在等待时间上加随机性 |
retry_on | 只对指定异常类型重试(默认捕获所有异常) |
on_failure | 达到最大重试仍失败时的行为 |
为什么要 jitter? 避免大量请求的重试集中在同一时间点(惊群效应)。假设按策略两次请求间隔应为 10 秒,加入抖动后可能是 8.9 秒,也可能是 10.2 秒。
on_failure 的两个常见取值:
| 取值 | 行为 |
|---|---|
"continue" | 把错误信息包装后塞回对话历史,让大模型知道失败了并继续决策 |
"error" | 直接抛出异常,终止流程 |
ModelRetryMiddleware 的用法和参数完全一样,只是重试的对象换成模型调用:
from langchain.agents.middleware import ModelRetryMiddleware
middleware=[ModelRetryMiddleware(max_retries=3, backoff_factor=2.0, on_failure="continue")]场景:某些情况下工具还没开发完(后端接口没上、API 要等排期),但你想先把”模型调用工具”这条链路跑通——这时用 LLMToolEmulator 让 LLM 假装自己就是那个工具,返回一份像模像样的结果。
from langchain.agents import create_agentfrom langchain.agents.middleware import LLMToolEmulatorfrom langchain.messages import HumanMessagefrom langchain.tools import tool
@tooldef get_weather(city: str): """查询指定城市天气""" return f"{city}今天天气晴朗" # 真工具的真实实现(模拟时不会被执行)
agent = create_agent( model=model_out, tools=[get_weather], middleware=[ LLMToolEmulator( model=model_in, # 用来"编造"工具返回值的模型 ) ])
response = agent.invoke({"messages": [HumanMessage("今天北京天气如何")]})for msg in response["messages"]: msg.pretty_print()参数只有两个:
| 参数 | 含义 |
|---|---|
model | 用于模拟工具的模型;不传默认是 anthropic:claude-sonnet-4-5-20250929(temperature=1),所以国内环境一般要显式传自己的模型 |
tools | 要模拟的工具名单(工具名或工具对象)。不传(None)= 模拟全部工具;传空列表 = 一个都不模拟(等于没挂) |
课程输出:Agent 照常发起 get_weather(city="北京") 调用,但工具返回的不再是函数体里那句”今天天气晴朗”,而是一份凭空生成的详细天气 JSON:
{ "city": "北京", "date": "2025-04-12", "weather": "多云转晴", "temperature": { "current": 18, "high": 22, "low": 11 }, "humidity": "45%", "wind": { "direction": "西北风", "speed": "3-4级" }, "aqi": 85, "sunrise": "05:37", "sunset": "18:49", "recommendation": "昼夜温差较大,建议携带外套"}主模型拿到这份 JSON 后继续正常总结——整条”调用工具 → 拿结果 → 再总结”的链路完全跑通,只是结果是人造的。
本机假服务端实测(不花真 token,工具函数体里故意留了一句”真工具的真实返回值”作为标记):
总请求数: 3--- 第1次请求 | model=deepseek-v4-flash | 第1条消息: 今天北京天气如何--- 第2次请求 | model=deepseek-v4-flash | 第1条消息: You are emulating a tool call for testing purposes. | Tool: get_weather | Description: 查询指定城市天气 | Arguments: {'city': '北京'} | Generate a realistic response that this tool would return given these arguments.--- 第3次请求 | model=deepseek-v4-flash | 第1条消息: 今天北京天气如何
真实工具是否被执行: 没有(工具函数体一次都没跑)
HumanMessage | 今天北京天气如何AIMessage | (tool_calls: get_weather)ToolMessage | { "city": "北京", "date": "2025-04-12", "weather": "多云转晴", ... }AIMessage | 北京今天多云转晴,18℃。两个关键结论:
wrap_tool_call 直接短路返回 ToolMessage 的(源码里叫 short-circuit),连 handler 都不会调模型发起工具调用 → 模拟器模型"编造"工具返回值 → 主模型总结。所以模拟不是白来的,它把一次工具调用换成了一次额外的模型调用(也就多了一份 token)别把它当成真工具用:模拟结果里的日期、气温、AQI 全是模型编的,没有任何真实性保证。它的定位是”开发调试与测试辅助”——把链路先跑通、把提示词和工具参数调对;等真工具上线,把 LLMToolEmulator 从 middleware 里摘掉即可,其余代码一行不用改。
通过更改”发送给模型的消息列表”来控制成本——注意:它不修改真实的消息列表(Agent 状态里的 messages 不变),所以从返回值看不出裁剪痕迹,只能通过 token 用量推测。
from langchain.agents.middleware import ContextEditingMiddleware, ClearToolUsesEdit
middleware=[ ContextEditingMiddleware( edits=[ ClearToolUsesEdit( trigger=50, # 工具输出累计 token 超过 50 时触发清理 keep=0, # 保留最近 0 条工具输出(全清) ), ], ),]ClearToolUsesEdit 的实际默认值(查看源码签名):trigger=100000、keep=3、clear_at_least=0、clear_tool_inputs=False、exclude_tools=()、placeholder="[cleared]"。
和 Summarization 的区别:Summarization 会真的改写消息列表(用摘要替换历史),ContextEditing 只改”发给模型的副本”——一个改状态,一个不改状态。
基于系统的 Glob 和 Grep 检索工具,给 Agent 赋予本地文件搜索与分析能力:
| 工具 | 作用 |
|---|---|
| Glob | 按文件路径检索 |
| Grep | 按文件内容检索 |
from langchain.agents.middleware import FilesystemFileSearchMiddleware
agent = create_agent(model=model, middleware=[FilesystemFileSearchMiddleware(...)])课程里还提了三个”源自 deepagents(基于 LangChain 的另一个框架)“的中间件,知道用途即可:
| 中间件 | 作用 |
|---|---|
| Shell tool | 给 Agent 一个可执行命令的持久 Shell 环境(Windows 下无法测试) |
| Filesystem | 内置四个工具:查看目录、读文件、写文件、改文件 |
| Subagent | 便捷地创建子 Agent |
问题:Middleware 可以叠加使用,那么多个中间件书写顺序重要吗?——非常重要!
比如这样的顺序就有讲究:
middleware=[ PIIMiddleware(strategy="redact"), # 1. 最先检查 PII ModelCallLimitMiddleware(run_limit=10), # 2. 限制调用次数 SummarizationMiddleware(max_tokens_before_summary=500), # 3. 总结历史 ToolRetryMiddleware(max_retries=3), # 4. 重试工具]用三个自定义中间件实测(每个都实现了 before_model 和 after_model):
[中间件1] before_model[中间件2] before_model[中间件3] before_model[中间件3] after_model ← 从后往前[中间件2] after_model[中间件1] after_model执行顺序的规律(记这一句就够):
before_* 钩子:从前到后执行(写在列表前面的先跑)after_* 钩子:从后往前执行(写在列表后面的先跑)wrap_* 钩子:洋葱架构,前面的包裹后面的整体像洋葱:1 → 2 → 3 → 模型 → 3 → 2 → 1。
注意这里说的顺序不是类的定义顺序,而是创建 Agent 时 middleware=[...] 的书写顺序。
自己写中间件时如果同一个类实例化多次,创建 Agent 会直接失败:
AssertionError: Please remove duplicate middleware instances.原因:AgentMiddleware 的 name 属性默认是类名(self.__class__.__name__),同类多实例就重名了。三种解法:
| 解法 | 说明 |
|---|---|
| 写成不同的类 | 课程演示用的 Middleware1/2/3 就是这么做的 |
重写 name 属性 | 自定义中间件里加 @property def name(self): return f"M{self.tag}" |
| 用参数区分的内置中间件 | 像 PIIMiddleware 的 name 是 PIIMiddleware[email]、PIIMiddleware[credit_card],天然不重名,所以可以一次挂 5 个 |
thread_limit(每个线程,即同一 thread_id)和 run_limit(每次运行,即一次 invoke);退场方式 exit_behavior 可取 "end"(优雅退出)或 "error"(直接抛错)。限制工具调用次数的中间件多一个 tool_name 参数(只限制某个工具),它的 exit_behavior 默认是 "continue";设成 "error" 时超限会抛 ToolCallLimitExceededErrorfallback_models 列表里的模型model 指定用于筛选的子模型(不传就复用主模型)、max_tools 限定额度(超出的只取前 N个)、always_include 里的工具不被计数(不参与配额且必定保留);源码里还有第四个参数 system_prompt,默认提示词是 "Your goal is to select the most relevant tools for answering the user's query."max_tools=0 是这个中间件最好用的玩法:它把”子模型挑出来的工具”配额压到 0,于是只有 always_include 里的工具能活下来,等于手工锁出一份白名单;如果 always_include 里写了不存在的工具名,会当场抛 ValueError;反过来,如果工具列表里除了 always_include 之外没有别的工具,它会直接放行、连子模型都不调用invoke 里发生了两次模型请求,第一次发给的是筛选子模型(提示词就是 system_prompt,max_tools 会被拼进它的提示词末尾),第二次才是主模型;之后主模型拿到的工具列表已经被**裁剪(瘦身)**过;而工具候选名单是通过结构化输出的 JSON Schema 枚举传给子模型的,不是塞在提示词里max_retries 指的是不含首次调用的次数;backoff_factor 设成 0 就退化成固定间隔;jitter 的作用是加随机抖动、避免大量请求在同一时刻重试(惊群效应);retry_on 用来限定只对指定异常类型重试;on_failure="continue" 表示把错误信息塞回对话历史让模型继续决策,"error" 表示直接抛异常终止;模型重试中间件的参数和它完全一样model 不传时默认是 anthropic:claude-sonnet-4-5(claude-sonnet-4-5,temperature=1),国内环境一般要显式传;tools 参数不传(None)=模拟全部工具,传空列表=一个都不模拟;它是用 wrap_tool_call 直接短路返回 ToolMessage 的,所以真实工具的函数体一次都没跑;代价是一次工具调用会换成一次额外的模型调用;它的定位是开发调试与测试辅助,真工具上线后把它从 middleware 里摘掉即可trigger=100000、keep=3、placeholder="[cleared]";它和摘要中间件的区别是:摘要会真的改写消息列表,它只改”发给模型的副本”FilesystemFileSearchMiddleware 中间件,它的两个工具是 Glob(按文件路径检索)和 Grep(按文件内容检索);来自 deepagents 的三个中间件分别提供持久 Shell 环境(Windows 下无法测试)、内置四个文件工具、便捷创建子 Agentbefore_* 钩子从前到后(正序)执行、after_* 钩子从后往前(逆序)执行、wrap_* 钩子是洋葱模型(前面的包裹后面的);顺序取决于创建 Agent 时 middleware=[...] 的书写顺序,而不是类的定义顺序。另外,同类中间件实例化多次会直接失败,报错原文是 Please remove duplicate middleware instances.,因为 name 属性默认取类名;解法是写成不同的类、重写 name 属性、或者用”参数区分”的内置中间件2-1 给 Agent 戴上”紧箍咒” 建两个 Agent 做对比: ① 第一个限制”模型调用次数”——每次运行最多 2 次,到点就优雅收尾;把它改成”直接抛错”再看抛什么异常; ② 第二个限制”工具调用次数”——只盯住其中一个工具、每次运行最多 2 次,先保持默认行为,看超限时那条工具结果长什么样;再改成”直接抛错”,记录异常类型与原文。 两个 Agent 都给同一个”会停不下来”的任务(比如让模型反复调用同一个加法工具),打印返回消息的条数与最后一条的类型,判断它是被”限制”结束的还是正常结束的。
一级 · 思路:限制是”硬约束”,到点要么体面退出、要么直接报错,不会让模型自己收敛
二级 · 方法:ModelCallLimitMiddleware(run_limit=2, exit_behavior="end");ToolCallLimitMiddleware(tool_name="add", run_limit=2)
三级 · 骨架:用 try/except 分别接住报错的那两次;工具超限的默认行为是”把超限说明当成工具结果塞回去”,所以在消息里搜 limit 就能看到
2-2 工具太多?让子模型先帮你筛一遍 手头四个工具(查天气、查新闻、算数、查股票),只想让主模型每次只看到其中一小部分: ① 让一个”小模型”先看问题再挑工具,最多留 5 个; ② 把挑选配额压成 0,改成”指定哪些工具必须保留”——分别让”天气必带”和”天气、新闻都必带”各跑一次,打印这几次实际被调用的工具名; ③ 故意指定一个不存在的工具名,记录报错原文。 挑战:自己写两句不同的问题,观察子模型挑出来的工具会不会跟着问题变。
一级 · 思路:max_tools=0 会丢掉子模型的选择结果,只剩”必带清单”——这就是手工白名单
二级 · 方法:LLMToolSelectorMiddleware(model=model, max_tools=5, always_include=["get_weather"])
三级 · 骨架:子模型可以直接复用主模型对象,省一个 key;想确认”到底发生了两次请求”,可以开 LangSmith 或看服务端日志
2-3 让工具失败后自动重试 写一个”前两次必失败、第三次成功”的工具(全局计数器 + 抛超时异常),配上自动重试:最多重试 3 次、第一次等 0.5 秒、之后每次等待翻倍、等待有上限、带随机抖动、只对超时异常重试、重试仍失败就把错误交回模型。在工具里打印时间戳,观察等待间隔是不是越来越久,并确认最终拿到了结果。 挑战:把”翻倍因子”改成 0,看看两次等待会变成什么样(用时间戳验证)。
一级 · 思路:重试是框架行为,不需要你自己写循环;指数退避是为了别把已经崩掉的服务再压一遍
二级 · 方法:ToolRetryMiddleware(max_retries=3, initial_delay=0.5, backoff_factor=2.0, max_delay=5.0, jitter=True, retry_on=(TimeoutError,), on_failure="continue")
三级 · 骨架:计数器用 attempts = {"n": 0} 这类可变对象;想验证固定间隔就把 backoff_factor=0、jitter=False,两次等待应该都等于 initial_delay
2-4 工具还没开发完?让 LLM 假装自己就是那个工具
手头只有一个”查天气”的真工具(函数体里故意打印一行标记),但你想先把”调用工具 → 拿结果 → 再总结”这条链路跑通:让另一个模型假装自己就是那个工具,直接编一份像样的天气 JSON 返回给主模型。
跑完后检查三件事:① 真工具的函数体有没有执行(看那行标记);② 一次 invoke 里一共发生了几次模型请求;③ 这个中间件是”临时替代品”还是”能上生产”——用自己的话说清它的定位。
一级 · 思路:模拟是”在工具调用真正发生之前把它短路掉”,所以真工具永远不会被碰
二级 · 方法:LLMToolEmulator(model=model);只想模拟部分工具就写 tools=["get_weather"]
三级 · 骨架:用 for m in r["messages"] 打印每条消息的类型与内容,ToolMessage 里那份 JSON 就是”编”出来的
# ========== 本篇所有答案共用的开头(模型创建) ==========import os
from dotenv import load_dotenvfrom langchain.agents import create_agentfrom langchain.chat_models import init_chat_modelfrom langchain.messages import HumanMessagefrom langchain.tools import tool
load_dotenv(override=True)
model = init_chat_model( model="deepseek-v4-flash", model_provider="openai", api_key=os.getenv("DEEPSEEK_API_KEY"), base_url=os.getenv("DEEPSEEK_BASE_URL"),)
# ---------- 2-1 次数限制:给 Agent 戴上"紧箍咒" ----------from langchain.agents.middleware import ModelCallLimitMiddleware, ToolCallLimitMiddleware
@tooldef add(a: int, b: int) -> int: """两数相加
Args: a: 第一个数 b: 第二个数 """ return a + b
QUESTION = "用 add 工具一直算下去:先算 1+2,再算 3+4,再算 5+6……不要停"
# ① 限制"模型调用次数",达到上限后优雅退出agent_limit = create_agent( model=model, tools=[add], middleware=[ModelCallLimitMiddleware(run_limit=2, exit_behavior="end")],)r = agent_limit.invoke({"messages": [QUESTION]})print("① end 退出:", f"共 {len(r['messages'])} 条消息,最后一条是 {type(r['messages'][-1]).__name__}")
# ② 同一份配置改成 error:直接抛异常,程序中断agent_err = create_agent( model=model, tools=[add], middleware=[ModelCallLimitMiddleware(run_limit=2, exit_behavior="error")],)try: agent_err.invoke({"messages": [QUESTION]})except Exception as e: # noqa: BLE001 print("② error 退出:", type(e).__name__, str(e)[:70])
# ③ 限制"工具调用次数":exit_behavior 默认是 continue —— 超限不报错,只把"超限"当结果塞回去agent_tool = create_agent( model=model, tools=[add], middleware=[ ToolCallLimitMiddleware(tool_name="add", run_limit=2), # 只限制 add 这个工具 ],)r3 = agent_tool.invoke({"messages": [QUESTION]})limited = [m for m in r3["messages"] if "limit" in str(getattr(m, "content", "")).lower()]print("③ 默认 continue:", limited[-1].content[:80] if limited else "(没触发限制)")
# ④ 工具调用超限 + error:抛 ToolCallLimitExceededErroragent_tool_err = create_agent( model=model, tools=[add], middleware=[ToolCallLimitMiddleware(run_limit=2, exit_behavior="error")],)try: agent_tool_err.invoke({"messages": [QUESTION]})except Exception as e: # noqa: BLE001 print("④ 工具超限 error:", type(e).__name__, str(e)[:70])
# ---------- 2-2 工具太多?让子模型先帮你筛一遍 ----------from langchain.agents.middleware import LLMToolSelectorMiddlewarefrom langchain.tools import tool
@tooldef get_weather(city: str) -> str: """查询指定城市天气
Args: city: 城市名称 """ return f"{city}今天天气晴朗,25℃"
@tooldef get_news() -> str: """获取今日新闻概要""" return "今日新闻:美加墨世界杯开幕"
@tooldef calculate(expression: str) -> str: """计算数学表达式
Args: expression: 要计算的表达式 """ return f"{expression} = 42"
@tooldef search_stock(name: str) -> str: """查询股票行情
Args: name: 股票名称 """ return f"{name}:今日上涨 1.2%"
TOOLS = [get_weather, get_news, calculate, search_stock]QUESTION = "北京今天天气如何?今日新闻概要"
def build(**kw): """子模型直接用主模型,省一个 key;参数原样透传给筛选中间件""" return create_agent( model=model, tools=TOOLS, middleware=[LLMToolSelectorMiddleware(model=model, **kw)], )
def called_tools(result) -> list: return [tc["name"] for m in result["messages"] for tc in (getattr(m, "tool_calls", None) or [])]
# ① 默认玩法:最多留 5 个工具,由子模型自己挑print("① max_tools=5 → 实际调用:", called_tools(build(max_tools=5).invoke({"messages": [QUESTION]})))
# ② max_tools=0 = 把子模型的配额压到 0,只剩 always_include 里的工具能活(手工白名单)print("② 必带天气 → 实际调用:", called_tools( build(max_tools=0, always_include=["get_weather"]).invoke({"messages": [QUESTION]})))
# ③ 两个都必带:问题里问了两件事,工具就都能用上print("③ 必带天气+新闻 → 实际调用:", called_tools( build(max_tools=0, always_include=["get_weather", "get_news"]).invoke({"messages": [QUESTION]})))
# ④ always_include 写了不存在的工具名 → 直接报错try: build(max_tools=0, always_include=["not_exist_tool"]).invoke({"messages": [QUESTION]})except ValueError as e: print("④ 不存在的工具名 →", str(e)[:90])
# ---------- 2-3 工具失败自动重试(指数退避 + 抖动) ----------import time
from langchain.agents.middleware import ToolRetryMiddleware
attempts = {"n": 0}
@tooldef flaky_tool(query: str) -> str: """一个"前两次必失败、第三次成功"的工具
Args: query: 查询内容 """ attempts["n"] += 1 print(f" 第 {attempts['n']} 次调用,时刻 {time.strftime('%H:%M:%S')}") if attempts["n"] < 3: raise TimeoutError("模拟网络超时") return f"{query} 的查询结果:成功"
agent_retry = create_agent( model=model, tools=[flaky_tool], middleware=[ ToolRetryMiddleware( max_retries=3, # 最多重试 3 次(不含第一次调用) initial_delay=0.5, # 第一次失败后等 0.5 秒 backoff_factor=2.0, # 之后每次等待 ×2:0.5 → 1 → 2 max_delay=5.0, # 等待上限 jitter=True, # 抖动:避免所有客户端同一时刻重试(惊群) retry_on=(TimeoutError,), # 只对超时重试(不传则捕获所有异常) on_failure="continue", # 重试完还失败就把错误塞回对话,交给模型决策 ) ],)
t0 = time.time()r = agent_retry.invoke({"messages": ["用 flaky_tool 查一下北京天气"]})print("最终回答:", r["messages"][-1].content)print(f"工具共被调用 {attempts['n']} 次,总共花了 {time.time() - t0:.2f} 秒")
# 挑战:backoff_factor=0 退化成"固定间隔",把 jitter 关掉就是教科书式的等间隔重试attempts["n"] = 0agent_fixed = create_agent( model=model, tools=[flaky_tool], middleware=[ ToolRetryMiddleware( max_retries=2, initial_delay=1.0, backoff_factor=0.0, # ← 关键:0 = 每次都等 initial_delay jitter=False, retry_on=(TimeoutError,), on_failure="continue", ) ],)t0 = time.time()agent_fixed.invoke({"messages": ["再用 flaky_tool 查一次"]})print(f"固定间隔这轮:工具被调用 {attempts['n']} 次,花了 {time.time() - t0:.2f} 秒(两次等待都该是 1 秒)")
# ---------- 2-4 工具还没开发完?让 LLM 假装自己就是那个工具 ----------from langchain.agents.middleware import LLMToolEmulator
@tooldef get_weather(city: str) -> str: """查询指定城市天气
Args: city: 城市名称 """ print(" >>> 真工具的函数体被执行了(模拟模式下这行不该出现)") return f"{city}今天天气晴朗"
agent_emu = create_agent( model=model, tools=[get_weather], middleware=[ # 不传 model 时默认用 claude-sonnet-4-5(国内一般连不上),所以显式指定自己的模型 LLMToolEmulator(model=model), # 只想模拟部分工具就写 tools=["get_weather"];传空列表 = 一个都不模拟(等于没挂) ],)
r = agent_emu.invoke({"messages": ["今天北京天气如何"]})for m in r["messages"]: print(f"{type(m).__name__:12s} | {str(m.content)[:75]}")print("提示:ToolMessage 里那份详细天气全是模型编的,没有任何真实性保证")3-1 组合出一套”生产级”中间件 把本篇的中间件按”先检查拦截、再增强兜底”的原则串成一条链:敏感信息脱敏 → 模型调用次数限制 → 上下文编辑 → 工具重试。 要求:
before_* 正序、after_* 逆序;再故意把同一个类实例化两次挂上去,记录报错原文并说出原因。一级 · 思路:越”管安全”的越靠前(别让它有机会发出去),越”管失败”的越靠后(离真正的调用最近);顺序实验只看 middleware=[...] 的书写顺序
二级 · 方法:middleware=[PIIMiddleware(...), ModelCallLimitMiddleware(...), ContextEditingMiddleware(...), ToolRetryMiddleware(...)];顺序实验用 class X(AgentMiddleware) 实现 before_model / after_model
三级 · 骨架:ClearToolUsesEdit(trigger=50, keep=0) 很容易观察到 [cleared];重试等待时间调小一点(比如 initial_delay=0.2)免得等半天;同名报错的解法是写成两个不同的类,或在自定义中间件里重写 name 属性
# ---------- 3-1 综合题:组合出一套"生产级"中间件 ----------import os
from dotenv import load_dotenvfrom langchain.agents import create_agentfrom langchain.chat_models import init_chat_modelfrom langchain.messages import HumanMessagefrom langchain.tools import toolfrom langchain.agents.middleware import ( ClearToolUsesEdit, ContextEditingMiddleware, ModelCallLimitMiddleware, PIIMiddleware, ToolRetryMiddleware,)
load_dotenv(override=True)
model = init_chat_model( model="deepseek-v4-flash", model_provider="openai", api_key=os.getenv("DEEPSEEK_API_KEY"), base_url=os.getenv("DEEPSEEK_BASE_URL"),)
attempts = {"n": 0}
@tooldef flaky_tool(query: str) -> str: """偶尔超时的查询工具
Args: query: 查询内容 """ attempts["n"] += 1 if attempts["n"] % 3 != 0: # 每三次成功一次,让重试中间件有活干 raise TimeoutError("模拟网络超时") return f"{query} 的查询结果:成功"
agent_prod = create_agent( model=model, tools=[flaky_tool], middleware=[ # 1. 最先:敏感信息脱敏(越早拦越好,绝不能让原文有机会发给模型服务) PIIMiddleware("email", strategy="redact", apply_to_input=True), # 2. 其次:成本硬约束,防止 Agent 停不下来 ModelCallLimitMiddleware(thread_limit=10, exit_behavior="end"), # 3. 再次:控制上下文体积(只改"发给模型的那一份",Agent 状态里的消息不动) ContextEditingMiddleware(edits=[ClearToolUsesEdit(trigger=50, keep=0)]), # 4. 最后:失败后的兜底重试 —— 它离真正的调用最近,所以垫在洋葱的最里层 ToolRetryMiddleware( max_retries=3, initial_delay=0.5, backoff_factor=2.0, on_failure="continue" ), ],)
r = agent_prod.invoke({"messages": ["我的邮箱是 a@b.com,用它查一下北京天气"]})for m in r["messages"]: print(f"{type(m).__name__:12s} | {str(m.content)[:70]}")print("工具共被调用:", attempts["n"], "次(说明重试中间件真的在兜底)")
# 排顺序的道理(一句话):先做"检查/拦截",再做"增强/兜底"。# - PII 放最前:它管的是"别把敏感信息发出去",必须在大模型看到请求之前生效# - 限流第二:在任何昂贵动作之前先把闸门关小# - 上下文编辑第三:内容已经安全了,再动体积# - 重试最后:只有前面的检查都放行了,才谈得上"失败了怎么办"
# ---------- 第五步:亲手验证"洋葱顺序"和"同名惩罚" ----------from langchain.agents.middleware import AgentMiddleware
class MarkerA(AgentMiddleware): def before_model(self, state, runtime): print(" [A] before_model") return None
def after_model(self, state, runtime): print(" [A] after_model") return None
class MarkerB(AgentMiddleware): def before_model(self, state, runtime): print(" [B] before_model") return None
def after_model(self, state, runtime): print(" [B] after_model") return None
for order, mws in [("[A(), B()]", [MarkerA(), MarkerB()]), ("[B(), A()]", [MarkerB(), MarkerA()])]: print(f"--- 书写顺序 {order} ---") create_agent(model=model, middleware=mws).invoke({"messages": [HumanMessage("测试顺序")]})# before_* 跟着书写顺序走(从前到后),after_* 反过来(从后往前)——整体是个洋葱
# 同一个类实例化两次会被直接拒绝,因为 name 默认取类名try: create_agent(model=model, middleware=[MarkerA(), MarkerA()])except AssertionError as e: print("同类实例化两次 →", e)如果你喜欢,那么欢迎来到我的世界!
了解更多暂未播放