国庆节10月1日
--

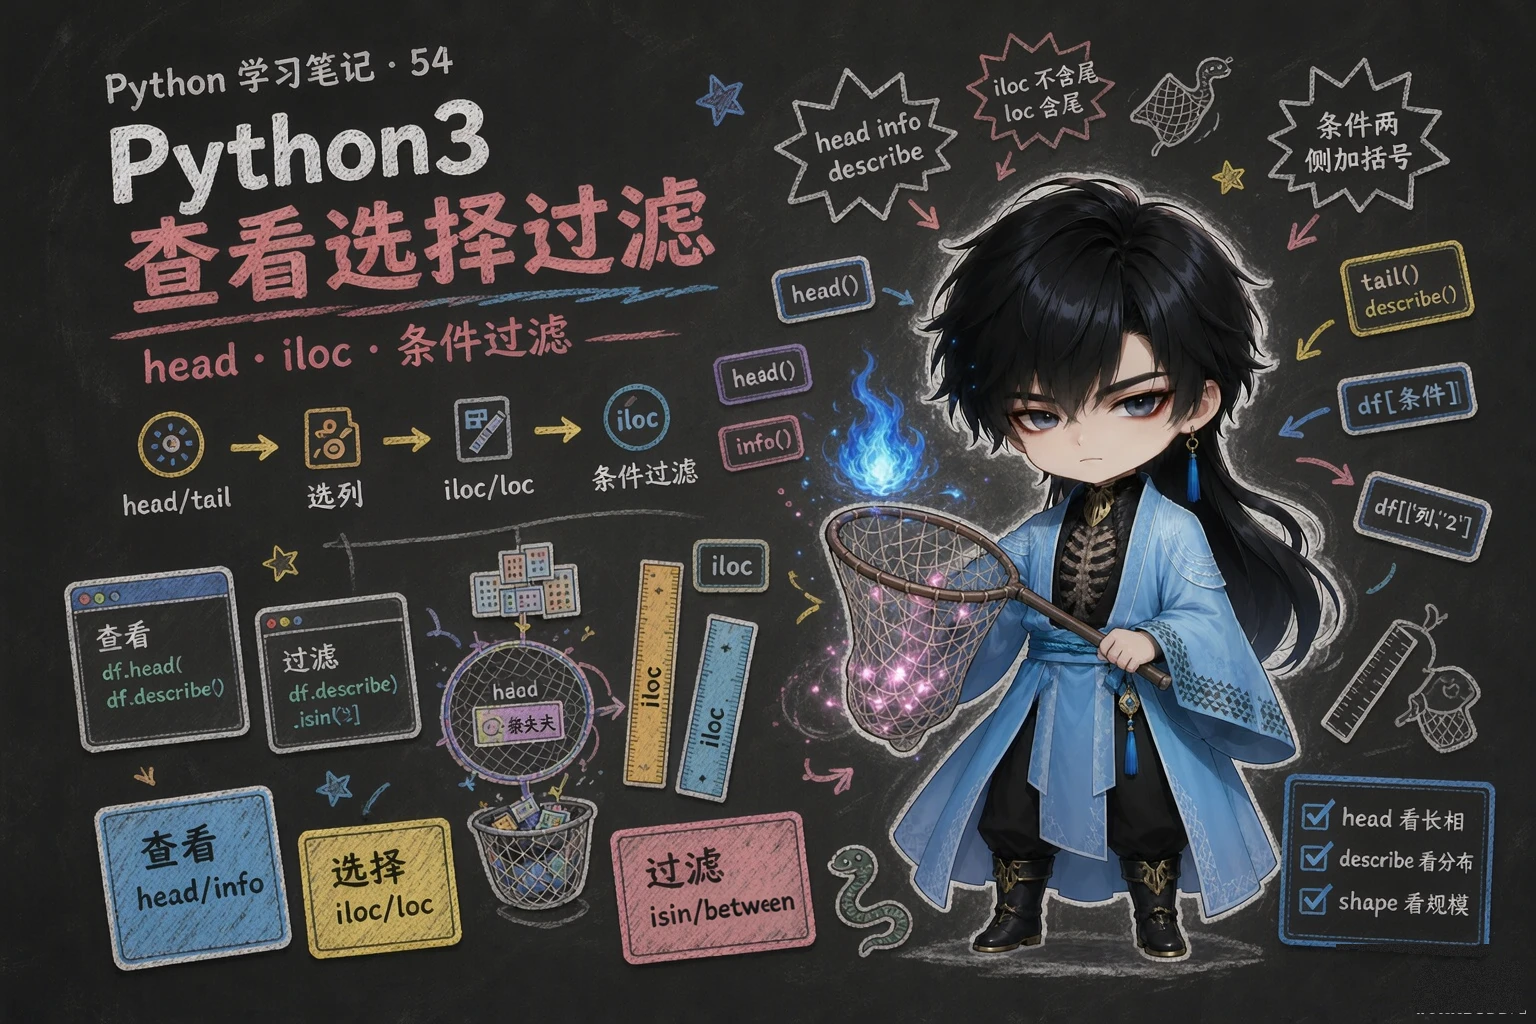
用 head/tail/describe/info 查看数据,用单列/多列/iloc/loc 选择数据,用条件表达式过滤数据
| 方法/属性 | 作用 |
|---|---|
df.head(n) | 查看前 n 行数据(不写 n 默认 5) |
df.tail(n) | 查看结尾 n 行数据 |
df.describe() | 数值列的统计描述(计数、均值、标准差、最值、四分位) |
df.info() | 查看数据信息(列名、非空计数、数据类型) |
df.shape | 属性,查看数据维度(行数, 列数) |
df.columns | 属性,查看列名 |
拿到一份新数据,习惯动作是 head() 看长相 + info() 看有没有缺失 + describe() 看数值是否离谱。
df['列名'] # 单选一列(返回 Series)df.列名 # 同上(列名是合法标识符时才能这么写)df[['列1', '列2']] # 多选(注意里面是**列表**,返回 DataFrame)| 方法 | 依据 | 是否包含结束位置 | 语法 |
|---|---|---|---|
df.iloc[start:stop:step] | 行号(第几行) | 不包含 stop | df.iloc[0:5] 取前 5 行 |
df.loc[start:stop:step] | 索引标签 | 包含 stop | df.loc[6805677496:5888085066:2] |
这是最容易混的一对:iloc 按”第几行”数、不含结尾;loc 按”索引值”找、含结尾。跟 Python 普通切片(不含结尾)一样的只有 iloc。
语法:df[条件表达式],结果是满足条件的行。
# 1. 销售数量 >= 10 的订单df[df['销售数量'] >= 10]
# 2. 产品类别是 食品 或 图书df[df['产品类别'].isin(['食品', '图书'])]
# 3. 单价在 79-199 之间(between 默认包含两端)df[df['单价'].between(79, 199)]
# 4. 多条件:并且用 &、或者用 |(每个条件都要加括号!)df[(df['销售数量'] >= 8) & (df['单价'] >= 100)]| 写法 | 含义 |
|---|---|
df[df['列'] >= 值] | 单条件 |
df['列'].isin([值1, 值2]) | 属于集合(多选一) |
df['列'].between(a, b) | 在区间内 |
& / ` | ` |
df.head(n),查看末尾 n 行用 df.tail(n)df.describe();查看列名、非空计数、类型用 df.info()df['列名'] 返回 Series;选多列:df[['列1','列2']] 返回 DataFramedf.iloc(不包含结尾);基于索引标签切片用 df.loc(会包含结尾)df['列'].isin([...])df['列'].between(a, b)&、“或者”用 |,且每个条件要用圆括号括起来数据:data/sales.csv(列:订单号、产品类别、产品名称、销售数量、单价、客户所在城市、支付方式、订单日期)
2-1 先看清数据长什么样
读取 data/sales.csv,打印前 5 行、行数与列数、以及数值列的统计描述。
一级 · 思路:三段式查看:看长相 → 看规模 → 看数值分布
二级 · 方法:head() / shape / describe()
三级 · 骨架:pd.read_csv('data/sales.csv')
import pandas as pd
df = pd.read_csv('data/sales.csv')
# 2-1print(df.head(5))print(df.shape)print(df.describe())2-2 选出需要的列 用两种写法选出”产品名称、单价”两列,并单独取出”产品名称”这一列,观察返回类型有什么不同。
一级 · 思路:一列是 Series,多列是 DataFrame
二级 · 方法:df['产品名称'] / df[['产品名称', '单价']]
三级 · 骨架:用 type() 打印类型对比
# 2-2print(type(df['产品名称'])) # <class 'pandas.core.series.Series'>print(type(df[['产品名称', '单价']])) # <class 'pandas.core.frame.DataFrame'>2-3 条件过滤 找出:① 销售数量 ≥ 10 的订单;② 产品类别是”食品”或”图书”的订单;③ 单价在 79~199 之间;④ 销售数量 ≥ 8 并且 单价 ≥ 100 的订单。
一级 · 思路:四种过滤各写一行,注意多条件的括号
二级 · 方法:比较运算 / isin([...]) / between(a, b) / (条件1) & (条件2)
三级 · 骨架:df[(df['销售数量'] >= 8) ____ (df['单价'] >= 100)]
# 2-3print(df[df['销售数量'] >= 10])print(df[df['产品类别'].isin(['食品', '图书'])])print(df[df['单价'].between(79, 199)])print(df[(df['销售数量'] >= 8) & (df['单价'] >= 100)]) 2-4 行切片
用 iloc 取前 5 行,再用 loc 取第 3 到第 5 行(按行索引标签),对比两者取到的行数。
一级 · 思路:iloc 数”第几行”、不含结尾;loc 看”索引值”、含结尾
二级 · 方法:df.iloc[0:5] / df.loc[2:4]
三级 · 骨架:打印 len() 对比
# 2-4print(len(df.iloc[0:5])) # 5 行print(len(df.loc[2:4])) # 3 行(含索引 2、3、4)如果你喜欢,那么欢迎来到我的世界!
了解更多暂未播放