国庆节10月1日
--

模型本身无状态,记忆要靠 State + Checkpointer + Thread ID 三件套;InMemorySaver 与 PostgresSaver 的用法、thread_id 隔离的实测、上下文变长后的裁剪/删除/摘要三种管理手段
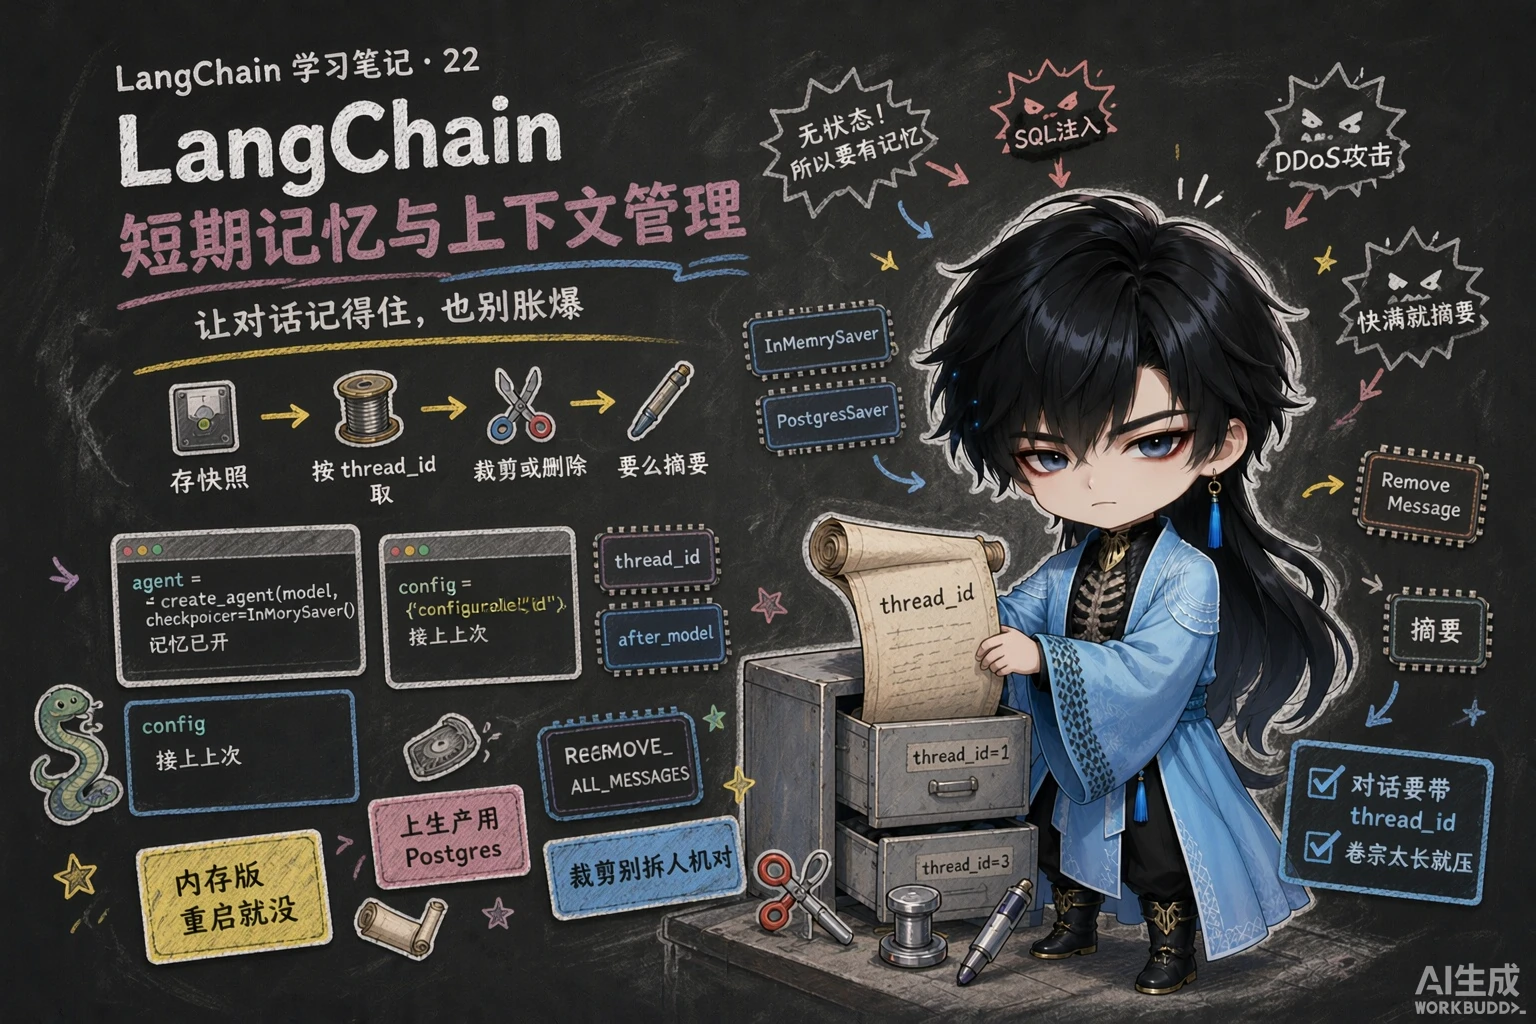
大模型本身是”无状态”的——它不记忆任何上下文。也就是说,每次 agent.invoke() 都是全新的开始,不记得之前的对话。
# 第一次调用agent.invoke({"messages": [HumanMessage("你好,我叫小明")]})
# 第二次调用(同一个 agent 对象!)agent.invoke({"messages": [HumanMessage("我叫什么?")]})# 模型:我不知道你叫什么 ← 因为历史消息根本没传给它而我们平时用 ChatGPT 那种”多轮对话”体验,背后其实是应用层在每次请求时把历史消息一起发给模型。
 图:多轮对话里模型能接上前文,靠的是把历史消息一起送过去
在 LangChain 里:
 图:无记忆的调用 vs 有记忆、有上下文优化的调用(LangChain 实现)
LangGraph 提供了三种管理上下文的方法(上下文工程是构建在 LangGraph 之上的):
| 上下文类型 | 描述 | 可变性 | 生命周期 | 访问方法 |
|---|---|---|---|---|
| 动态运行时上下文 | 单次运行中会演变的可变数据 | 动态 | 单次运行 | LangGraph state 对象 |
| 动态跨会话上下文 | 对话间共享的持久数据(用户偏好、历史洞察、知识条目) | 动态 | 跨对话 | LangGraph store 对象 |
| 静态运行时上下文 | 启动时传入的用户元数据、工具、数据库连接 | 静态 | 单次运行 | LangGraph context 对象 |
记忆分为两类:
| 类型 | 别名 | 作用范围 |
|---|---|---|
| 短期记忆 | 会话级记忆 / thread-scoped memory | 单个对话线程(Thread)内,换了 thread_id 记忆即消失 |
| 长期记忆 | 跨会话级记忆 | 会话线程间共享,范围是任意自定义命名空间(下一篇) |
版本变化:LangChain v0.x 用专用的 xxxMemory 类管理记忆;v1.x 因为 Agent 构建在 LangGraph 图结构之上,改用 state(短期) 和 store(长期) 构建记忆系统——更简单、功能更统一。
 图:上下文工程做的事——从全部历史里筛出最相关的几轮,再把老的压成摘要
LangChain 1.x 的短期记忆是三者的组合:
| 组件 | 职责 |
|---|---|
| State(会话内部状态) | 默认存储历史消息列表 messages,通过 State 管理历史消息 |
| Checkpointer(持久化机制) | 把 State 作为检查点持久化保存,检查点是某个时刻的 State 快照 |
| Thread ID(会话作用域) | 唯一标识 State,运行时按 thread_id 读写 State 快照 |
像玩 RPG 游戏的”自动存档”:你不需要手动保存,系统在关键节点自动记录,下次进入游戏随时可以从上次的存档点继续。
最便捷的方式,适合快速测试或调试:
from langgraph.checkpoint.memory import InMemorySaverfrom langchain.agents import create_agentfrom langchain_core.messages import HumanMessage
checkpointer = InMemorySaver()
agent = create_agent( model=model, checkpointer=checkpointer, # ← 1. 加检查点)
config = {"configurable": {"thread_id": "1"}} # ← 2. 指定会话 ID
agent.invoke({"messages": [HumanMessage("你好,我叫小明")]}, config=config)agent.invoke({"messages": [HumanMessage("我叫什么?")]}, config=config) # ← 3. 用同一个 config# 这次它就能答上来了实测记忆的效果:同一个 thread_id 的第二轮,发给模型的消息是
['你好,我叫小明', '好的。', '我叫什么?']——历史被自动带上了。
换成 thread_id="2" 再问同样的问题,发给模型的只剩 ['我叫什么?']——记忆是按 thread_id 隔离的,新会话就是一张白纸。
内存里的检查点在进程结束就没了,生产环境不可接受,所以要换成持久化的外部存储(如 PostgreSQL)。
LangChain 支持的 checkpointer 后端列表见官方文档「Persistence」。以 PostgreSQL 为例:
pip install langgraph-checkpoint-postgres数据库环境准备:课程是在**云服务器(Ubuntu 系统)**上装 PostgreSQL 的,具体步骤见资料包 02-资料 下的《Linux云服务器安装与PostgreSQL安装》。连接串里的用户名、密码、IP 都要换成自己的:
postgresql://langchain_user:abcd1234@118.195.128.47:5432/langchain_db?sslmode=disable118.195.128.47 是课程云服务器的 IP,本地跑就换成 localhost。
from langgraph.checkpoint.postgres import PostgresSaver
DB_URL = "postgresql://langchain_user:abcd1234@<你的IP>:5432/langchain_db?sslmode=disable"
with PostgresSaver.from_conn_string(DB_URL) as checkpointer: checkpointer.setup() # ← 初始化数据库表结构(第一次要跑)
agent = create_agent(model=model, checkpointer=checkpointer) ...课程强调:依赖版本可能冲突,课程环境的依赖都在 requirements.txt 里预置了,不要重复安装。自己项目里装之前先看版本。
| InMemorySaver | PostgresSaver | |
|---|---|---|
| 存储位置 | 进程内存 | 外部数据库 |
| 进程重启 | ❌ 数据丢失 | ✅ 保留 |
| 跨进程共享 | ❌ 不支持 | ✅ 支持 |
| 适用 | 开发调试、快速验证 | 生产环境 |
内存和上下文都会无限膨胀——消息越来越多(token 消耗增加,甚至超过模型的 token 限制),响应变慢、成本上升。课程把”为什么必须治理”归纳成四条:
| # | 理由 |
|---|---|
| 1 | LLM 的上下文窗口是有限的,完整历史可能无法装入,导致上下文丢失或错误 |
| 2 | 即便模型的上下文窗口够大,多数 LLM 在长上下文场景仍然表现不佳——模型会被陈旧或离题的内容”分散注意力” |
| 3 | 高昂的 token 花费 |
| 4 | 需要对历史记录进行压缩、清理、重组等管理动作 |
三种处理手段:
| 手段 | 时机 | 特点 | 适合 |
|---|---|---|---|
| 裁剪 | 调用模型前 | 控制”模型能看到多少”,通常保留系统初始消息 + 最近若干条 | 成本敏感、对旧上下文依赖不强 |
| 删除 | 模型调用完成后 | 永久从状态里移除消息 | 明确要遗忘、清理、重置某段历史 |
| 摘要 | 达到阈值时 | 把早期历史压缩成摘要替换原文(保语义不保原文) | 长会话的折中方案 |
from typing import Any
from langchain.agents import AgentState, create_agentfrom langchain.agents.middleware import before_modelfrom langchain_core.messages import RemoveMessagefrom langgraph.graph.message import REMOVE_ALL_MESSAGESfrom langgraph.runtime import Runtime
@before_modeldef trim_messages(state: AgentState, runtime: Runtime) -> dict[str, Any] | None: messages = state["messages"] if len(messages) <= 3: return None
first_msg = messages[0] # 保留开头(比如系统提示) recent_messages = messages[-3:] # 保留最近几条 new_messages = [first_msg, *recent_messages]
return { "messages": [ RemoveMessage(id=REMOVE_ALL_MESSAGES), # 先全部清掉 *new_messages, # 再放回要保留的 ] }
agent = create_agent(model=model, middleware=[trim_messages], checkpointer=InMemorySaver())实测效果(keep=最近 3 条):消息数涨到 5 条时触发裁剪 → 裁剪后仍回到 5 条,之后每轮都稳定在 5 条,不再无限增长。
消息列表是人机交替的(HumanMessage → AIMessage → HumanMessage → ……)。如果裁剪时不管这一层,切出来的片段很可能是”从一条 AIMessage 开头”的——模型看到的第一条就是自己的话,等于上下文对不齐。课程用一个小技巧解决:按奇偶决定切几条。
@before_modeldef trim_messages(state: AgentState, runtime: Runtime) -> dict[str, Any] | None: messages = state["messages"] if len(messages) <= 3: return None
first_msg = messages[0] # 目标是让"切出来的片段以 AIMessage 开头"(因为前面要接一条 HumanMessage): # 总数是偶数 → 最后 3 条正好以 A 开头([A, H, A]);总数是奇数 → 取 4 条才以 A 开头([A, H, A, H]) recent_messages = messages[-3:] if len(messages) % 2 == 0 else messages[-4:] new_messages = [first_msg] + recent_messages
return {"messages": [RemoveMessage(id=REMOVE_ALL_MESSAGES), *new_messages]}课程用 [H1, A1, H2, A2, H3](5 条,奇数)演示:messages[-4:] 取出 [A1, H2, A2, H3],加上第一条 H1 之后,模型看到的还是 [H1, A1, H2, A2, H3]——这一轮一条都没剪掉(长度 5 时刚好回到原样)。这正说明”随便切几条”会出问题:奇偶判断的用意是让片段以 AI 消息开头,这样拼上保留的首条之后整份列表仍然严格人机交替;否则模型看到的第一条就是自己的话,上下文会对不齐。
本机假服务端实测(同一份中间件跑四轮对话,抓每次真正发往模型的 messages):
| 轮次 | 用户输入 | 裁剪前 state 长度 | 切出的片段 | 实际发给模型的消息 |
|---|---|---|---|---|
| 1 | 你好,我是老王 | 1 | 不触发 | [H: 你好,我是老王] |
| 2 | 从现在起,你叫小王 | 3 | 不触发 | [H, A, H] |
| 3 | 今天天气不错 | 5(奇数) | [-4:] | [H1, A1, H2, A2, H3]——5 条,等于没剪 |
| 4 | 告诉我,你是谁?我是谁? | 7(奇数) | [-4:] | [H1, A2, H3, A4, H5]——这次真剪掉了 |
换掉奇偶判断、固定写 messages[-3:] 再跑一遍,第 3 轮发给模型的消息变成 [H1, H2, A2, H3](4 条)——开头是一条 HumanMessage,后面紧跟着又是 HumanMessage,人机不再交替,这正是要避免的。
结论:len(messages) % 2 这个判断不是”玄学”——它保证切出来的片段永远从 HumanMessage 开始,人机成对。
from langchain.agents.middleware import after_modelfrom langchain_core.messages import RemoveMessage
@after_modeldef delete_old_messages(state: AgentState, runtime: Runtime) -> dict | None: messages = state["messages"] if len(messages) > 5: to_delete = len(messages) - 5 # 用 RemoveMessage 标记删除,返回出去让框架真正移除 return {"messages": [RemoveMessage(id=m.id) for m in messages[:to_delete]]} return None
agent = create_agent(model=model, middleware=[delete_old_messages], checkpointer=InMemorySaver())关键区别:裁剪是”这次调用不给模型看”,删除是”从状态里彻底抹掉”(永久生效)。
 图:两条路线——Summarize 把早期历史压成摘要,Filter 只保留要用的消息
消息裁剪和删除都会导致上下文缺失,影响回答质量和用户体验。相比之下,摘要是更适合长会话的折中方案:保语义,不保原文。
官方推荐直接用内置的 SummarizationMiddleware(第 19 篇详细讲过它的参数和实测效果),不必自己写。
裁剪、删除、摘要只是三种”教科书套路”。课程强调:通过中间件可以随意更改消息列表,因此可以实现任意的过滤策略(课程未演示,留作练习)。
这一点很关键——因为 before_model / after_model 拿到的是完整的 state["messages"],返回的又是”新的消息列表”,所以”怎么筛”完全由你决定:
| 过滤策略 | 思路 |
|---|---|
| 按角色筛 | 只保留 HumanMessage / 丢掉中间的工具往返消息 |
| 按内容筛 | 命中关键词(订单号、身份证、金额)的消息永远保留,其余按时间裁剪 |
| 按重要性筛 | 给消息打标记,重要消息进”白名单”,裁剪时优先保住 |
| 按类型筛 | 丢掉 ToolMessage 这类冗长的中间过程,只留人机对话 |
自定义过滤没有内置保护:删错了就真的丢了。判断”哪条重要”这件事,最终还是得靠你自己写规则(或者像下一篇那样,把重要事实搬进长期记忆里——那才是它真正该待的地方)。
state 是 Agent 底层有状态运行图的状态信息,是 AgentState 类型的实例:
class AgentState(TypedDict, Generic[ResponseT]): """State schema for the agent."""
messages: Required[Annotated[list[AnyMessage], add_messages]] jump_to: NotRequired[Annotated[JumpTo | None, EphemeralValue, PrivateStateAttr]] structured_response: NotRequired[Annotated[ResponseT, OmitFromInput]]AgentState 是 TypedDict 的子类,所以可以按字典的方式读写。它有三个字段(实测 AgentState.__annotations__ 正是这三个):
| 字段 | 说明 |
|---|---|
messages | 截止当前节点的历史会话消息记录,Required(必填) |
jump_to | 跳转到运行图的指定节点(第 21 篇的流程跳转),可以为 None |
structured_response | 启用结构化输出时,结构化后的内容记录在这里(第 16 篇) |
课程用一个”伪造工具调用 + 三个钩子打点”的例子,把这两个字段在一轮运行中的取值变化抓了出来。核心是:用 @before_model(can_jump_to=["tools"]) 人工造一条带 tool_calls 的 AIMessage,然后 jump_to="tools" 跳过模型、直奔工具节点。
from typing import Any, Callable
from pydantic import BaseModel, Field
from langchain.agents import AgentState, create_agentfrom langchain.agents.middleware import after_agent, before_model, wrap_tool_callfrom langchain_core.messages import AIMessage, HumanMessage, ToolMessagefrom langchain.tools import toolfrom langchain.tools.tool_node import ToolCallRequestfrom langgraph.runtime import Runtimefrom langgraph.types import Command
class WeatherInfo(BaseModel): """城市天气情况""" city: str = Field(description="城市名称") temperature: str = Field(description="气温") desc: str = Field(description="当日天气概述")
@tool(parse_docstring=True)def get_weather(city: str): """获取当日天气
Args: city: 城市名称 """ return f"[{city}] 今天气温9~16度,万里无云,天气不错适合外出"
@before_model(can_jump_to=["tools"])def direct_tool_call(state: AgentState, runtime: Runtime) -> dict[str, Any] | None: last_msg = state["messages"][-1] if isinstance(last_msg, HumanMessage) and "天气" in last_msg.text and "北京" in last_msg.text: fake_tool_call = AIMessage( # 人工伪造一条"模型想调工具"的消息 content="人工构造的消息", tool_calls=[{"name": "get_weather", "args": {"city": "北京"}, "id": "direct_call_id"}], ) return {"messages": [fake_tool_call], "jump_to": "tools"} # ← 直接跳工具节点 return None
@wrap_tool_calldef first_check( request: ToolCallRequest, handler: Callable[[ToolCallRequest], ToolMessage | Command],) -> ToolMessage | Command: print("=" * 30, '-> In first_check Middleware <-', "=" * 30) print(f"{request.state.get('jump_to', None) = }") print(f"{request.state.get('structured_response', None) = }") return handler(request)
@after_agentdef final_check(state: AgentState, runtime: Runtime) -> dict[str, Any] | None: print("=" * 30, '-> In final_check Middleware <-', "=" * 30) for msg in state["messages"]: msg.pretty_print() print(f"{state.get('jump_to', None) = }") print(f"{state.get('structured_response', None) = }") return None
agent = create_agent( model=model, response_format=WeatherInfo, # ← 开启结构化输出 middleware=[direct_tool_call, first_check, final_check], tools=[get_weather],)
agent.invoke({"messages": [HumanMessage("请帮我查询北京当日天气")]})输出(课程实测,两个打点各打一次):
============================== -> In first_check Middleware <- ==============================request.state.get('jump_to', None) = 'tools'request.state.get('structured_response', None) = None============================== -> In final_check Middleware <- ============================================================== Human Message =================================请帮我查询北京当日天气================================== Ai Message ==================================人工构造的消息Tool Calls: get_weather (direct_call_id) Call ID: direct_call_id Args: city: 北京================================= Tool Message =================================Name: get_weather[北京] 今天气温9~16度,万里无云,天气不错适合外出================================== Ai Message =================================={"city":"北京","temperature":"9~16℃","desc":"万里无云,天气不错适合外出"}============================== -> 消息打印完毕 <- ==============================state.get('jump_to', None) = Nonestate.get('structured_response', None) = WeatherInfo(city='北京', temperature='9~16℃', desc='万里无云,天气不错适合外出')课程的分析(三条):
jump_to 直接跳转至工具节点jump_to 非空structured_response 非空,而 jump_to 为空本机假服务端实测:jump_to 的两段式变化完全复现——
============================== -> In first_check Middleware <- ==============================request.state.get('jump_to', None) = 'tools'request.state.get('structured_response', None) = None...============================== -> 消息打印完毕 <- ==============================state.get('jump_to', None) = None说明这两个字段都是**“过程性”的**:jump_to 是临时跳转意图(EphemeralValue + PrivateStateAttr,跳完就清掉,所以 after_agent 里已经是 None);structured_response 是跑完才写进去的最终产物(OmitFromInput,只在输出侧可见)。
print(f"{state.get('jump_to', None) = }") 用的是 f-string 的 = 说明符——它会连”表达式本身”一起打出来,所以输出长这样:state.get('jump_to', None) = None。调试状态时非常省事。
顺带一提:f-string 表达式里嵌套同种引号(f"{d.get("k")}")在 Python 3.12+(PEP 701) 才是合法的,老版本会报 SyntaxError。本课环境是 Python 3.12+,可以放心写。
Q1:为什么我的 Agent 不记得? 逐条检查:
| 检查项 | 错误示例 |
|---|---|
加 checkpointer 了吗? | create_agent(model=model, tools=[]) → 不会记住 |
调用时传 config 了吗? | 有 checkpointer 但 invoke 不传 config → 不会记住 |
两次的 thread_id 一样吗? | thread_id="1" 和 thread_id="2" 是两个会话 |
Q2:InMemorySaver 会丢数据吗? 会!它只存在内存里:同一进程内有效,程序重启后丢失、不同进程无法共享。要持久化就换 SQLite / PostgreSQL。
Q3:内存会无限增长吗? 会!默认保存所有消息,所以必须做上下文管理(裁剪 / 删除 / 摘要)。
Q4:怎么清空某个会话的历史? 目前 InMemorySaver 没有提供删除 API,临时方案是换一个新的 thread_id(或重新创建 Agent)。
state 对象、对话间共享的持久数据用 store 对象、启动时传入的静态元数据用 context 对象。xxxMemory 类管记忆,v1.x 改用 state(短期)和 store(长期)。messages 的会话内部状态)、Checkpointer(把 State 作为检查点持久化的机制)、Thread ID(唯一标识 State 的会话作用域);“检查点”就是某个时刻的 State 快照。checkpointer 参数(内存实现是 InMemorySaver());调用时传 config={"configurable": {"thread_id": ...}}。排查”它为什么不记得”就看这三样:没加checkpointer、调用时没传config、两次的 thread_id 不一样;想清空某个会话的历史,目前的临时方案是换一个新的 thread_id(它没有提供删除 API)。langgraph-checkpoint-postgres,用法是 PostgresSaver.from_conn_string(DB_URL) 上下文管理器 + 先跑一次 checkpointer.setup() 建表;连接串形如 postgresql://用户:密码@主机:5432/库名?sslmode=disable,本地跑把 IP 换成 localhost。RemoveMessage:清空全部用 id=REMOVE_ALL_MESSAGES,删除指定的单条用 id=消息的 **id**。messages[-3:] if len(messages) % 2 == 0 else messages[-4:],这样”保留的首条 + 切出来的片段”拼起来,整份列表仍然严格人机交替(不会出现两条同类消息挨在一起)。before_model / after_model 拿到的是完整的 state["messages"]、返回的又是”新的消息列表”,所以可以实现任意的过滤策略(按角色筛、按内容把命中关键词的永远保留、按重要性进白名单、按类型丢掉冗长的中间过程);但要小心:自定义过滤没有内置保护,删错了就真的丢了。AgentState 是 TypedDict 的子类(所以能按字典读写),三个字段是 messages(Required)、jump_to、structured_response;jump_to 是带 EphemeralValue + PrivateStateAttr 的”临时跳转(过程性)意图”(跳完就被清掉),structured_response 带 OmitFromInput、只在输出侧看得见;调试状态还可以用 f-string 的 = 说明符,把表达式本身也一起打出来。2-1 让 Agent 记住你 给 Agent 装上内存版检查点,用同一个会话 ID 连续问两轮:“你好,我叫小明” → “我叫什么?“,确认它答得上来;再换一个新的会话 ID 问同样的问题,观察它是不是”失忆”了。把每轮之后状态里的消息条数打印出来,并解释这个数字为什么会那样变。
一级 · 思路:记忆 = 检查点 + 会话 ID 的组合,两者缺一不可
二级 · 方法:create_agent(model=model, checkpointer=InMemorySaver());调用时传 config={"configurable": {"thread_id": "1"}}
三级 · 骨架:两次调用传同一份 config 就是同一个会话;打印 len(response["messages"]) 最直观
2-2 裁剪:给上下文”按住”上限 写一个”模型调用前”的钩子:消息数超过 4 条时,只保留第一条 + 最近几条。跑 5 轮对话,确认消息数被按住、不再无限增长。 追加要求:切出来的那一段必须从用户消息开始(不能让模型一上来就看见自己的话)。跑通之后回答:为什么会切出”以 AI 消息开头”的片段?“取最近几条”到底取几条才刚好?
一级 · 思路:裁剪发生在模型调用前,做法是”返回一份新的消息列表”;但消息是”人机交替”的,切点选错就会切出”以 AI 消息开头”的片段
二级 · 方法:@before_model 里返回 {"messages": [RemoveMessage(id=REMOVE_ALL_MESSAGES), 首条, *最近几条]};最近几条写 messages[-3:] if len(messages) % 2 == 0 else messages[-4:](调用模型前,本轮的用户消息已经在列表里了,所以总数通常是奇数)
三级 · 骨架:用一个循环跑 5 轮,每轮打印 len(response["messages"]),看它涨到某个值之后就不动了
2-3 用删除实现”永久遗忘” 写一个”模型调用完成后”的钩子:状态里的消息超过 5 条就删掉最早的几条。跑 3~4 轮,每轮把”剩余消息总数”和”还留着的用户消息”都打印出来,然后回答:删除和上一题的”裁剪”到底差在哪?
一级 · 思路:删除是”从状态里真删”,所以下一轮也看不到它——看状态本身有没有变小就知道差别
二级 · 方法:@after_model + {"messages": [RemoveMessage(id=m.id) for m in messages[:to_delete]]}(逐条标记,不能用”清空全部”那个标记)
三级 · 骨架:to_delete = len(messages) - 5,打印 [m.content for m in state["messages"] if m.type == "human"] 观察最早那条永久消失
2-4 亲眼看看状态里那两个特殊字段 写一个”模型调用前”的钩子:当用户消息里同时出现”天气”和”北京”时,跳过模型的首轮思考、自己伪造一条”模型要调工具”的消息,把控制权直接交给工具节点(顺便给这个 Agent 开上结构化输出,用一个只有城市/气温/概述三个字段的小结构)。 再挂两个打点:① 用”包裹工具调用”的钩子打印状态里的两个特殊字段;② 用”Agent 跑完之后”的钩子打印完整消息流 + 这两个字段。 最后回答:为什么工具调用时”跳转意图”有值,而 Agent 跑完之后它变成空、另一个字段反倒有值了?
一级 · 思路:跳转要先”声明能跳到哪”,再在返回值里给出跳转目标和伪造的消息;两个打点分别抓”调用中”和”结束后”两个时刻
二级 · 方法:@before_model(can_jump_to=["tools"]) 返回 {"messages": [AIMessage(content=..., tool_calls=[{"name": ..., "args": {...}, "id": ...}])], "jump_to": "tools"};打点用 @wrap_tool_call(看 request.state)和 @after_agent(看 state)
三级 · 骨架:state.get("jump_to", None) 与 state.get("structured_response", None),两个打点各打印一次做对比
# ========== 本篇所有答案共用的开头(模型创建) ==========import os
from dotenv import load_dotenvfrom langchain.agents import create_agentfrom langchain.chat_models import init_chat_model
load_dotenv(override=True)
model = init_chat_model( model="deepseek-v4-flash", model_provider="openai", api_key=os.getenv("DEEPSEEK_API_KEY"), base_url=os.getenv("DEEPSEEK_BASE_URL"),)
# ---------- 2-1 让 Agent 记住你 ----------from langchain_core.messages import HumanMessagefrom langgraph.checkpoint.memory import InMemorySaver
agent = create_agent(model=model, checkpointer=InMemorySaver())
same = {"configurable": {"thread_id": "1"}} # 同一个会话 IDr1 = agent.invoke({"messages": [HumanMessage("你好,我叫小明")]}, config=same)print(f"[同会话] 第 1 轮后 state 消息数: {len(r1['messages'])}")r2 = agent.invoke({"messages": [HumanMessage("我叫什么?")]}, config=same)print("[同会话] 回答:", r2["messages"][-1].content)print(f"[同会话] 第 2 轮后 state 消息数: {len(r2['messages'])}") # 历史被自动带上了
other = {"configurable": {"thread_id": "2"}} # 换一个会话 IDr3 = agent.invoke({"messages": [HumanMessage("我叫什么?")]}, config=other)print("[新会话] 回答:", r3["messages"][-1].content)print(f"[新会话] state 消息数: {len(r3['messages'])}") # 只有本轮,新会话是白纸
# ---------- 2-2 裁剪:首条 + 最近几条(保证人机成对) ----------from typing import Any
from langchain.agents import AgentStatefrom langchain.agents.middleware import before_modelfrom langchain_core.messages import RemoveMessagefrom langgraph.graph.message import REMOVE_ALL_MESSAGESfrom langgraph.runtime import Runtime
@before_modeldef trim_messages(state: AgentState, runtime: Runtime) -> dict[str, Any] | None: messages = state["messages"] if len(messages) <= 4: return None
first_msg = messages[0] # 让片段以 AI 消息开头:偶数取 3 条([A,H,A])、奇数取 4 条([A,H,A,H]) recent_messages = messages[-3:] if len(messages) % 2 == 0 else messages[-4:] print(f" [裁剪] {len(messages)} 条 → 首条 + 最近 {len(recent_messages)} 条")
return { "messages": [ RemoveMessage(id=REMOVE_ALL_MESSAGES), # 先全部清掉 first_msg, *recent_messages, # 再放回要保留的 ] }
agent_trim = create_agent(model=model, middleware=[trim_messages], checkpointer=InMemorySaver())cfg_trim = {"configurable": {"thread_id": "trim"}}for i in range(1, 6): rt = agent_trim.invoke({"messages": [HumanMessage(f"第 {i} 句话")]}, config=cfg_trim) print(f"第 {i} 轮后 state 消息数: {len(rt['messages'])}")# 涨到 6 条之后被按住,稳定在同一水平,不再无限增长
# ---------- 2-3 删除:永久遗忘 ----------from langchain.agents.middleware import after_model
@after_modeldef delete_old_messages(state: AgentState, runtime: Runtime) -> dict | None: messages = state["messages"] if len(messages) > 5: to_delete = len(messages) - 5 print(f" [删除] 永久删除最早的 {to_delete} 条") # 逐条标记删除,返回出去让框架真正移除 return {"messages": [RemoveMessage(id=m.id) for m in messages[:to_delete]]} return None
agent_del = create_agent(model=model, middleware=[delete_old_messages], checkpointer=InMemorySaver())cfg_del = {"configurable": {"thread_id": "delete"}}for i in range(1, 4): rd = agent_del.invoke({"messages": [HumanMessage(f"第 {i} 句话")]}, config=cfg_del) left = [m.content for m in rd["messages"] if m.type == "human"] print(f"第 {i} 轮后 state 消息数: {len(rd['messages'])},剩下的用户消息 {left}")# 第 3 轮触发删除:最早那条真的从 state 里消失了(下一轮也再也看不到)
# ---------- 2-4 亲眼看看 state 里那两个字段 ----------from pydantic import BaseModel, Field
from langchain.agents.middleware import after_agent, wrap_tool_callfrom langchain_core.messages import AIMessagefrom langchain.tools import toolfrom langchain.tools.tool_node import ToolCallRequest
class WeatherInfo(BaseModel): """城市天气情况"""
city: str = Field(description="城市名称") temperature: str = Field(description="气温") desc: str = Field(description="当日天气概述")
@tool(parse_docstring=True)def get_weather(city: str): """获取当日天气
Args: city: 城市名称 """ return f"[{city}] 今天气温9~16度,万里无云,天气不错适合外出"
@before_model(can_jump_to=["tools"]) # ← 要跳转就得先声明能跳到哪def direct_tool_call(state: AgentState, runtime: Runtime) -> dict[str, Any] | None: last_msg = state["messages"][-1] if isinstance(last_msg, HumanMessage) and "天气" in last_msg.text and "北京" in last_msg.text: fake_tool_call = AIMessage( # 人工伪造一条"模型想调工具"的消息 content="人工构造的消息", tool_calls=[{"name": "get_weather", "args": {"city": "北京"}, "id": "direct_call_id"}], ) return {"messages": [fake_tool_call], "jump_to": "tools"} # ← 跳过模型,直奔工具节点 return None
@wrap_tool_calldef check_before_tool(request: ToolCallRequest, handler): print("--- 工具调用前 ---") print(f"{request.state.get('jump_to', None) = }") # 此刻跳转意图还在 print(f"{request.state.get('structured_response', None) = }") return handler(request)
@after_agentdef check_after_agent(state: AgentState, runtime: Runtime) -> dict[str, Any] | None: print("--- Agent 跑完之后 ---") for msg in state["messages"]: print(f" {type(msg).__name__:15s} {str(msg.content)[:50]}") print(f"{state.get('jump_to', None) = }") # 跳完就清掉了 → None print(f"{state.get('structured_response', None) = }") # 跑完才写进去 → 非空 return None
agent_state = create_agent( model=model, response_format=WeatherInfo, # 开启结构化输出,结果写进 structured_response middleware=[direct_tool_call, check_before_tool, check_after_agent], tools=[get_weather],)agent_state.invoke({"messages": [HumanMessage("请帮我查询北京当日天气")]})3-1 给”带记忆的客服助手”加一条白名单 在”带记忆的客服助手”(内存检查点 + 系统提示词”记住用户告诉你的订单号”)基础上,写一个自己的过滤规则(不是教科书式的裁剪),要求同时满足:
然后按这个顺序跑:先打个招呼 → 报订单号 → 立刻追问(应该答得上)→ 聊 5 轮无关内容 → 最后再问一次订单号。 再做一个对照实验:把第 2 条规则去掉、只留”最早一条 + 最近 4 条”,重跑一遍,看看最后那次还答不答得上来;解释这个现象,并说明这类关键事实本该存在哪里。
一级 · 思路:过滤就是”自己决定返回哪份消息列表”;白名单的做法是——先算出一批要保留的消息,剩下的逐条删掉
二级 · 方法:@before_model 里用 {m.id for m in messages if "订单号" in str(m.content)} 收集白名单,再用 RemoveMessage(id=m.id) 删掉 keep_ids 之外的消息
三级 · 骨架:keep_ids = {messages[0].id} | 白名单 | {m.id for m in messages[-4:]};dropped = [m for m in messages if m.id not in keep_ids]——把”白名单”那一项去掉,就是对照实验
# ========== 综合题答案(模型创建部分同上) ==========import osfrom typing import Any
from dotenv import load_dotenvfrom langchain.agents import AgentState, create_agentfrom langchain.agents.middleware import before_modelfrom langchain.chat_models import init_chat_modelfrom langchain_core.messages import HumanMessage, RemoveMessagefrom langgraph.checkpoint.memory import InMemorySaverfrom langgraph.runtime import Runtime
load_dotenv(override=True)
model = init_chat_model( model="deepseek-v4-flash", model_provider="openai", api_key=os.getenv("DEEPSEEK_API_KEY"), base_url=os.getenv("DEEPSEEK_BASE_URL"),)
# ---------- 3-1 客服助手:给上下文管理加一条"白名单" ----------KEEP_KEYWORD = "订单号"
@before_modeldef filter_messages(state: AgentState, runtime: Runtime) -> dict[str, Any] | None: """自定义过滤:首条 + 命中关键词的消息永久保留,其余只留最近 4 条""" messages = state["messages"] if len(messages) <= 6: return None
# 注意:system_prompt= 传进去的系统提示并不在 state["messages"] 里, # 所以这里的 messages[0] 就是最早的那条用户消息 keep_ids = {messages[0].id} # ① 最早的一条 keep_ids |= {m.id for m in messages if KEEP_KEYWORD in str(m.content)} # ② 关键事实白名单 keep_ids |= {m.id for m in messages[-4:]} # ③ 最近 4 条
dropped = [m for m in messages if m.id not in keep_ids] if not dropped: return None print(f" [过滤] {len(messages)} 条 → 保留 {len(keep_ids)} 条、丢掉 {len(dropped)} 条")
# 没进白名单的消息——永久删掉(这里没有内置保护,规则全靠自己写) return {"messages": [RemoveMessage(id=m.id) for m in dropped]}
SYSTEM = "你是客服助手,记住用户告诉你的订单号等关键信息,并在被问到时准确回答。"
agent_cs = create_agent( model=model, system_prompt=SYSTEM, middleware=[filter_messages], checkpointer=InMemorySaver(),)cfg_cs = {"configurable": {"thread_id": "cs-1"}}
print("[1] 先打个招呼")agent_cs.invoke({"messages": [HumanMessage("你好,在吗?")]}, config=cfg_cs)print("[2] 报订单号")print(" AI:", agent_cs.invoke({"messages": [HumanMessage("我的订单号是 A12345")]}, config=cfg_cs)["messages"][-1].content[:60])print("[3] 立刻追问(记得)")print(" AI:", agent_cs.invoke({"messages": [HumanMessage("我的订单号是多少?")]}, config=cfg_cs)["messages"][-1].content[:60])print("[4] 再聊 5 轮无关内容")for q in ["今天天气怎么样?", "你们发货快吗?", "支持退货吗?", "有优惠活动吗?", "客服几点下班?"]: agent_cs.invoke({"messages": [HumanMessage(q)]}, config=cfg_cs)print("[5] 最后再问一次订单号")print(" AI:", agent_cs.invoke({"messages": [HumanMessage("我的订单号是多少?")]}, config=cfg_cs)["messages"][-1].content[:80])# 白名单规则生效 → 订单号还在;把 KEEP_KEYWORD 那条规则去掉再跑一遍,[5] 就答不上来了# ——这就是"关键事实该进长期记忆"的原因(下一篇)如果你喜欢,那么欢迎来到我的世界!
了解更多暂未播放