国庆节10月1日
--

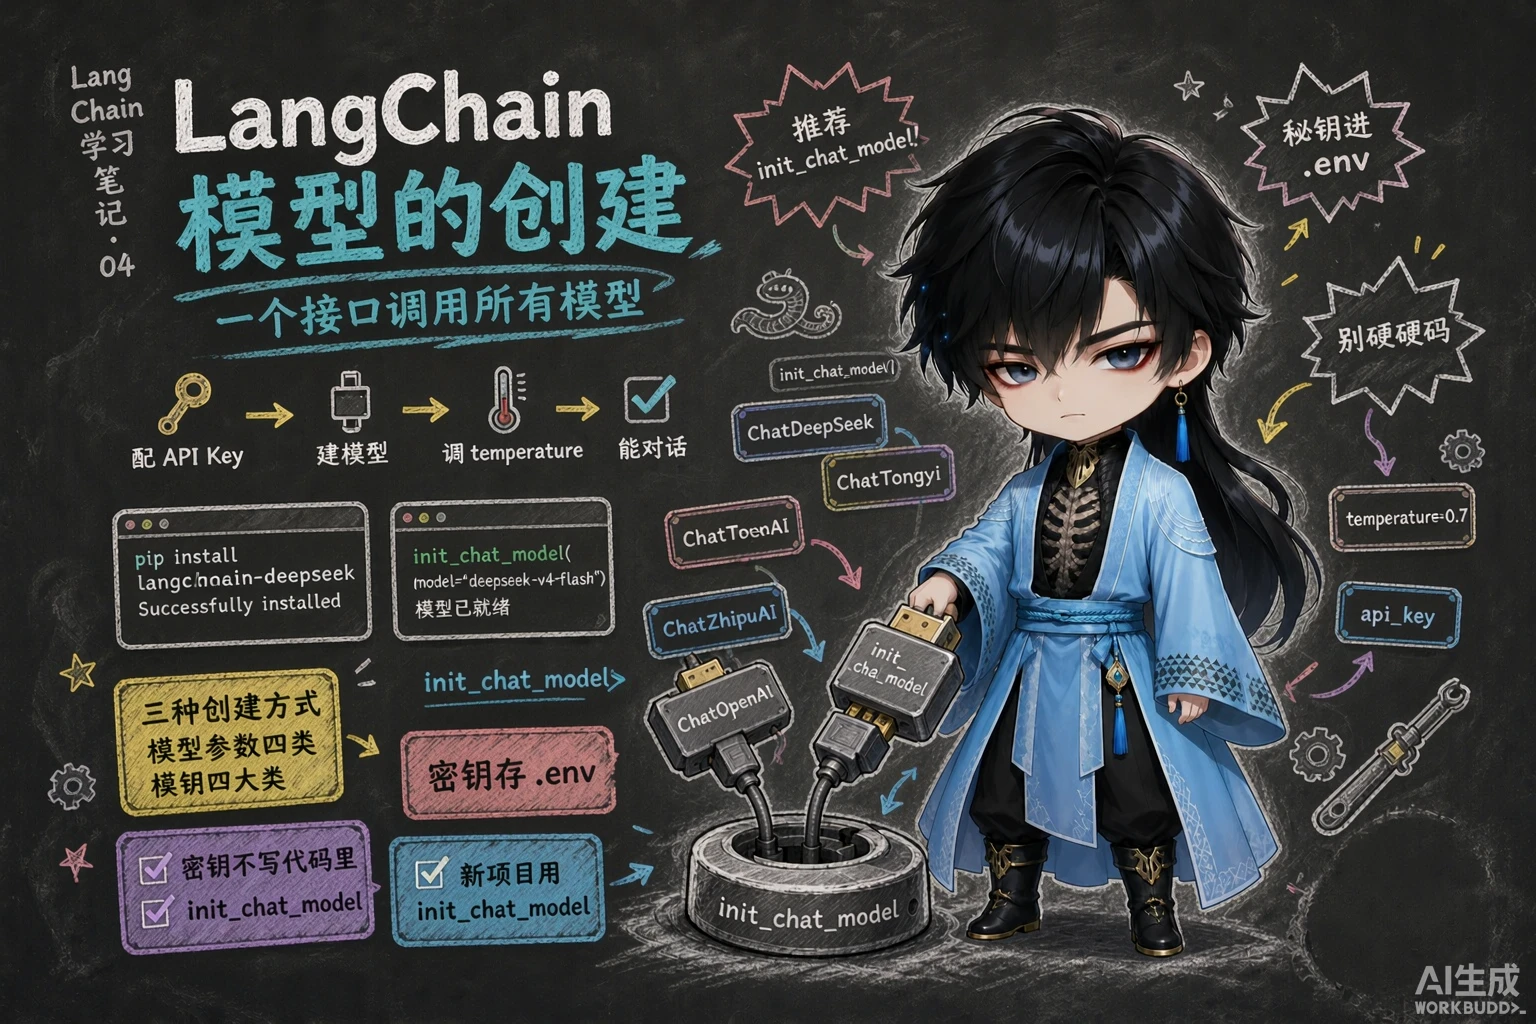
LangChain 创建对话模型的三种方式:专用模型类、ChatOpenAI 兼容调用、init_chat_model 统一接口,以及常用初始化参数
LangChain v0.3 里把模型的调用抽象成 Model I/O 三件套:输入提示(Format)→ 调用模型(Predict)→ 输出解析(Parse),分别对应 Prompt Template、Model、Output Parser。
 图:Model I/O 三件套的调用链路——Format 生成提示词、Predict 交给 LLM 或 Chat Model、Parse 解析成结构化结果
历史演化:GPT-3 时代是补全模型(只能”成语接龙”式补全文本,很不稳定),很多功能要靠 LangChain 的高层封装;GPT-3.5 之后对话模型成为主流,凭借更强的指令跟随能力,工具调用、结构化输出等成了模型自带能力。
所以本章只讲对话模型的创建,不再有非对话模型(1.x 里也一样:模型默认就是”聊天模型”)。
一句话概括:用谁家的 API、以什么方式创建、存放在哪个位置的大模型。
| 角度 | 选项 | 建议 |
|---|---|---|
| 1. 调用谁家的 API | ① 使用模型提供商的库(ChatDeepSeek、ChatZhipuAI…)② 使用 LangChain 统一方式 | 推荐统一方式 |
| 2. 重要参数(BASE_URL、API-KEY)写在哪 | ① 配置文件(.env)② 硬编码在代码里 | 推荐配置文件 |
| 3. 模型部署在哪 | ① 在线部署 ② 本地部署(Ollama) | 按需 |
LangChain 本身不提供任何 LLM,它只是个”工具箱”,靠第三方集成各种大模型——所以第一件事永远是搞清”模型到底在哪、用什么协议调”。
常见平台(使用方式都一样:注册 → 充值 → 创建 API Key):
| 平台 | 网址 | 备注 |
|---|---|---|
| OpenRouter | https://openrouter.ai/ | 全球主流,含国外模型(支持国内直连,支付宝/微信充值,最低 $5) |
| CloseAI | https://platform.closeai-asia.com/ | 亚洲最大,含国外模型 |
| 阿里云百炼 | https://bailian.console.aliyun.com/ | 企业端友好,新用户有大量免费额度 |
| 硅基流动 | https://www.siliconflow.cn/ | 性价比高,适合个人(号称 9B 以下模型永久免费) |
| 百度千帆 | https://console.bce.baidu.com/qianfan/overview | 主打百度生态 |
| 火山引擎 | https://console.volcengine.com/ark/ | 主打字节多模态生态 |
 图:平台使用前的充值页(以 CloseAI 为例,支持微信/支付宝,最低 5 美元)
每个平台配置时都需要三个要素:模型名、api-key、base-url。
想用国外模型选前两个平台;只用国内模型选后四个。此外各厂商自己的平台(DeepSeek、智谱等)也可以直接用。
课程所有依赖都固定在 requirements.txt 里(LangChain 版本变化快,必须固定版本避免兼容问题):
pip install -r .\requirements.txt 图:按 requirements.txt 安装依赖时的终端输出(一次性把本章要用的库都装上)
本章单独需要的:
pip install langchain-deepseek # DeepSeek 专用(会自动带出 langchain-openai)pip install langchain-openai # ChatOpenAI(兼容调用用)pip install python-dotenv # 读 .env项目根目录创建 .env:
DEEPSEEK_API_KEY=<Your API Key>DEEPSEEK_BASE_URL=https://api.deepseek.com读取配置:
import osfrom dotenv import load_dotenv
load_dotenv(override=True) # override=True:强行用 .env 里的值覆盖已有环境变量
DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")DEEPSEEK_BASE_URL = os.getenv("DEEPSEEK_BASE_URL").env 里不要加引号(KEY="xxx" 会把引号也读进去);.env 必须加入 .gitignore,密钥不能提交到仓库。
角度 2 的另一种写法,是把密钥和地址直接写死在代码里:
from langchain_deepseek import ChatDeepSeek
# 创建DeepSeek LLMdeepseek_llm = ChatDeepSeek( api_key="sk-2nkIWkv6M...U1Ra4P0NGa", # 明文暴露密钥 api_base="https://api.deepseek.com", model="deepseek-v4-flash",)print(deepseek_llm.invoke("请介绍一下你自己"))直接把 API Key 写进代码仅适用于临时测试:代码一旦被分享、提交、截图,密钥就等于泄露,别人可以拿它跑光你的余额。生产环境一律用 .env + load_dotenv(),并把 .env 加进 .gitignore 避免泄露。
LangChain 为一些厂商提供了专门的 Model 类:ChatOpenAI、ChatAnthropic、ChatDeepSeek、ChatOllama、ChatTongyi、ChatZhipuAI 等。
 图:官方 API 参考里列出的各种专用模型类(ChatZhipuAI、ChatTongyi、ChatCoze…)
from langchain_deepseek import ChatDeepSeek
from dotenv import load_dotenv
load_dotenv(override=True)
# 简化写法:ChatDeepSeek 会自动从环境变量 DEEPSEEK_API_KEY 读取密钥deepseek_llm = ChatDeepSeek(model="deepseek-v4-flash")
print(deepseek_llm.invoke("请介绍一下你自己"))不同厂商的参数名不一样,要以源码/官方文档为准。比如 ChatDeepSeek 里 API 地址参数叫 api_base(不是 base_url),模型名参数既接受 model 也接受 model_name:
deepseek_llm = ChatDeepSeek(api_key=DEEPSEEK_API_KEY, api_base=DEEPSEEK_BASE_URL, model="deepseek-v4-flash")智谱的专用类不在 langchain-deepseek 这类厂商包里,而是在社区包 langchain-community 里(同一个包里还有 ChatHunyuan、ChatTongyi)。
# 安装 Langchain 社区依赖包,包含ChatHunyuan、ChatTongyi、ChatZhipuAIpip install langchain-community# ChatZhipuAI / 智谱 AI 认证相关依赖pip install pyjwt在 .env 中补充:
ZHIPUAI_API_KEY=<Your API Key>ZHIPUAI_BASE_URL=https://open.bigmodel.cn/api/paas/v4/import osfrom langchain_community.chat_models import ChatZhipuAIfrom dotenv import load_dotenv
# override=True 确保.env文件优先load_dotenv(override=True)
ZHIPUAI_API_KEY = os.getenv("ZHIPUAI_API_KEY")ZHIPUAI_BASE_URL = os.getenv("ZHIPUAI_BASE_URL")
zhipu_llm = ChatZhipuAI( model="glm-5.1", api_base=ZHIPUAI_BASE_URL, # 可选 api_key=ZHIPUAI_API_KEY, # 可选)print(zhipu_llm.invoke("请介绍一下你自己"))用之前确保账号的余额或免费额度大于零,否则调用会直接失败。
通过阿里云百炼平台调用(https://bailian.console.aliyun.com/),专用类同样来自社区包:
# 切换python环境conda activate langchain1.2# ChatTongyi / 阿里通义千问依赖包pip install dashscope.env 里只需要密钥:
DASHSCOPE_API_KEY=<Your API Key>import osfrom langchain_community.chat_models import ChatTongyifrom dotenv import load_dotenv
# override=True 确保.env文件优先load_dotenv(override=True)
DASHSCOPE_API_KEY = os.getenv("DASHSCOPE_API_KEY")
tongyi_llm = ChatTongyi( api_key=DASHSCOPE_API_KEY, model="qwen-plus",)print(tongyi_llm.invoke("请介绍一下你自己"))一般不要添加 DASHSCOPE_BASE_URL 这样的环境变量(值为 https://dashscope.aliyuncs.com/compatible-mode/v1)。百炼平台提供了专用 SDK 和 OpenAI 兼容接口两种访问方式,这个 URL 是给后者准备的;而 ChatTongyi 底层是基于专用 SDK 实现的,一旦指定了它就会运行报错:
Traceback...ConnectionError: ('Connection aborted.', ConnectionResetError(10054, '远程主机强迫关闭了一个现有的连接。', None, 10054, None))大多数 API 平台都支持 OpenAI API 接口规范,所以基本都可以用 ChatOpenAI 集成。这在两种情况下特别有用:
APP_ID + SecretId + SecretKey 三件套) 图:DeepSeek 官方文档写明它使用与 OpenAI 兼容的 API 格式,只要 base_url + api_key 就能调用
from langchain_openai import ChatOpenAI
load_dotenv(override=True)
deepseek_llm2 = ChatOpenAI( api_key=os.getenv("DEEPSEEK_API_KEY"), base_url=os.getenv("DEEPSEEK_BASE_URL"), # 换平台只改这两个 + model 名 model="deepseek-v4-flash",)
print(deepseek_llm2.invoke("1 + 1 = ?"))“一个 ChatOpenAI 打通所有兼容平台”——这就是兼容用法的价值:换平台只需要改 base_url 和 model 两个值,代码结构完全不用动。第 3 章那个 AI 智能伴侣项目用的也是这套写法。
受政策影响,国内无法直接调用国外顶尖的闭源模型,而某些复杂任务又必须用这些模型实现,此时可以通过中转平台曲线救国。
OpenRouter(https://openrouter.ai/)是一个**多模型 API 聚合平台**,提供统一的 OpenAI 兼容接口,用一个 API Key 就能调用 OpenAI、Claude、Gemini、DeepSeek、Qwen 等不同厂商的大模型,适合模型对比、模型路由、Agent 应用开发和课程实验,是目前知名度最高的中转平台。不过使用它需要”tizi”(魔法,大家都懂的)。
# OpenRouter 模型集成pip install langchain-openrouter.env 里:
OPENROUTER_API_KEY=<YOUR_API_KEY>OPENROUTER_API_BASE=https://openrouter.ai/api/v1LangChain 当前版本为 OpenRouter 提供了专用集成 ChatOpenRouter:
import osfrom langchain_openrouter import ChatOpenRouterfrom dotenv import load_dotenv
load_dotenv(override=True)
OPENROUTER_API_KEY = os.getenv("OPENROUTER_API_KEY")# OPENROUTER_API_BASE = os.getenv("OPENROUTER_API_BASE")
model = ChatOpenRouter( model="deepseek/deepseek-v4-flash", # 注意:模型名要带厂商前缀 api_key=OPENROUTER_API_KEY, # base_url=OPENROUTER_API_BASE, # 默认就是官方地址,可省略)print(model.invoke("一句话介绍下你自己"))当然,也完全可以用 ChatOpenAI 兼容方式调用:
import osfrom langchain_openai import ChatOpenAIfrom dotenv import load_dotenv
load_dotenv(override=True)
OPENROUTER_API_KEY = os.getenv("OPENROUTER_API_KEY")OPENROUTER_API_BASE = os.getenv("OPENROUTER_API_BASE")
model = ChatOpenAI( model="deepseek/deepseek-v4-flash", api_key=OPENROUTER_API_KEY, base_url=OPENROUTER_API_BASE,)print(model.invoke("一句话介绍下你自己"))OpenRouter 支持支付宝或微信充值(最低限额 $5,税费 $0.8),但如果调用的模型禁止在国内使用(如 ChatGPT),则无法通过 OpenRouter 直接调用,会提示 This model is not available in your region。是否充值调用请按个人情况决定。
CloseAI(https://www.closeai-asia.com/)是一个面向国内用户的 AI API 中转平台,提供 OpenAI、Claude、Gemini 等模型接口的代理访问能力,适合解决国内网络访问、支付和接口统一管理等问题,常用于大模型应用开发、教学演示和测试环境。
LangChain 没有为 CloseAI 提供专用集成,只能通过 ChatOpenAI 兼容接口调用:
CLOSEAI_API_KEY=<YOUR_API_KEY>CLOSEAI_BASE_URL=https://api.openai-proxy.org/v1import osfrom langchain_openai import ChatOpenAIfrom dotenv import load_dotenv
load_dotenv(override=True)
CLOSEAI_API_KEY = os.getenv("CLOSEAI_API_KEY")CLOSEAI_BASE_URL = os.getenv("CLOSEAI_BASE_URL")
model = ChatOpenAI( # model="gpt-5-mini", model="deepseek-v4-flash", api_key=CLOSEAI_API_KEY, base_url=CLOSEAI_BASE_URL,)print(model.invoke("欧盟都有哪些国家"))init_chat_model 是 LangChain 1.x 推出的统一初始化接口:只要是 LangChain 支持的模型都能处理,它会根据模型标识自动选择对应的模型类。
 图:init_chat_model 的调用链路——统一初始化接口 → 选择模型组件 → 各厂商模型 → invoke() 统一调用
from langchain.chat_models import init_chat_model
model = init_chat_model( "provider:model_name", # 提供商:模型名称 api_key="your-api-key", # 可选,可从环境变量读取 temperature=0.7, max_tokens=1000, **kwargs # 其他模型特定参数)它和直接用 ChatDeepSeek / ChatOpenAI 有什么区别?
| 优势 | 说明 |
|---|---|
| 统一接口 | 不用记住每个提供商不同的初始化方式 |
| 易于切换 | 换模型只改一个模型字符串 |
| 简洁明了 | 语法更短,减少样板代码 |
| 自动适配 | 内部根据模型标识自动选择驱动类(ChatOpenAI、ChatDeepSeek…) |
用第三方兼容服务(自建网关、中转平台、OpenCode Go 等)时,关键是把地址和密钥传给正确的参数名:
import osfrom dotenv import load_dotenvfrom langchain.chat_models import init_chat_model
load_dotenv(override=True)
llm = init_chat_model( model="deepseek-v4.1-flash", model_provider="openai", # 走 OpenAI 兼容协议 base_url=os.getenv("OPENCODE_GO_BASE_URL"), # ← 正确:base_url api_key=os.getenv("OPENCODE_GO_API_KEY"), # ← 正确:api_key)
print(llm.invoke("用一句话解释 SOLID 原则。").content)别把变量名当成参数名写。写成 OPENCODE_GO_BASE_URL=...、OPENCODE_GO_API_KEY=... 时,LangChain 不会报”参数名错误”,而是把这两个多余参数塞进 model_kwargs(只给一条 UserWarning),最后抛 OpenAIError: Missing credentials——看起来像”密钥没读到”,实际上是参数名写错了。正确参数名永远是 base_url 和 api_key(ChatOpenAI 里也可以用别名 openai_api_base)。
问题 1:model_provider 支持哪些取值?
model_provider 表示模型的提供者。LangChain 1.2 内置注册的 provider(每个都对应一个集成包)有:
anthropic, anthropic_bedrock, azure_ai, azure_openai, bedrock, bedrock_converse,cohere, deepseek, fireworks, google_anthropic_vertex, google_genai, google_vertexai,groq, huggingface, ibm, mistralai, nvidia, ollama, openai, openrouter, perplexity,together, upstage, xai几个常用的对应关系:
| provider | 背后的集成包 / 底层类 |
|---|---|
openai | langchain-openai → ChatOpenAI |
deepseek | langchain-deepseek → ChatDeepSeek |
anthropic | langchain-anthropic → ChatAnthropic |
ollama | langchain-ollama → ChatOllama(本地模型,见后文) |
openrouter | langchain-openrouter → ChatOpenRouter |
也就是说:写 model_provider="deepseek",LangChain 会自动加载 langchain-deepseek 并用 ChatDeepSeek 初始化实例,效果和自己 new 一个 ChatDeepSeek 完全一致。
像阿里的 dashscope 尚未被 LangChain 官方纳入统一注册体系,没有这个 provider。此时就把 model_provider 设为 openai,底层按 OpenAI 规范处理请求——前提是你要调用的模型服务是 OpenAI Compatible 的。
问题 2:如果 model 参数里没指明提供者,就必须用 model_provider 指定吗?
不是。可以在 model 参数里用前缀 + 冒号的方式指定供应商,和 model_provider 参数等价:
# 下面两种写法等价init_chat_model(model="deepseek:deepseek-v4-flash")init_chat_model(model="deepseek-v4-flash", model_provider="deepseek")如果两个位置都没有指明供应商,LangChain 底层会按内置规则自动推断:
| 模型名前缀 | 推断出的 provider |
|---|---|
gpt-... / o1... / o3... | openai |
claude... | anthropic |
deepseek... | deepseek |
gemini... | google_vertexai |
amazon... | bedrock |
command... | cohere |
mistral... | mistralai |
grok... | xai |
sonar... | perplexity |
solar... | upstage |
accounts/fireworks... | fireworks |
并非所有模型都能自动推断出来。实测把 qwen-plus 直接丢给 init_chat_model 会报错:
ValueError: Unable to infer model provider for model='qwen-plus'. Please specify 'model_provider' directly.这时候必须显式写 model_provider="openai",再配上 base_url(百炼的 OpenAI 兼容地址)。
Model Class 和 init_chat_model 共用这套参数:
| 参数 | 类型 | 说明 | 默认值 |
|---|---|---|---|
model | str | 模型名称(必需),如 openai:gpt-4o | 无 |
model_provider | str | 模型提供商名称 | 无 |
api_key | str | API 密钥;不提供时从环境变量读取(如 DEEPSEEK_API_KEY) | None |
base_url | str | 大模型供应商 API 请求地址 | None |
temperature | float | 输出随机性,0.0–2.0,越高越随机 | 0.7 |
max_tokens | int | 限制输出最大 token 数 | None |
timeout | float | 超时时间(秒),超时请求被取消 | None |
max_retries | int | 请求失败(网络问题、速率限制)时的最大重试次数 | 6 |
| 区间 | 适合 |
|---|---|
| 0.0–0.3 | 需要一致性、准确性:数学计算、数据提取、分类、代码生成 |
| 0.5–0.7 | 平衡创造性和一致性:聊天、问答 |
| 0.8–1.5 | 创造性任务:写作、头脑风暴 |
| 1.5–2.0 | 高度创造性:诗歌、故事创作 |
 图:temperature 是”随机性控制器”、max_tokens 是”成本与长度控制器”(token 估算:英文 1 token ≈ 4 字符,中文 1 token ≈ 1–2 汉字)
官方文档和源码注释都没有给出完整的参数列表:以 ChatDeepSeek 为例,它的参数一部分由自己定义、一部分从父类 BaseChatModel 继承,只翻源码很难拼出完整清单。正确的姿势是看类属性 model_fields:
from langchain_deepseek import ChatDeepSeek
print(ChatDeepSeek.model_fields.keys())实测输出(LangChain 1.2.12,共 56 个):
dict_keys(['name', 'cache', 'verbose', 'callbacks', 'tags', 'metadata', 'custom_get_token_ids', 'rate_limiter', 'disable_streaming', 'output_version', 'profile', 'client', 'async_client', 'root_client', 'root_async_client', 'model_name', 'temperature', 'model_kwargs', 'openai_api_key', 'openai_api_base', 'openai_organization', 'openai_proxy', 'request_timeout', 'stream_usage', 'max_retries', 'presence_penalty', 'frequency_penalty', 'seed', 'logprobs', 'top_logprobs', 'logit_bias', 'streaming', 'n', 'top_p', 'max_tokens', 'reasoning_effort', 'reasoning', 'verbosity', 'tiktoken_model_name', 'default_headers', 'default_query', 'http_client', 'http_async_client', 'stop', 'extra_body', 'include_response_headers', 'disabled_params', 'context_management', 'include', 'service_tier', 'store', 'truncation', 'use_previous_response_id', 'use_responses_api', 'api_key', 'api_base'])ChatOpenAI 同理(54 个,比 ChatDeepSeek 少了 api_key、api_base 这类 DeepSeek 专有项):
from langchain_openai import ChatOpenAIprint(ChatOpenAI.model_fields.keys())用 init_chat_model 拿到的实例也一样能查——它本身就是某个具体的 ChatXxx 对象:
from langchain.chat_models import init_chat_modelfrom dotenv import load_dotenv
load_dotenv(override=True)
# 实例化一个你感兴趣的模型对象(即使不传具体 key,通常也能初始化成功)temp_model = init_chat_model(model="deepseek-v4-flash", model_provider="deepseek")
# 现在它已经是一个具体的 ChatDeepSeek 对象了print(temp_model.model_fields.keys()) # 输出与 ChatDeepSeek 完全一致想知道每个参数的类型、默认值、别名,遍历 model_fields 看字段属性即可:
from langchain_deepseek import ChatDeepSeek
for name, field in ChatDeepSeek.model_fields.items(): print(name) print(" annotation:", field.annotation) # 类型 print(" default:", field.default) # 默认值 print(" description:", getattr(field, "description", None)) print(" alias:", field.alias) print()输出片段(以首尾两个参数为例,中间省略):
name annotation: str | None default: None ...# ...参数太多,这里省略了...api_base annotation: <class 'str'> default: PydanticUndefined ...以 ChatDeepSeek 为例,这几十个参数可以分成四类,理解分类比死记参数名有用得多。
① 客户端与连接参数(Networking):决定代码”怎么连到服务端”,而不是”让模型怎么生成”。
| 参数名 | 说明 |
|---|---|
api_key / openai_api_key | 鉴权密钥(DeepSeek 兼容 OpenAI 接口格式,所以有 OpenAI 系别名) |
api_base / openai_api_base | 接口地址(如 https://api.deepseek.com ) |
request_timeout | 网络请求超时时间 |
max_retries | 请求失败时的重试次数 |
http_client / http_async_client | 手动传入 httpx.Client 实例(用于更复杂的网络配置) |
openai_proxy | 代理服务器配置 |
default_headers / default_query | 每次请求默认携带的 HTTP Header 或 Query 参数 |
② 模型推理参数(Model Inference):直接传给模型 API,决定生成内容的质量和风格。
| 参数名 | 说明 |
|---|---|
model_name | 指定具体的模型(如 deepseek-chat、deepseek-reasoner) |
temperature | 采样温度,越高越随机 |
top_p | 核采样参数 |
max_tokens | 最大输出 token 数 |
stop | 停止符列表 |
streaming | 是否开启流式传输 |
n | 生成几个候选回复 |
reasoning / reasoning_effort | 是否启用推理模式;(DeepSeek R1 特色) 控制思考链(COT)的深度 |
presence_penalty / frequency_penalty | 存在惩罚 / 频率惩罚,用于减少内容重复 |
store | 是否存储对话 |
logit_bias | 调整特定词汇出现的概率 |
③ LangChain 框架通用参数:由 BaseChatModel 定义,所有 ChatXxx 子类都具备,用于管理 LangChain 内部逻辑(日志、回调、元数据),仅在内部生效。
| 参数名 | 说明 |
|---|---|
name | 给模型实例起个名字,用于在 Trace(如 LangSmith)中区分 |
verbose | 是否打印详细日志 |
callbacks | 回调处理器,用于集成 LangSmith 或自定义监控 |
tags / metadata | 标记该实例的标签和元数据 |
cache | 是否缓存该模型的请求结果 |
rate_limiter | LangChain 内部的频率限制器 |
④ 高级与特定扩展参数:通常用于特定场景,或为了保持与 OpenAI 协议的兼容而存在。
client、async_client、root_client(内部生成的 SDK 实例,不建议初始化时手动传参)model_kwargs、extra_body(想传厂商 API 支持、但 LangChain 还没定义的参数时写在这里)disable_streaming、include_response_headers(决定是否在输出中包含 Header)openai_organization、service_tier、store(多为 OpenAI 遗留参数,DeepSeek 实际使用较少)model_kwargs 用于存放那些 OpenAI Compatible API 支持、但 LangChain 没有直接列出的字段,比如用于支持 Function Call 的 tools 字段。
查阅 OpenAI Chat Completions 文档可以看到官方支持的所有请求字段,其中就有 tools:
 图:OpenAI API 参考里的 tools 字段(ChatCompletionTool 数组)——它不在刚才打印的 model_fields 列表里,只能靠 model_kwargs 传
from langchain.chat_models import init_chat_modelfrom dotenv import load_dotenvfrom rich import print as rprint
load_dotenv(override=True)
model = init_chat_model( model="deepseek:deepseek-v4-flash", model_kwargs={"tools": [ { "type": "function", "function": { "name": "get_weather", "description": "Get weather of a location, the user should supply a location first.", "parameters": { "type": "object", "properties": { "location": { "type": "string", "description": "The city and state, e.g. San Francisco, CA", } }, "required": ["location"] }, } }, ]})
# 向模型发送单条数据response = model.invoke("你好,今天北京的天气如何")rprint(response)输出里出现了 tool_calls 字段,说明工具被模型正确识别了:
AIMessage( content='你好!让我帮你查一下北京今天的天气情况。', additional_kwargs={'refusal': None, 'reasoning_content': '用户想知道北京今天的天气情况。我需要使用get_weather工具…'}, response_metadata={..., 'finish_reason': 'tool_calls', ...}, tool_calls=[{'name': 'get_weather', 'args': {'location': '北京'}, 'id': 'call_00_BT3PTJVDQlb9C2uhhJkc4856', 'type': 'tool_call'}], invalid_tool_calls=[], usage_metadata={'input_tokens': 303, 'output_tokens': 78, 'total_tokens': 381, ...})这里只是为了演示 model_kwargs 的作用才直接传 tools。实际开发中要使用专门的工具调用接口,不采用这种原始方式(后面的 Tools 章节会讲)。
extra_body 用于存放模型厂商基于 OpenAI API 协议扩展的字段。查阅 OpenAI Chat Completions 文档和 DeepSeek 对话补全 API 文档可知,thinking 是 DeepSeek 扩展的字段,用于控制是否启用思考模式:
 图:DeepSeek「对话补全」API 文档里的 thinking 字段(type 可选 enabled / disabled)——这是 DeepSeek 在 OpenAI 协议之外自己扩展的
model = init_chat_model( model="deepseek:deepseek-v4-flash", extra_body={"thinking": {"type": "enabled"}}, # 换成 "disabled" 即可对比)
response = model.invoke("你好,一句话回答")rprint(response)输出里包含了 reasoning_content(思考过程),usage_metadata 里的 reasoning token 也变成非 0,说明启用了思考模式:
AIMessage( content='你好,请问有什么可以帮你的?', additional_kwargs={'refusal': None, 'reasoning_content': '好的,用户的问题很简单,就是要求"一句话回答"…'}, ... usage_metadata={'input_tokens': 8, 'output_tokens': 87, 'total_tokens': 95, ..., 'output_token_details': {'reasoning': 78}})把 extra_body 换成 {"thinking": {"type": "disabled"}} 再跑一次,输出里不包含 reasoning_content,说明没有启用思考模式。
记住常见参数及用法即可。如果需要精细控制模型输出,就查阅 OpenAI 和特定模型供应商的官方文档,通过 **model_kwargs(OpenAI 兼容字段)或 extra_body(厂商扩展字段)**把它们透传进去——这是应对”参数长尾”的标准解法,不用等 LangChain 逐个适配。
基本单位:大模型通过分词器(Tokenizer)把文本拆开,拆分后得到的最小语义单元就是 token(大致相当于自然语言里的”词”或”字”)。不同的模型采用不同的分词算法(如 BPE、WordPiece),所以同一段文本在不同模型里的 token 数量可能不同。
收费依据:大语言模型通常也是以 token 的数量作为计量(收费)依据,换算关系大致是:
| 语言 | 换算 |
|---|---|
| 中文 | 1 个 token ≈ 1–1.8 个汉字 |
| 英文 | 1 个 token ≈ 3–4 个字符 |
想知道一段文字到底被切成了哪些 token,可以用官方在线工具:
前面 max_tokens 限制的是”输出多少 token”,调用返回值里的 usage_metadata / response_metadata.token_usage 统计的也是 token——它既是长度单位,也是账单单位(返回值里的 token 字段详见「模型的调用」笔记)。
前面讲的都是”在线部署”的大模型(角度 3 的第一种)。LangChain 也支持使用 Ollama、vLLM 等框架启动的本地大模型,这里以 Ollama 为例演示。
Ollama 是 GitHub 上的一个开源项目,项目定位是:一个本地运行大模型的集成框架,可以实现 Qwen、DeepSeek 等主流大模型的下载、启动和本地运行的自动化部署及推理流程。
Ollama 官方地址:https://ollama.com
 图:LangChain 的模型供应商里既有 OpenAI、Azure OpenAI、千帆这样的云端平台,也有 Ollama 这样的本地框架——对上层代码而言它们用的是同一套接口
本地部署的取舍:数据不出本机、不花 API 费用、可离线使用;代价是受本机显存/内存限制,1.5B 这类小模型更适合演示和轻量任务,复杂推理还是得靠在线大模型。
Ollama 支持跨平台部署,目前已兼容 Mac、Linux 和 Windows,安装过程都设计得非常简单:访问 https://ollama.com/download 下载对应系统的安装文件。
 图:Ollama 官网下载页——macOS / Linux / Windows 三个平台任选(Windows 要求 Win10 及以上)
Linux 系统执行以下命令安装:
curl -fsSL https://ollama.com/install.sh | sh这行命令的目的是从 https://ollama.com/ 网站读取 install.sh 脚本,并立即通过 sh 执行该脚本。安装过程中会包含以下几个主要操作:
Windows 系统想自定义安装目录,可以这样做:
F:\common_tools\Ollama);cmd 回车,自动打开命令行窗口;语法:软件名称 /DIR=这里放你上面创建好的Ollama指定目录OllamaSetup.exe /DIR=F:\common_tools\Ollama 图:在资源管理器地址栏里直接输入 cmd,打开的就是当前目录的命令行(省得手敲 cd)
 图:先把 OllamaSetup.exe 放进刚建好的目标目录 F:\common_tools\Ollama
 图:执行 OllamaSetup.exe /DIR=F:\common_tools\Ollama,安装程序就会装到我们指定的目录
1、手动设置大模型存储目录(模型动辄几个 GB,别都堆在系统盘):
打开 Ollama 客户端 → Settings,在 Model location 里指明大模型要下载到的本地目录位置:
 图:Ollama 客户端左侧菜单里的 Settings 入口(New Chat 是对话,设置项在 Settings 里)
 图:Settings 里的 Model location 就是模型存放目录;上面还有 Cloud(云模型与联网搜索)、Auto-download updates、Expose Ollama to the network(把服务开放给局域网其他设备)
2、模型的下载
方式 1:直接在图形化界面里下载。在输入框旁的模型下拉列表里搜模型即可——注意区分两种图标:
 图:带云朵图标的是在线模型(kimi-k2.6
方式 2:命令行下载并运行。访问 https://ollama.com/search 可以查看 Ollama 支持的模型,例如运行 deepseek-r1:1.5b 模型:
ollama run deepseek-r1:1.5b 图:模型库页面(以 deepseek-r1:1.5b 为例)——名字里的 1.5b 是参数量,CLI 标签下给出的就是 ollama run 命令
 图:回到命令行输入指令开始下载(pulling manifest,进度条右侧还有速度和剩余时间)
 图:下载完成后自动进入交互对话,出现 >>> 提示符就能提问了
3、Ollama 常用命令
| 命令 | 一句话说明 |
|---|---|
ollama pull llama3 | 下载指定模型(例:llama3) |
ollama run llama3 | 启动并进入该模型交互对话 |
ollama list | 列出本机已下载的所有模型 |
ollama rm llama3 | 删除不再需要的模型以节省磁盘 |
ollama cp llama3 my-llama3 | 本地复制/重命名模型 |
ollama show llama3 | 查看模型详细信息(参数、大小等) |
ollama create my-model -f Modelfile | 用自定义 Modelfile 构建新模型 |
ollama serve | 启动后台服务,供 API 调用 |
ollama ps | 查看当前正在运行的模型进程 |
ollama stop llama3 | 停止正在运行的模型 |
ollama --version | 查看安装的 ollama 版本 |
先装依赖:
# pip install langchain-ollamapip install -qU langchain-ollamapip install -U ollama方式 1:ChatOllama
from langchain_ollama import ChatOllama
ollama_llm = ChatOllama( model="deepseek-r1:1.5b", # 如果Ollama在本地默认端口运行,则可省略;或使用 http://localhost:11434 base_url="http://192.168.1.106:11434",)question = "你好,请你介绍一下你自己。"result = ollama_llm.invoke(question)print(result)方式 2:init_chat_model(统一接口)
from langchain.chat_models import init_chat_model
ollama_llm = init_chat_model( model="deepseek-r1:1.5b", model_provider="ollama", # base_url="http://192.168.1.106:11434",)question = "你好,请你介绍一下你自己。"result = ollama_llm.invoke(question)print(result)返回值同样是 AIMessage,只是元数据换成了 Ollama 的格式(done_reason、total_duration、eval_count 等):
content='您好!我是由中国的深度求索(DeepSeek)公司开发的智能助手DeepSeek-R1。…'additional_kwargs={}response_metadata={'model': 'deepseek-r1:1.5b', 'created_at': '2026-05-17T13:45:51.8148967Z', 'done': True, 'done_reason': 'stop', 'total_duration': 658034000, 'load_duration': 53012900, 'prompt_eval_count': 9, 'prompt_eval_duration': 236815100, 'eval_count': 47, 'eval_duration': 338788200, 'logprobs': None, 'model_name': 'deepseek-r1:1.5b', 'model_provider': 'ollama'}id='lc_run--019e362f-9f34-7cc2-b34d-8fa380131978-0'tool_calls=[] invalid_tool_calls=[]usage_metadata={'input_tokens': 9, 'output_tokens': 47, 'total_tokens': 56}model_provider="ollama" 正是前面那份 provider 列表里的一员(对应 langchain-ollama),所以本地模型和在线模型可以用同一套代码切换——这也是统一接口的价值。
| 方式 | 写法 | 什么时候用 |
|---|---|---|
| 专用模型类 | ChatDeepSeek(...) | 用了该厂商,想用它的专有参数 |
| 兼容用法 | ChatOpenAI(base_url=..., model=...) | 平台没有专用类,或想”一套代码换平台” |
| 统一接口 | init_chat_model("provider:model") | 1.x 推荐:官方统一入口,切换模型最省事 |
 图:同一个 DeepSeek 模型在各平台可用的创建类——官网 ChatDeepSeek、百炼 ChatTongyi、OpenRouter ChatOpenRouter,CloseAI 这类中转平台只有 ChatOpenAI 和 init_chat_model 两条路
load_dotenv(override=True) 里 True 表示 .env 的值覆盖已有环境变量;.env 里不要加引号、必须加进 .gitignore;把密钥直接写进代码只适用于临时测试ChatDeepSeek 里 API 地址参数叫 api_base(不是 base_url);不传 api_key 时会自动从环境变量 DEEPSEEK_API_KEY 读取;模型名参数既接受 model 也接受 model_namelangchain-community 包里(还要装 pyjwt 依赖);千问专用类底层走的是专用 SDK(不是 OpenAI 兼容接口),所以不要添加 DASHSCOPE_BASE_URL 环境变量,否则会报连接被强制关闭的 ConnectionError(ConnectionResetError 10054)ChatOpenAI 集成;OpenRouter 有专用集成类 ChatOpenRouter,它的模型名要带厂商前缀(如 deepseek/…);CloseAI 没有专用集成,只能走 ChatOpenAI 或统一接口init_chat_model 的模型标识写法是 "provider:model_name",它和 model_provider 参数等价;两者都不写时按模型名前缀推断(claude... → anthropic、deepseek... → deepseek);qwen-plus 会抛 ValueError 错(Unable to infer model provider),必须显式指定 providertemperature 默认 0.7、取值范围 0.0–2.0(写代码/数据提取建议用 0.0–0.3 区间);max_tokens 限制的是输出的 token 数;timeout 单位是秒;max_retries 默认 6model_fields(ChatDeepSeek 有 56 个、ChatOpenAI 有 54 个,清单里还能看到模型能力画像字段 profile);参数分四大类:客户端与连接参数、模型推理参数、LangChain 框架通用参数、高级与特定扩展参数;把变量名当参数名写时,多余参数会被塞进 model_kwargs(只给一条 UserWarning 警告),最后抛 OpenAIError: Missing credentials 错tools)放 model_kwargs,厂商自己扩展的字段(如 DeepSeek 的 thinking)放 extra_body;Token 是模型用**分词器(Tokenizer)**切分出的最小语义单元,中文 1 token ≈ 1–1.8 个汉字、英文 1 token ≈ 3–4 个字符ollama pull 下载模型、ollama list 列出本机已有模型、ollama ps 查看正在运行的模型进程;LangChain 里用 ChatOllama 类调用,或用统一接口把 provider 设为 “ollama” 2-1 用厂商专用类创建 DeepSeek 模型
从 .env 读密钥,用 DeepSeek 的厂商专用类创建模型(模型名 deepseek-v4-flash):先显式传三个值跑一次,再不传密钥跑一次(看它能不能自己从环境变量里读到),最后换成它的另一个等价模型名参数再跑一次,每次打印回复文本。
一级 · 思路:先 load_dotenv,再用厂商类实例化,最后 invoke;本例的关键是记住这个类的地址参数名和 OpenAI 那套不一样
二级 · 方法:ChatDeepSeek(api_key=..., api_base=..., model=...),不传 api_key 时会读环境变量 DEEPSEEK_API_KEY
三级 · 骨架:llm = ChatDeepSeek(api_base=os.getenv("DEEPSEEK_BASE_URL"), model_name="deepseek-v4-flash")
2-2 用兼容方式创建(换平台只改两处) 挑一个 LangChain 没有提供专用类的平台(如 CloseAI),用兼容类创建模型并打印一次回复;再把它写成函数,演示”同一个模型在 DeepSeek 官方 / CloseAI / OpenRouter 之间切换”,只改密钥、地址和模型名三个值。
一级 · 思路:兼容写法只要 3 样东西——密钥、地址、模型名,代码结构完全不用动
二级 · 方法:ChatOpenAI(api_key=..., base_url=..., model=...)(可用别名 openai_api_base)
三级 · 骨架:def build_llm(key_env, url_env, model_name): return ChatOpenAI(...),OpenRouter 的模型名要带厂商前缀
2-3 用统一接口创建并切换
用统一接口创建 DeepSeek 模型,再写一个”只改模型字符串就能换模型”的函数;然后故意不指明提供商去初始化一个 qwen-plus,看报什么错、正确的写法是什么。
一级 · 思路:统一接口的意义是”换模型/换平台不改代码结构”;provider 可以写在参数里,也可以写成模型字符串的前缀
二级 · 方法:init_chat_model(model="provider:model_name", model_provider=..., base_url=..., api_key=...)
三级 · 骨架:两个位置都不写 provider 时 LangChain 会按前缀猜,猜不出来抛 ValueError;这时要显式写 model_provider="openai" 并配上百炼的兼容地址
2-4 透传框架没有定义的参数 ① 把一段”模型参数清单里查不到、但 OpenAI 兼容文档里有”的字段(函数调用用的工具列表)透传进去,问一句天气,打印返回里的工具调用和结束原因; ② 把 DeepSeek 自己扩展的”思考开关”透传进去,分别用启用/禁用各问一句,对比两次的思考内容和 reasoning token。
一级 · 思路:OpenAI 兼容字段和厂商扩展字段走的是两条不同的透传通道
二级 · 方法:model_kwargs={"tools": [...]};extra_body={"thinking": {"type": "enabled"}};想看思考内容要让它走 DeepSeek 自己的类
三级 · 骨架:init_chat_model(..., model_kwargs={...}) / init_chat_model(model="deepseek:deepseek-v4-flash", extra_body={...}),读 response.tool_calls、response.additional_kwargs、response.usage_metadata
3-1 模型自检小工具 写一个”创建前先自检、调用后能算账”的小工具:
1 + 1 = ?,打印回答;一级 · 思路:创建(统一接口)→ 自检(参数清单)→ 归类(四大分类)→ 透传(思考开关)→ 调用 → 算账(token)
二级 · 方法:type(llm).model_fields.keys() 拿清单;extra_body={"thinking": {...}} 控开关;resp.usage_metadata["output_tokens"] 算账单
三级 · 骨架:def ask(thinking): return model.invoke("1 + 1 = ?");两次结果对比 additional_kwargs.get("reasoning_content") 和 usage_metadata["output_token_details"]
import osfrom dotenv import load_dotenvfrom langchain.chat_models import init_chat_model
load_dotenv(override=True)
DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")DEEPSEEK_BASE_URL = os.getenv("DEEPSEEK_BASE_URL")
# ========== 2-1 厂商专用类 ==========from langchain_deepseek import ChatDeepSeek
# 写法 1:三个值都显式传(专用类的地址参数叫 api_base,不是 base_url)llm = ChatDeepSeek( api_key=DEEPSEEK_API_KEY, api_base=DEEPSEEK_BASE_URL, model="deepseek-v4-flash",)print("写法1 →", llm.invoke("请介绍一下你自己").content)
# 写法 2:api_key 不传,会自动读环境变量 DEEPSEEK_API_KEYllm2 = ChatDeepSeek( api_base=DEEPSEEK_BASE_URL, model="deepseek-v4-flash",)print("写法2 →", llm2.invoke("用一句话介绍下你自己").content)
# 模型名参数既接受 model,也接受 model_name(两者等价)llm3 = ChatDeepSeek( api_key=DEEPSEEK_API_KEY, api_base=DEEPSEEK_BASE_URL, model_name="deepseek-v4-flash",)print("model_name 别名 →", llm3.invoke("1 + 1 = ?").content)
# ========== 2-2 兼容方式(换平台只改两处) ==========from langchain_openai import ChatOpenAI
def build_compat(key_env: str, url_env: str, model_name: str): """一个兼容类打通所有 OpenAI 兼容平台:换平台只改 base_url 和 model""" return ChatOpenAI( api_key=os.getenv(key_env), base_url=os.getenv(url_env), # 兼容类用 base_url(别名 openai_api_base) model=model_name, )
# ① CloseAI:LangChain 没有给它专用类,只能走兼容接口closeai = build_compat("CLOSEAI_API_KEY", "CLOSEAI_BASE_URL", "deepseek-v4-flash")print("[CloseAI]", closeai.invoke("欧盟都有哪些国家").content)
# ② DeepSeek 官方:同一套代码,只换了「密钥变量 + 地址变量 + 模型名」deepseek = build_compat("DEEPSEEK_API_KEY", "DEEPSEEK_BASE_URL", "deepseek-v4-flash")print("[DeepSeek]", deepseek.invoke("1 + 1 = ?").content)
# ③ OpenRouter:模型名要带厂商前缀(也可以用它自己的专用集成,这里演示兼容写法)openrouter = build_compat("OPENROUTER_API_KEY", "OPENROUTER_API_BASE", "deepseek/deepseek-v4-flash")print("[OpenRouter]", openrouter.invoke("一句话介绍下你自己").content)
# ========== 2-3 统一接口 + 切换模型 ==========def build_llm(model_name: str, provider: str = "openai"): """只改模型字符串就换模型""" return init_chat_model( model=model_name, model_provider=provider, # 不写就按模型名前缀猜(猜不出来会报 ValueError) base_url=DEEPSEEK_BASE_URL, # 走 OpenAI 兼容协议时用 base_url api_key=DEEPSEEK_API_KEY, )
for name in ["deepseek-v4-flash", "deepseek-v4-pro"]: print(name, "→", build_llm(name).invoke("用一句话介绍你自己").content)
# 等价写法:把 provider 写在模型字符串里(前缀 + 冒号),效果和 model_provider 一样same = init_chat_model( model="deepseek:deepseek-v4-flash", api_key=DEEPSEEK_API_KEY, api_base=DEEPSEEK_BASE_URL, # provider 解析成 deepseek 后,它认的是自己的 api_base)print("model='deepseek:deepseek-v4-flash' →", same.invoke("1 + 1 = ?").content)
# 两个地方都不写 provider 时,LangChain 按前缀猜;猜不出来就是这种报错try: init_chat_model(model="qwen-plus")except ValueError as e: print("推断失败 →", e) # 正确姿势:显式 model_provider="openai" + 百炼的 OpenAI 兼容地址
# 本地部署的模型也是同一套代码,只换 provider# (本机没装 Ollama,这段只做语法核对;真跑之前要先 `ollama serve`)# local = init_chat_model(model="deepseek-r1:1.5b", model_provider="ollama",# base_url="http://localhost:11434")# print(local.invoke("你好").content)
# ========== 2-4 透传框架没有定义的参数 ==========# ① model_kwargs:OpenAI 兼容文档里有、但 LangChain 没有单列出来的字段(比如 tools)model_with_tools = init_chat_model( model="deepseek-v4-flash", model_provider="openai", base_url=DEEPSEEK_BASE_URL, api_key=DEEPSEEK_API_KEY, model_kwargs={ "tools": [ { "type": "function", "function": { "name": "get_weather", "description": "Get weather of a location, the user should supply a location first.", "parameters": { "type": "object", "properties": { "location": {"type": "string", "description": "The city and state"} }, "required": ["location"], }, }, } ] },)r = model_with_tools.invoke("你好,今天北京的天气如何")print("tool_calls:", r.tool_calls)print("finish_reason:", r.response_metadata.get("finish_reason")) # tool_calls# 注意:实际开发中要用专门的工具调用接口,这里只是演示 model_kwargs 的作用
# ② extra_body:厂商在 OpenAI 协议之外自己扩展的字段(DeepSeek 的 thinking)for mode in ("enabled", "disabled"): llm = init_chat_model( model="deepseek:deepseek-v4-flash", # 用 DeepSeek 自己的类,才看得到 reasoning_content api_key=DEEPSEEK_API_KEY, api_base=DEEPSEEK_BASE_URL, extra_body={"thinking": {"type": mode}}, ) resp = llm.invoke("你好,一句话回答") print(f"\nthinking={mode} 回答:{resp.content}") print(" reasoning_content:", repr(resp.additional_kwargs.get("reasoning_content"))) print(" reasoning tokens:", resp.usage_metadata.get("output_token_details"))# 观察:enabled 时有思考内容、reasoning token 非 0;disabled 时两样都没有
# ========== 3-1 综合:模型自检小工具 ==========# 第 1 步:创建模型(temperature 取「要一致性、准确性」那档:0.0–0.3)llm = init_chat_model( model="deepseek-v4-flash", model_provider="openai", base_url=DEEPSEEK_BASE_URL, api_key=DEEPSEEK_API_KEY, temperature=0.2,)
# 第 2 步:打印完整参数清单 + 总数(参数一部分自己定义、一部分继承自父类)params = list(type(llm).model_fields.keys())print("参数总数:", len(params), "(类名", type(llm).__name__ + ")")
# 第 3 步:从清单里按四大分类各挑几个(挑出来才说明这些名字确实存在)groups = { "① 连接类": ["openai_api_key", "openai_api_base", "request_timeout", "max_retries", "openai_proxy", "default_headers", "default_query", "http_client"], "② 推理类": ["model_name", "temperature", "max_tokens", "top_p", "stop", "n", "presence_penalty", "frequency_penalty", "reasoning_effort", "store"], "③ 框架通用": ["name", "verbose", "callbacks", "tags", "metadata", "cache", "rate_limiter", "custom_get_token_ids"], "④ 高级扩展": ["model_kwargs", "extra_body", "client", "async_client", "root_client", "service_tier", "disable_streaming", "include_response_headers"],}for label, names in groups.items(): print(label, "→", [n for n in names if n in params])# 提示:换成 ChatDeepSeek 会多出 api_key、api_base 两个自己的参数(56 vs 54)
# 第 4 步:透传「思考」开关,各调用一次def ask(thinking: str): m = init_chat_model( model="deepseek:deepseek-v4-flash", api_key=DEEPSEEK_API_KEY, api_base=DEEPSEEK_BASE_URL, extra_body={"thinking": {"type": thinking}}, ) return m.invoke("1 + 1 = ?")
r_on = ask("enabled")r_off = ask("disabled")
# 第 5 步:回答 + 账单(token 既是长度单位也是账单单位)usage = r_on.usage_metadataprint("\n回答:", r_on.content)print(f"输入 / 输出 / 总计 token: {usage['input_tokens']} / {usage['output_tokens']} / {usage['total_tokens']}")print("按「中文 1 token ≈ 1–1.8 个汉字」估算,输出的 {} 个 token 大约对应 {}–{} 个汉字".format( usage["output_tokens"], usage["output_tokens"], round(usage["output_tokens"] * 1.8)))
# 第 6 步:对比两次的思考开销print("\n思考内容(enabled):", (r_on.additional_kwargs.get("reasoning_content") or "无")[:40])print("思考内容(disabled):", r_off.additional_kwargs.get("reasoning_content") or "无")print("reasoning token:enabled =", r_on.usage_metadata.get("output_token_details"), "|disabled =", r_off.usage_metadata.get("output_token_details"))如果你喜欢,那么欢迎来到我的世界!
了解更多暂未播放