国庆节10月1日
--

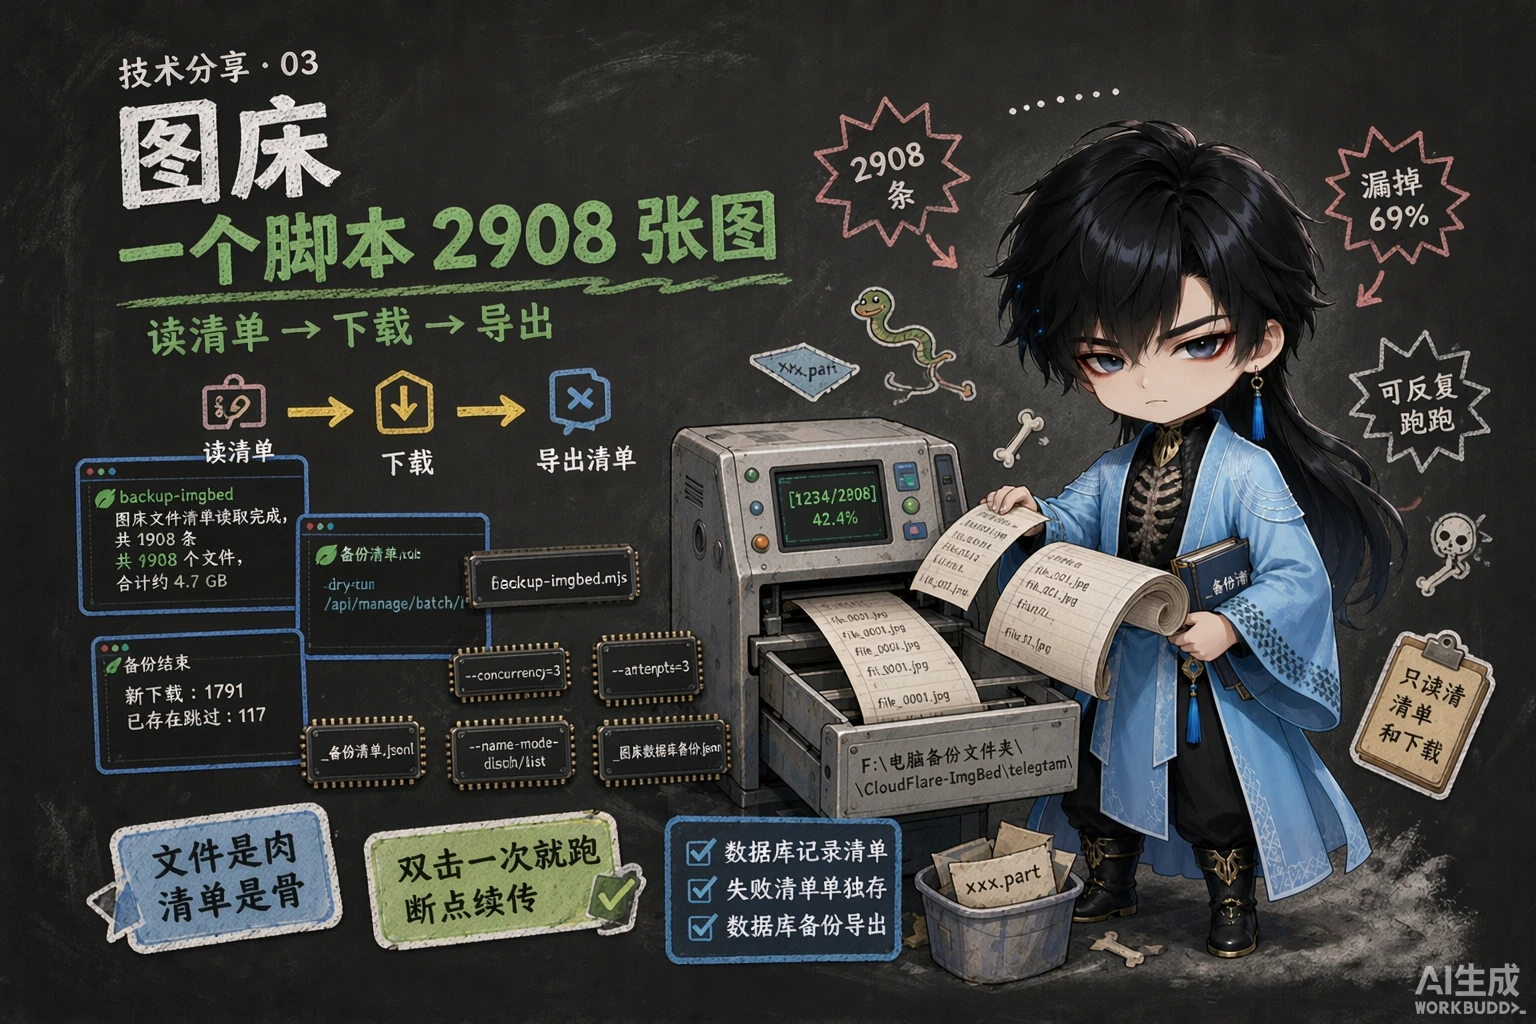
图床图片全存在 Telegram,早晚要落到自己硬盘上才安心。这篇介绍我写的本地备份脚本:双击一次,把图床里的文件按原有目录树和文件名全量下载到本地,带清单、能续传、可反复跑。含完整参数表和我踩过的坑。
图床系列配套篇。之前的 WebDAV + WinSCP 方案 是”零代码”路线,这篇是”一键全自动”路线,两篇可以一起看。
我的图床(CloudFlare-ImgBed)把文件全存在 Telegram 频道里,图床本身只保存一份”记录”——文件名、所在文件夹、Telegram 的文件 ID。也就是说:
只要 Telegram 频道被封、账号出问题,文件实体就没了;而数据库里的记录也就变成一堆指向空气的索引。所以备份必须两样都存:文件本体 + 记录清单。
WebDAV + WinSCP 那套能解决大部分场景,但用久了有几个别扭的地方:
| WebDAV + WinSCP | 本地备份脚本 | |
|---|---|---|
| 文件名 | 图床内部 ID(1755000000000_xxx.png) | 图床里显示的文件名(xxx.png) |
| 被设为”屏蔽/白名单”的文件 | 取不到 | 带管理员身份取,全都能拿 |
| 断点续传 | 靠 WinSCP 自己判断 | 有清单记录,精确跳过已备份的 |
| 失败文件 | 混在同步日志里 | 单独一份失败清单,写明原因 |
| 记录清单 | 没有 | 额外导出一份数据库记录 JSON |
| 需要开图床的 WebDAV 开关 | 需要(该接口能上传/删除,是个风险面) | 不需要,纯只读 |
所以我写了这个脚本:双击一次,把图床里的文件按原有目录树和文件名全量拉到本地硬盘。
文件夹\文件名 存到本地,目录结构和文件名与图床完全一致它不会做这些:不删除、不重命名、不移动图床里的任何东西,也不改图床设置。全程只有”读清单”和”下载”两个动作。
node -v 能出版本号就行脚本本身是零依赖的单文件,不需要 npm install。
我把它和备份数据放在同一个文件夹,这样备份盘自己就是完整的(脚本 + 数据 + 清单):
F:\电脑备份文件夹\CloudFlare-ImgBed\telegram\ backup-imgbed.bat ← 双击这个 backup-imgbed.mjs ← 主脚本 backup-config.json ← 配置(记住域名/用户名/备份目录,不含密码) backup-config.example.json 备份说明.md ← 随脚本附带的简版说明 blog\ music\ ... ← 备份出来的文件(与图床目录一致) _备份清单.jsonl _备份汇总.json _备份失败.txt _图床数据库备份.json双击 backup-imgbed.bat,依次回答:
想只备份某个目录吗?可以输入目录名,例如 涂装项目 (直接回车 = 备份全部文件): ← 回车管理员用户名(直接回车使用 admin): ← 回车(或填你的用户名)管理员密码: ← 输入密码(不显示字符,正常)第一次运行会问域名和备份目录,之后会记住(不含密码),下次直接回车即可。
下载开始前,它会先告诉你这次要处理多少文件:
图床文件清单读取完成,共 2908 条(来自数据库记录)共 2908 个文件,合计约 4.7 GB(按上传时大小估算)预计耗时约 6 分 27 秒(粗略估计,取决于网络与图床负载)觉得不合适可以当场 Ctrl+C,什么都不会写坏。想只看规模不下载,加 --dry-run。
[1234/2908] 42.4% 成功 1231 跳过 3 失败 0 480.2 MB 已用 2 分 41 秒 剩余约 3 分 38 秒 blog/article/p069_2.webp剩余时间按”已用时间 ÷ 已完成数量”实时推算,跑一会儿就准了。
==================== 备份结束 ====================文件总数 : 2908 新下载 : 1791 已存在跳过 : 1117 失败 : 0数据总量 : 4.70 GB耗时 : 12 分 4 秒备份目录 : F:\电脑备份文件夹\CloudFlare-ImgBed\telegram文件清单 : _备份清单.jsonl数据库备份 : _图床数据库备份.json(2908 条记录、4 项设置)==================================================有失败文件时,最后会多一行提示,并生成 _备份失败.txt。
F:\电脑备份文件夹\CloudFlare-ImgBed\telegram\ blog\article\p069_2.webp ← 和链接 /file/blog/article/p069_2.webp 一一对应 blog\album\武侠风\11.webp music\... 待上传\...路径规则:图床里的文件夹 + 列表里显示的文件名。所以你在图床后台看到什么名字,备份下来就是什么名字。
| 文件 | 内容 | 用途 |
|---|---|---|
_备份清单.jsonl | 每个文件一行:内部路径、文件名、目录、本地路径、字节数、TG 文件 ID、上传时间、下载结果 | 断点续传的依据;查某个文件对应的 TG 文件 ID |
_备份汇总.json | 本次运行统计:总数/新下载/跳过/失败、总量、耗时、失败明细 | 快速回顾 |
_备份失败.txt | 没下成功的文件及原因 | 排错 |
_图床数据库备份.json | 图床全部记录的元数据 + 系统设置(data.files / data.settings) | 即使文件副本丢失,也能知道每个文件原来叫什么、在哪个目录、TG 文件 ID 是什么 |
_备份清单.jsonl 的字段(排查问题时常用):
{ "id": "blog/article/p069_2.webp", "fileName": "p069_2.webp", "directory": "blog/article/", "localPath": "blog/article/p069_2.webp", "bytes": 24040, "uploadedSizeBytes": 24040, "fileType": "image/webp", "channel": "TelegramNew", "tgFileId": "AgACAgUAAyEGAATr1aaP...", "status": "ok", "note": "文件名含 Windows 不允许的字符,已自动替换"}status 有三种:ok(本次下载)、skipped(已存在跳过)、failed(失败)。
命令行运行(在脚本所在目录打开终端):
node backup-imgbed.mjs --dry-run| 参数 | 默认值 | 说明 |
|---|---|---|
--base-url=<地址> | 配置文件里的值 | 图床地址,如 https://img.tsh520.cn |
--out=<目录> | 配置文件里的值 | 备份保存位置 |
--user=<用户名> | admin | 管理员用户名 |
--pass=<密码> | 空(运行时输入) | 管理员密码 |
--token=<Token> | 空 | 用 API Token 代替账号密码(权限需含 list 和 manage) |
--dir=<目录> | 空(全部) | 只备份某个目录及其子目录 |
--name-mode=display | display | 文件名规则:display=图床显示的名字,id=内部路径(与 WebDAV 一致) |
--concurrency=<数量> | 3 | 同时下载的文件数 |
--timeout=<秒> | 300 | 单个文件的下载超时 |
--attempts=<次数> | 3 | 单个文件最多尝试几次(退避 1/3/8 秒) |
--channel=<渠道> | 空 | 只备份指定渠道,如 TelegramNew,Telegram |
--max-files=<数量> | 0(不限) | 只处理前 N 个,用于试跑 |
--dry-run | 关 | 只统计数量和体积,不下载 |
--checksum | 关 | 额外记录每个文件的 sha256(慢,但便于日后校验) |
--no-db-backup | 关 | 不导出 _图床数据库备份.json |
--verbose | 关 | 每个文件都打印一行(默认只在结束时打印统计) |
--no-save-config | 关 | 本次运行不把设置写回配置文件 |
--config=<路径> | backup-config.json | 指定配置文件 |
--self-test | — | 运行内置自检(30 项),不联网 |
--help | — | 显示帮助 |
也可以用环境变量:IMGBED_BASE_URL、IMGBED_USER、IMGBED_PASS、IMGBED_TOKEN、IMGBED_OUT。
backup-config.json(交互运行时自动生成,不写密码):
{ "baseUrl": "https://img.tsh520.cn", "username": "tianshihao2003", "password": "", "token": "", "outDir": "F:\\电脑备份文件夹\\CloudFlare-ImgBed\\telegram", "nameMode": "display", "concurrency": 3, "dir": "", "channel": "", "checksum": false}dir 为空 = 备份全部;填了目录名 = 只备份该目录。改这个文件即可调整默认行为。
脚本只调用两个接口:
GET /api/manage/batch/list —— 读数据库里的文件记录(清单来源)GET /file/<路径> —— 下载文件本体不调用任何删除、重命名、移动接口,也不修改图床设置。跑一百次也不会把图床搞乱。
每个文件先按普通访客身份请求(能命中 Cloudflare 缓存,更快);如果返回”访问受限”(文件被设为屏蔽、或图床开了白名单模式),自动改用管理员身份重新请求。所以被屏蔽的文件也能备份下来。
一个文件被跳过,需要同时满足:
_备份清单.jsonl 里上次记录的状态是成功/跳过只要有一条不满足就会重新下载并覆盖。所以:
每个文件先写成 xxx.part,下载完整(字节数与服务器声明一致)才改名为正式文件。断网、关机、Ctrl+C 都不会留下损坏的文件。失败时 .part 会被清理。
运行中按行追加(保证中断也不丢进度),跑完会按记录去重重写一遍,永远保持”一个文件一行”。
<>:"/\|?*)自动替换为 _CON、PRN 等保留名自动加前缀\\?\ 前缀(Windows 长路径)这是最坑的一个。图床后台的文件列表、搜索、目录树都依赖一个叫”索引”的东西,而索引可能只覆盖一部分文件。我的图床当时索引里只有 877 条记录,数据库里却有 2908 条——差了 2000 多个文件。
如果按索引备份,会静默漏掉 69% 的文件,而且看不出任何异常:清单读取成功、下载成功、汇总显示”全部完成”。
所以脚本现在直接读数据库记录(/api/manage/batch/list,也就是管理端”备份数据”按钮用的那个接口)。运行时你会看到:
图床文件清单读取完成,共 2908 条(来自数据库记录)万一数据库接口读不到,会退回索引,并明确警告:
注意:这次用的是图床索引,而图床索引可能不完整(会漏掉文件)。建议先到图床管理端执行一次「重建索引」,然后再跑备份。建议:顺手在图床管理端点一次「重建索引」,否则网页端管理文件时也会漏(列表、搜索、目录树都会少文件)。
脚本会把这次的选择写进配置,下次作为默认值。好处是不用每次重输;坏处是输错了也会被记住,下次直接回车就只备份那个目录。
现在的处理:清单读取成功后才保存设置;如果那个目录下没找到任何文件,会明确提示并且不保存:
目录「xxx」下没有找到任何文件。目录名要和图床里的文件夹名完全一致(区分大小写),比如 涂装项目;不确定就先直接回车备份全部。本次不会保存设置,避免把输错的目录名记下来。想改回备份全部:运行时在提示后输入一个 -,或把配置里的 dir 改成 ""。
图床上传时,图片走的是 Telegram 的”发送图片”接口,会被 Telegram 压缩一次。所以备份下来的就是图床现在能提供的内容(和你从图片链接下载到的完全一样),已经被压掉的原始画质找不回来。
想保留原图,上传时要走”文件”方式(?serverCompress=false),这样 Telegram 会原样保存。
大文件(超过 16 MB)图床会切成 16 MB 分片存储,下载时图床自动拼回,不受 Telegram 机器人 20 MB 下载限制的影响。
/file/ 接口会把逗号当目录分隔符,无法定位,会直接记进失败清单(不会写错文件)这两类都会出现在 _备份失败.txt 里并写明原因,不会静默跳过。
图床里同一个文件夹下可能有两条记录显示名相同(比如两个 小柠檬2.0.9.apk)。脚本会把其中一个自动改用内部路径名(带时间戳那种),避免互相覆盖,并在清单的 note 里注明。
--out 指向的目录会被写入文件,如果恰好是图床的同步目录可能造成循环。放在独立的备份盘即可。
Q:会重复下载已经备份过的文件吗? 不会。判定规则见第六节第 3 条,正常重跑只补新增和变化的。
Q:中途中断了怎么办? 直接重新运行,会接着下。已下好的跳过。
Q:怎么只备份某个目录?
运行到”想只备份某个目录吗”时输入目录名(如 涂装项目),或命令行加 --dir=涂装项目。
Q:怎么先看看有多少文件、多大?
node backup-imgbed.mjs --dry-run。
Q:提示”管理员用户名或密码不正确”?
用户名填错最常见。如果图床登录时只需要密码、不需要用户名,用户名保持 admin 直接回车即可;如果登录页要输用户名,就填那个。也可以用 --user=你的用户名 指定。
Q:跑一次要多久? 取决于文件数量和体积。我的图床 2908 个文件、约 4.7 GB,首次全量十几分钟;之后增量只补新增,通常几十秒。
Q:Cloudflare 请求数够用吗? 每个文件算一次请求。免费版每天 10 万次请求,几千个文件随便跑。
Q:脚本升级后要重新下载吗? 不需要。清单文件是兼容的,升级后重跑会接着用已有的记录。
Q:备份能校验完整性吗?
加 --checksum 会额外记录每个文件的 sha256(图床不存哈希,所以只能本机自证,用于日后核对本地文件有没有被改动)。日常不必要,慢。
F:\电脑备份文件夹\CloudFlare-ImgBed\telegram\,文件都还在_图床数据库备份.json 或 _备份清单.jsonl,里面有每个文件原来的路径、文件名、上传时间,可以对照恢复/file/blog/article/p069_2.webp)如果路径保持一致,重新上传后就能直接访问,不用改文章这就是为什么要连”记录清单”一起备份:文件是肉,清单是骨,缺一个都恢复不出原来的样子。
| 日期 | 版本 | 变更 |
|---|---|---|
| 2026-09-19 | v1.0.0 | 首个版本:数据库记录清单、断点续传、失败清单、数据库备份导出、目录筛选、内置自检(30 项) |
📌 本文与脚本同步维护:脚本(
backup-imgbed.mjs)新增功能或修改行为时,本文的「参数表」「工作原理」「踩坑」「更新记录」几节需要同步更新。
备份这件事,做了不一定马上有用,不做一定会后悔。这个脚本做的事情很朴素:把图床里的文件,按原来的样子,搬到自己的硬盘上,并且保证下次还能接着搬。
配着 WebDAV + WinSCP 方案 一起用更稳:一个负责”按图床显示的名字全量落盘”,一个负责”每周自动增量同步”,两份互不干扰,任意一份都能独立恢复。
如果你喜欢,那么欢迎来到我的世界!
了解更多暂未播放